Functionalizer:无损分解子词分词的新框架
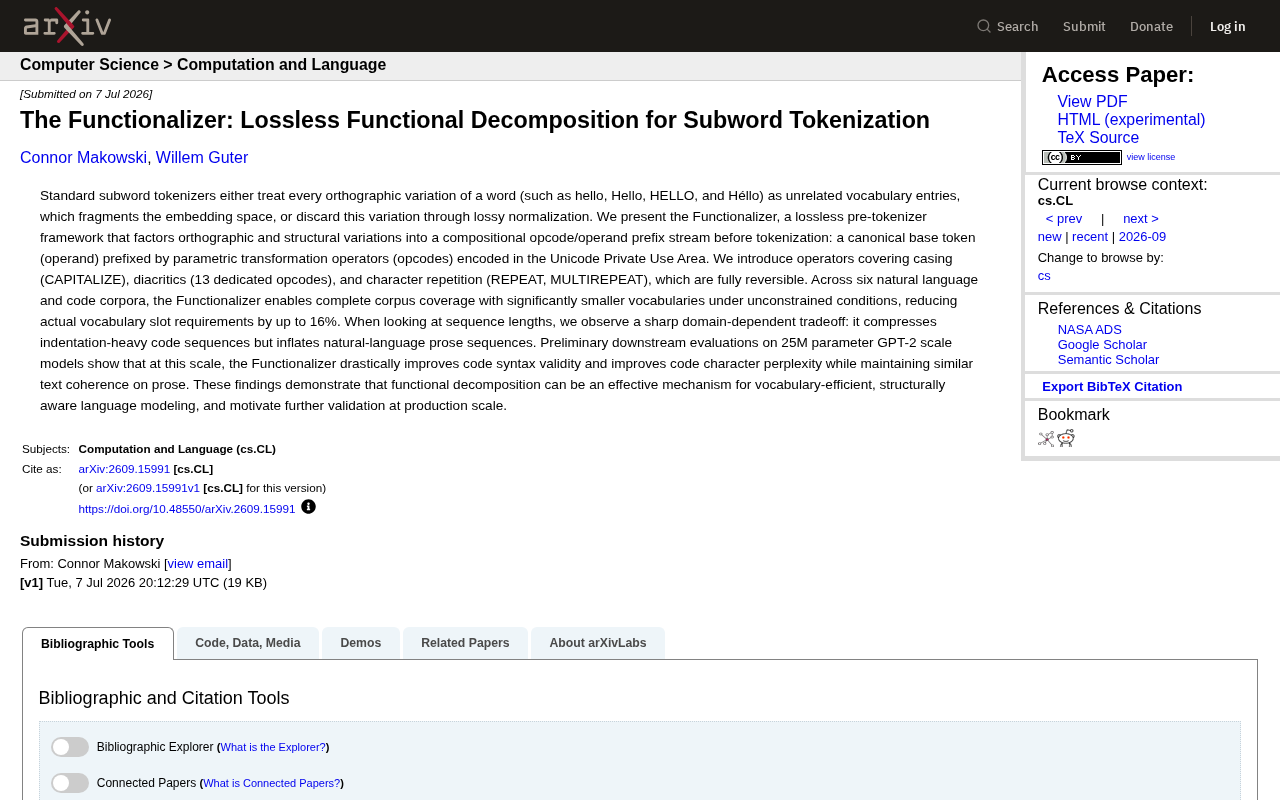
Functionalizer 用操作码+操作数结构无损分解词形变体,最多减少16%词表槽位,对代码任务效果尤佳。
Functionalizer 是一种针对子词分词器词表碎片化问题的无损预分词框架。传统 BPE/WordPiece 分词器会把同一单词的大小写、变音符号等不同书写形式视为独立词条,既浪费词表空间,又割裂嵌入语义。Functionalizer 借鉴计算机指令结构,将词形变体分解为「变换算子(opcode)+ 规范基础词元(operand)」,算子编码于 Unicode 私有使用区,变换完全可逆。实验覆盖六个语料库,词表槽位需求最多降低 16%;在代码序列上能压缩长度,但自然语言散文序列反而变长。在 25M 参数 GPT-2 规模模型的下游评估中,代码语法有效性显著提升,散文连贯性基本持平。该方法目前仍处于初步验证阶段,生产级规模的有效性尚待确认。
分词器的老问题:正字法变体撑爆词表
主流的子词分词器(如 BPE、WordPiece)在处理同一个单词的不同书写形式时存在明显缺陷。比如 hello、Hello、HELLO 和 Héllo 这几种写法,在标准分词器眼里往往被当作彼此毫不相关的独立词表条目。这直接导致两个问题:一方面是嵌入空间被人为割裂,本该共享语义的词形被分散到不同的向量表示上;另一方面,如果采用有损归一化(lossy normalization)把大小写、变音符号统一抹平,又会丢失原始文本中携带的信息。
arXiv 上一篇题为《The Functionalizer: Lossless Functional Decomposition for Subword Tokenization》的新论文(arXiv:2609.15991v1)正是针对这一痛点,提出了一套无损的预分词框架。
BPE(Byte Pair Encoding)和 WordPiece 是当前主流大语言模型(如 GPT 系列、BERT)所采用的子词分词算法。BPE 的原理是从字符级别出发,反复合并语料中出现频率最高的相邻符号对,直到词表规模达到预设上限;WordPiece 则以最大化语言模型似然为目标来决定合并策略。两者都能将未登录词拆解为已知子词片段,从而在词表大小与序列长度之间取得平衡。然而,这类算法的合并规则完全由统计频率驱动,对语言学结构毫无感知——hello 和 Hello 在字节层面不同,会被视为两个独立的合并起点,最终占用各自的词表槽位。当词表规模固定(通常为 3 万至 10 万条目)时,这种冗余会直接挤压模型学习真正有意义的语义单元的空间。
Functionalizer 的核心思路:操作码 + 操作数
Functionalizer 的设计理念借鉴了计算机指令的结构——把一个词拆解为「操作码(opcode)」和「操作数(operand)」的组合。具体做法是:在真正进入分词流程之前,先把正字法和结构上的变化因子化,转化为一段由参数化变换算子构成的前缀流。
其中,规范化的基础词元充当操作数(operand),而描述如何变换它的算子(opcode)则以前缀形式附加在前面,并被编码到 Unicode 的私有使用区(Private Use Area)中。这样一来,Hello 就可以表示为「首字母大写算子 + hello」,HELLO 表示为「全大写算子 + hello」,几种变体共享同一个基础词元 hello,从而避免了词表膨胀。
论文引入了三类可完全逆转(fully reversible)的算子:
- 大小写变换:如
CAPITALIZE - 变音符号:专门设计了 13 个 opcode 覆盖各类 diacritics
- 字符重复:
REPEAT与MULTIREPEAT,用于处理如sooo这类重复字符
关键在于「无损」——所有变换都是可逆的,能够精确还原原始文本,不会像归一化那样丢弃信息。
Unicode 私有使用区(Private Use Area,PUA)是 Unicode 标准中专门保留给应用程序自定义使用的码位区段,官方不为其分配任何字符含义。主要有三个区段:基本多文种平面中的 U+E000–U+F8FF(6400 个码位)、以及补充私用区 A 和 B,合计提供逾 13 万个可自由分配的码位。Functionalizer 选择将变换算子编码在此处,是一个工程上的巧妙决策:这些码位不会与任何自然语言字符发生冲突,因此在文本流中出现时可被明确识别为"控制信号"而非内容字符,同时又能无缝嵌入标准 Unicode 字符串,无需修改底层的字节编码基础设施。分词器只需在预处理阶段识别并特殊处理这些码位即可,对后续的 BPE/WordPiece 流程侵入性极低。
实验结果:词表更小,但代价因领域而异
研究团队在六个语料库上做了测试,涵盖自然语言和代码两类文本。结果呈现出几个鲜明特点。
词表利用率显著提升
在无约束条件下,Functionalizer 能够以明显更小的词表实现对语料的完整覆盖,实际所需的词表槽位最多减少了 16%。这印证了功能分解在词表效率上的价值。
序列长度的领域权衡
不过在序列长度上,出现了一个明显的领域依赖性权衡(domain-dependent tradeoff):对于缩进密集的代码序列,Functionalizer 能够起到压缩作用;但对于自然语言散文,反而会让序列变长(inflate)。这意味着该方法并非「万金油」,其收益高度取决于应用场景。
序列长度在 Transformer 类模型中是一个牵一发而动全身的指标。自注意力机制的计算复杂度与序列长度的平方成正比,因此序列变长会直接推高训练和推理的计算成本,并压缩模型在固定上下文窗口内能处理的实际信息量。Functionalizer 在自然语言上造成序列膨胀的根本原因在于:原本被合并为单一词表条目的大写或带变音符号词形,现在需要拆分为「算子 token + 基础词元」两个 token,数量增加了。对于变体词形密度较低的语料(如正式英文散文),额外算子的开销抵消不了词表复用带来的节省;而代码文本中大量重复的缩进空白、括号嵌套等结构性重复,恰好是 REPEAT/MULTIREPEAT 算子能够高效压缩的目标,因此在代码域反而呈现净压缩效果。
下游任务:代码任务收益明显
研究者还在 2500 万参数、GPT-2 规模的模型上做了初步的下游评估。在这一规模下,Functionalizer 表现出以下效果:
- 代码语法有效性大幅提升:生成代码的语法正确率明显改善
- 代码字符困惑度(character perplexity)改善
- 散文文本连贯性基本持平:在自然语言上没有明显退步
这组结果说明,功能分解对于结构性强、格式敏感的代码文本尤其有效,而在自然语言上则以「不损害」为主。
意义与展望
Functionalizer 的核心贡献在于证明了:功能分解(functional decomposition)可以成为一种兼顾词表效率与结构感知的语言建模机制。通过把正字法变体从「独立词条」重构为「基础词元 + 变换算子」的组合,它既保留了信息的无损性,又缓解了嵌入空间碎片化的问题。
当然,这项工作目前仍停留在初步验证阶段。25M 参数的模型规模较小,论文明确指出需要在生产级规模上做进一步验证,才能确认这些结论是否依然成立。序列长度在自然语言上的膨胀也是一个需要权衡的现实问题。
对于关注分词技术和模型效率的研究者而言,Functionalizer 提供了一个值得关注的新方向:与其在归一化的「有损」和保留全部变体的「膨胀」之间二选一,不如尝试用结构化的方式把变化因子显式地表达出来。
相关推荐
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。
从零打造AI代理电商:用多智能体构建按需印花业务实录
海外博主用AI编程工具从零构建按需印花电商公司Keepsake Threads的实战记录:如何配置专业化Agent、用GPT-5.6与Claude Fable多模型编排突破架构阻塞,并沉淀可复用技能。真实展示AI代理创业的方法论与局限。