个性化数据分析如何揭示每日情绪健康

研究利用个性化数据分析揭示情绪健康每日波动,强调通用模型局限与个人中心方法的价值。
该研究项目“通过个性化数据分析探索每日情绪健康”属于数据科学领域,采用应用型探索方法,旨在从个人视角理解情绪健康随时间和个体差异的变化。项目整合多源个人数据(情绪记录、行为日志、情境信息)构建每日数据集,处理数据对齐、缺失值和时间粒度问题,并引入人格与幸福感问卷作为稳定参考。基于此,研究者开发了简单的个性化推荐方法,通过比较用户内部相似日子探索情境与情绪的关联。机器学习评估表明,每日情境信息包含区分个人常态的信号,但通用模型价值有限,个性化建模能更好捕捉个体内与个体间变异。核心结论是情绪健康高度个人化且每日波动,未来健康工具需转向以个人为中心的适应性分析,而非“一刀切”模型。
情绪健康并非一成不变,而是随着日常生活的起伏而波动。一项名为“通过个性化数据分析探索每日情绪健康”的研究项目,尝试从个人视角出发,结合情绪状态记录和日常情境信息,理解情绪健康如何随时间和个体差异而变化。该工作属于数据科学领域,聚焦于个体层面的情绪状态分析,采用应用型探索方法,旨在发现模式而非构建完整的预测系统。
构建整合的每日数据集
项目的核心挑战之一是将来自多个个人数据源的信息整合成统一的每日数据集。这些数据源可能包括情绪状态记录、日常行为日志以及情境信息。研究者需要处理数据对齐、缺失值和时间粒度等问题。通过整合,团队得以观察情绪变量的分布、随时间演化的趋势,以及不同用户之间的差异,同时分析这些变量在时间上的变异性。
为了更准确地解读每日情绪结果,项目还引入了人格问卷和幸福感问卷作为稳定参考。这些问卷提供了个体较为持久的特质和基线幸福感水平,帮助区分日常波动与长期倾向。这种将稳定特质与动态状态结合的设计,是个性化分析的重要基础。
数据对齐与时间粒度在整合多源个人数据时,常需将不同频率采集的数据(如每日一次的情绪评分、每小时一次的行为记录)统一到同一时间粒度(如“天”)。常见做法是对高频数据按天聚合(如取均值、总和或最大值),或对低频数据做插值。数据对齐则指确保不同来源的记录在时间戳上匹配,避免因采集时间不一致导致错误关联。缺失值处理需谨慎:直接删除可能损失信息,简单填充可能引入偏差,需结合具体情境选择策略(如多重插补或基于模型的填补)。这些预处理步骤直接影响后续分析的可靠性。
个性化推荐:寻找相似的日子
在整合数据的基础上,研究者开发了一种简单的个性化推荐方法。该方法通过在每个用户内部比较相似的日子,探索过去的上下文条件与用户情绪状态差异之间的关联。例如,如果某个用户在某些特定条件下(如睡眠时长、社交活动、工作压力等)情绪较好,那么系统可以识别出类似的日子,并给出基于个人历史的建议。
这种方法强调“相似性”而非通用规则。因为情绪健康高度个人化,通用的模型往往难以捕捉个体特有的模式。通过将分析限定在单个用户内部,推荐能够更贴合个人的实际情况。
相似性度量是判断两个“日子”是否相似的核心。常用方法包括欧氏距离、余弦相似度或基于特征权重的加权距离。在个性化场景中,需根据用户关注的情境维度(如睡眠、社交)调整权重,使相似性更贴合个人实际。此外,可采用动态时间规整(DTW)处理时间序列的相位偏移,或使用基于树的相似性学习。相似性度量的选择直接影响推荐质量,需通过交叉验证或用户反馈进行调优。
机器学习评估情境信号
项目进一步使用机器学习技术,评估每日情境信息是否包含有助于区分不同“日子类型”的信号——这里的日子类型是相对于个人通常的幸福感水平而言的。换句话说,研究者想知道:日常的情境数据能否帮助判断某一天是否偏离了该用户的常态?
结果表明,通用模型的价值有限,而个性化方法能更好地捕捉这些差异。这凸显了在情绪健康分析中,针对每个人自身情况进行建模的重要性。机器学习在这里不是用来构建预测黑箱,而是作为探索工具,验证情境信号的有效性。
个体内与个体间变异是情绪分析中的关键区分。个体内变异指同一用户在不同时间点的情绪波动,个体间变异指不同用户之间的基线差异。通用模型通常混合两者建模,容易忽略个体内模式。个性化方法则先对每个用户单独建模,或引入用户ID作为随机效应,从而分离两种变异。评估时需采用留一法或按用户划分训练测试集,避免数据泄漏。这种区分有助于理解情绪健康的动态本质,并为个性化干预提供依据。
主要发现与启示
研究得出的核心结论是:情绪健康非常个人化,并且每天都在变化。通用模型难以有效捕捉这种个体内和个体间的变异,而个性化方法能够显著提升对差异的捕捉能力。这一发现对健康科技应用具有启示意义:未来的情绪健康工具可能需要放弃“一刀切”的模型,转而采用以个人为中心的适应性分析。
项目也承认其探索性质,并未试图构建完整的预测系统。未来的工作可以进一步丰富数据源、改进相似性度量方法,并探索如何在保护隐私的前提下实现个性化的情绪健康支持。
总体而言,这项研究展示了数据科学在个体情绪健康分析中的潜力,强调了从个人情境出发理解情绪波动的重要性,为更精准、更人性化的健康分析工具提供了思路。
相关推荐
Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
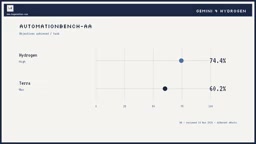
基于 Artificial Analysis 选型数据与实测反馈,拆解 Gemini 4 Hydrogen 的性价比悖论:高分不等于高价值,自动化工作流与代码任务表现分化,定价与 Google 订阅包各算各的账,SynthID 输出标识可能成为一票否决项。
Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
YouTube 创作者对 Gemini 4 Hydrogen 进行五项极限测试:单提示词生成游戏、3D 太阳系模拟、30 分钟视频时间戳定位、287 页财报转交互仪表盘,以及抗幻觉测试中 96.7% 的准确率表现。
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。