Gemini 4 Neon编程测试39%与12.8%之谜:工具差异还是模型实力?
Gemini 4 Neon 在 SWE-bench 风格测试中得分悬殊,凸显工具链差异对评估的影响。
文章分析了 Gemini 4 Neon 在同一 SWE-bench 风格基准下得分 39% 与 12.8% 的巨大差异,指出这源于测试设置的不同:提供商工具(如 Anti-Gravity CLI)与 mini-SWE-agent 框架。与 GPT-6.2 Sol 的差距从 30.7 个百分点收缩到 1.2 个百分点,表明工具链对结果影响显著。Google 的报告未隔离单一变量,无法将差距归因于模型能力。交叉验证 Terminal Bench 4.1 和 Frontier Code 2.0 显示 Opus 微弱领先 Neon,说明单一排行榜行不能作为普遍结论。文章建议根据决策场景进行受控测试,固定任务、时间、预算,衡量有用修复数、回归数、耗时和总成本,并重复试验以确保稳定性。
同一基准,两个分数:Gemini 4 Neon 的编程能力到底如何?
同一个 SWE-bench 风格的基准测试,Gemini 4 Neon 在一个设置下得分 39%,在另一个设置下只有 12.8%。这个差距不是小数点后的波动,而是三倍以上的悬殊。更耐人寻味的是,当测试环境从“提供商工具”切换到“mini-SWE-agent”后,它与 GPT-6.2 Sol 的差距从 30.7 个百分点骤然收缩到仅 1.2 个百分点。
据 YouTube 频道 FinePrint AI 的分析,Google 官方报告的数字并未隔离单一变量——不同的代理工具、不同的运行框架,让分数比较变得异常复杂。
SWE-bench 到底测什么?
SWE-bench 给代理一个真实代码仓库和一个宽泛任务:尽可能多地发现并修复 bug。它不会告诉代理哪些文件或 issue 包含 bug。基准用隐藏测试和现有测试套件验证修复,得分统计的是跨仓库修复的参考 bug 数量,并包含回归检查。
所以 39% 绝不等于“Gemini 能解决所有编程任务的 39%”。它只说明在这个特定任务设置下,代理修复了约四成的参考 bug——而且这个数字高度依赖代理如何使用工具。
SWE-bench 是 2023 年由普林斯顿大学等机构提出的基准,旨在评估语言模型在真实软件工程任务上的能力。它从 GitHub 上收集了数千个真实的 issue 和对应的 pull request,覆盖多个主流 Python 仓库。每个任务要求代理根据 issue 描述修改代码库,使其通过隐藏的测试用例。基准分为“完整”和“精简”两个版本,后者用于降低成本。SWE-bench 强调端到端的问题解决,而非简单的代码补全,因此对代理的工具使用、多步推理和代码理解能力提出了较高要求。其评分标准严格:只有所有隐藏测试通过才算修复成功,这避免了部分正确带来的虚高分数。
两行数据的背后:工具链差异有多大?
Google 公布的两行结果都是自家计算,而非基准创建者排行榜上的数据。
在“提供商工具”行中,Neon 使用 Anti-Gravity CLI 1.5.9,得分 39%;Opus 使用 Cloud Code;Sol 使用 Codex。三者是完整设置之间的对比,不是纯模型对比。
在“mini-SWE-agent”设置下,Neon 得分 12.8%,Opus 得分 3.6%,Sol 得分 11.6%。Neon 依然领先,但 Sol 大幅逼近,并且反超了 Opus。
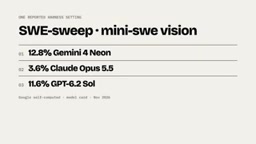
Neon 在两个设置间的差距达 26.2 个百分点,高分是低分的三倍多。Google 解释称,Anti-Gravity 有一个默认工具允许子代理在代码库中并行展开搜索——这恰好契合 bug 搜索类任务。这是一个有意义的工具差异,但 Google 的总结并未证明子代理导致了全部差距,甚至无法量化其贡献比例。时间、成本、提示词、子代理的实际使用情况,都会影响结果解读。
控制变量才能看清真相
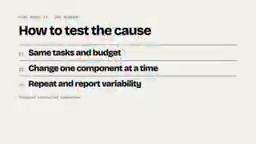
一个受控实验应该固定任务集和预算,记录所有设置,每次只改变一个组件。多次试验才能显示差距的稳定性。FinePrint AI 指出,Google 的报告没有建立“其他条件保持不变”的前提,因此 39% 与 12.8% 之间的鸿沟不能被简单归因于模型能力。
控制变量法是实验设计的核心原则,在机器学习评估中尤为重要。它要求实验中只改变一个自变量,同时保持其他所有条件不变,从而分离出该变量对结果的影响。在 AI 代理的基准测试中,这意味着需要固定任务集、提示词、预算、时间限制、工具链版本等。然而,现实中的评估往往难以完全控制,因为不同代理框架可能内置不同的默认工具或优化策略。例如,子代理并行搜索功能可以显著影响搜索类任务的表现,但若未在实验中明确隔离,其贡献就无法量化。因此,缺乏控制变量的比较只能提供相关性而非因果性结论,容易误导决策。
其他编程测试讲的是同一个故事吗?
单看 SWE-bench 容易陷入“单一排行榜行即普遍结论”的陷阱。交叉验证其他基准能提供更完整的图景。
在 Google 的表格中,Terminal Bench 4.1 上 Opus 领先 Neon 仅 0.6 个百分点,Sol 落后于两者。注意数据来源并不统一:Google 评估称 Neon 的 Terminal Bench 结果来自 Artificial Analysis 在 Anti-Gravity 中的运行,而其他 Terminal Bench 结果来自公共排行榜。
Frontier Code 2.0 上,Opus 领先 Neon 1.1 个百分点,Sol 位列第三。Frontier Code 结果同样来自其公共排行榜,Google 称 Neon 的结果使用了高思考模式。
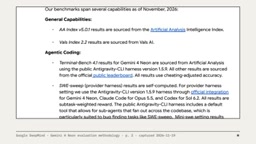
这些测试的结论与 SWE-bench 并不矛盾——它们各自衡量不同能力,因此不能用来“抵消”SWE-bench 的结果,但足以说明:仅凭一行排行榜数据做出普遍判断是危险的。
实践建议:如何根据你的决策选择对比
FinePrint AI 的结论很直接:选择与你决策相匹配的对比方式。
- 如果你在采购完整的编程代理:在自己的仓库上测试整个设置,保持相同任务、时间和花费限制。
- 如果你在为现有代理选择模型:尽量保持代理不变,单独测试模型替换的效果。
- 衡量指标:有用修复数、回归数、耗时、总成本。
- 重复试验:在宣布赢家之前,多次运行任务以确认稳定性。
Google 的数字让“Neon + Anti-Gravity”成为一个值得深入调查的组合,但它们没有告诉我们模型本身或某个单一功能能解释全部差异。对于开发者和技术决策者而言,与其纠结于排行榜上的单一百分比,不如在自己的真实工作流中做受控测试——那才是对你最有意义的数字。
背景补充
Terminal Bench 是另一个评估 AI 代理在命令行环境中执行任务的基准,侧重于文件操作、进程管理和系统交互等能力。它模拟真实终端场景,要求代理通过 shell 命令完成指定任务,并检查最终状态。与 SWE-bench 不同,Terminal Bench 更关注代理对操作系统和工具链的熟练度,而非代码修复。Frontier Code 则是一个代码生成基准,评估模型根据自然语言描述生成正确代码的能力,通常包括函数级和项目级任务。这两个基准与 SWE-bench 互补,分别衡量代理的不同方面:终端操作、代码生成和问题修复。因此,跨基准比较时需注意它们测量的是不同能力维度,不能简单相互替代或抵消。
相关推荐
Gemini 4 Neon一次性建我的世界克隆:魔法与翻车
Gemini 4 Neon 在对比测试中用一次性提示词完胜 Claude Opus 5.5,但实测冷启动暴露水物理崩坏与 bash 可靠性短板。本文拆解其 API 定价陷阱、8 智能体 Swarm 的真实威力,以及什么场景该用 Neon、什么场景该换 GPT 6.2 Sol。
Gemini 4 Neon vs Claude Opus 5.5:基准测试与真实代码的反转
Gemini 4 Neon 在 19 项基准中赢 16 项,但生产代码测试 Opus 以 7 分胜出。本文解析工具链 AntiGravity 如何扭曲分数,以及按任务类型选模型的实用建议。
Gemini 4 Neon对决Claude与GPT:王座易主?
Google Gemini 4 Neon发布,在Artificial Analysis榜单多个档位超越Claude Opus 5.5与GPT 6.2 Sol,自主编码与长上下文优势明显,成本低63%、首答快六倍。本文拆解基准数据、真实交付项目与安全指标。