Gemini 4 Neon对决Claude与GPT:王座易主?
Gemini 4 Neon在多项基准与成本上超越Claude与GPT,但并非全面碾压。
Gemini 4 Neon于11月18日发布,定位在Gemini 4家族中间,提供100万token多模态上下文和4档思考层级。在Artificial Analysis榜单上,Neon每个思考档位都领先Claude Opus 5.5与GPT 6.2 Sol,默认高档位得分60,超过对手最高档且每任务成本低63%。自主编码与长上下文优势最大:Coding Agent Index全球第一,百万token上下文Graph Walks达95.2%。非幻觉率85.6%接近Opus 5.5两倍,间接提示注入攻击成功率0.0%。实际案例包括10,200行WebGL2着色器滑雪模拟器、图灵书房3D重建和10万单元格动态表格。超高思考档每任务6.44美元,比Opus 5.5便宜36%,首答时间快六倍。
Gemini 4 Neon对决Claude与GPT:王座易主?
当一款模型能在一天之内写出10,200行WebGL2着色器、构建带实时雪崩的120Hz高山滑雪模拟器、用3D重建图灵1936年的剑桥书房,并且成本还低于两个主要对手时,模型竞争的叙事就变了。Google发布的Gemini 4 Neon,正试图用一整套硬指标证明:王座可能真的换人了。
产品定位:填补Gemini 4产品线的甜点区
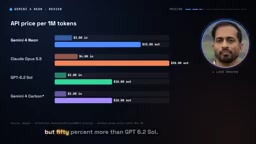
Gemini 4 Neon于11月18日发布,定位在Gemini 4家族中间——上有专注长周期研究的Carbon,下有主打日常任务的极速版Hydrogen。Neon提供100万token的多模态上下文窗口和从低到超高共4档思考层级,API定价为输入每百万token 3美元、输出15美元,缓存价格0.15美元,相当于95%的缓存折扣。
按照YouTube频道对独立评测机构Artificial Analysis排行榜的解读,这套配置直接切入了企业级 agentic 工作负载最敏感的区间:够用的上下文、可调的推理深度、以及能算得过账的成本。
思考档位(Thinking Levels) 是Gemini 4系列引入的推理深度控制机制。模型在回答前会进行内部“思考”,档位越高,允许的思考步数或计算预算越多,适合复杂推理;档位越低,响应越快、成本越低。Neon提供从低到超高共4档,相当于让同一模型在不同延迟与成本约束下灵活切换,这是企业级 agent 工作负载按需分配算力的关键。
基准测试:每个思考档位都压过对手
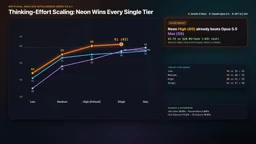
在Artificial Analysis的独立排行榜上,Neon在超高思考档位拿到61分,总排名第三,高于Claude Opus 5.5 Max的59分和GPT 6.2 Sol Max的57分。更有说服力的是,当把从低到最高的每一个思考档位都画在同一张图上时,Neon在每一档都领先两个对手。
默认的高思考档位下,Neon已经拿到60分,超过Opus 5.5 Max,而每个任务的成本低63%。在企业与科学类任务上,Neon在Val's Index拿到70.9%、Riemann Bench 84%、HLE Diamond 71.3%、Terminal Bench Science 70.5%。
公平地说,Opus 5.5在Terminal Bench 4.1和Frontier Code 2.0上领先约1分,Sol 6.2则在Chartography上略占优势。这不是全面碾压,而是优势区域的重新划分。
Artificial Analysis 是一家独立评测机构,维护多个公开排行榜,汇总各家模型在推理、编码、长上下文等任务上的表现并给出综合分数。其榜单常被业界引用为模型选型的参考,但分数受测试集、采样参数和运行环境影响,不同版本之间不宜直接跨榜比较。
自主编码与长上下文:差距最大的战场
Neon真正拉开距离的地方是自主编码和长上下文。据该视频引用的数据,它在Artificial Analysis Coding Agent Index上以58.6分排名全球第一,在Zapier的Automation Bench上以56.3%排名第一,分别领先Opus 5.5超过13分、领先Sol 6.2 15分。
在Google Anti-Gravity环境内的SWE Sweep测试中,Neon达到39%,接近Opus 5.5的10.1%的四倍、Sol 8.3%的近五倍。Cursor Bench 4.1上以65.4对58.1领先。在256k到100万token的Graph Walks长上下文测试中,Neon达到95.2%,Sol为80.1%,Opus 5.5仅为66.8%。
这些数字指向同一个结论:当任务需要在长上下文中维持自主编码状态时,Neon的衰减曲线比其他模型平缓得多。
真实交付物:从滑雪模拟器到图灵书房
视频展示了几个用Neon实际跑出来的项目,这比基准分数更能说明工程能力。第一个是第一人称Chamonix自由式滑雪模拟器,完全在Google Anti-Gravity中从零编写:基于勃朗峰和霞慕尼的真实海拔地形,10,200行自定义WebGL2着色器,6条高山线路上的120Hz滑雪物理,实时滑雪者阴影、动态压出的雪痕、空间音频,以及体积感的板状雪崩——全程没有使用任何预制3D素材。
第二个项目是用Neon Swarm重建历史:模型调取1936年剑桥国王学院的档案照片,对国王学院礼拜堂外观和图灵在X.8房间的内部进行建模与绑定,由Blender生成符合年代感的材质和暖光,并在书桌上动画化了一台运行纸带的机械通用图灵机。
第三个项目由另一个Swarm驱动Blender MCP,渲染出带本生灯火焰和发光氖放电管的写实元素实验室工作台。第四个项目则把一张照片转成10万单元格的Google Sheet,运行50万个实时表格公式做3D深度映射和六种交互式重打光模式,不嵌入任何图片、不写任何Apps Script。
真实性与安全:企业最在意的差距
对企业团队来说,最刺眼的对比在真实性和安全上。在Artificial Analysis的Omniscience测试中,Neon的非幻觉率为85.6%,默认高思考档位下升至86.1%,接近Claude Opus 5.5的49.7%的两倍,而GPT 6.2 Sol为44.6%。
在GraySwan的间接提示注入测试中,Neon的攻击成功率为0.0%,Opus 5.5为1.0%,Sol 6.2为2.3%。网络防御方面,Neon在AutoBaxBench拿到76%、WebExploitBench 51.3%、SECBenchPro 90.5%、CWEBenchV2 70.7%。
需要说明,这些数字全部来自视频引用的第三方评测,不同测试环境下的复现结果可能存在差异,尤其是提示注入这类对抗性测试对测试集设计高度敏感。
间接提示注入(Indirect Prompt Injection) 指攻击者将恶意指令藏于模型读取的外部内容(如网页、文档、邮件)中,诱导模型在后续自主操作中执行非预期行为。对具备工具调用和自主编码能力的 agent 而言,这类攻击可能导致数据泄露或越权操作,因此攻击成功率是评估企业部署安全性的核心指标之一。
成本与速度:每分钟都在省钱
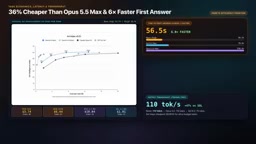
在超高思考档位下,Neon完成整套基准测试每个任务花费6.44美元,比Opus 5.5 Max的10.04美元便宜36%,首答时间快六倍——56.5秒对338.6秒。GPT 6.2 Sol在每token成本上仍更便宜,每任务2.10美元,适合超低预算负载,但Neon以每秒110 token的速度快47%,在时间维度上占优。
对需要跑大量agent任务的团队来说,首答时间的差距会直接转化为流水线吞吐量的差距。这也是"每任务成本"比"每token价格"更能反映真实开销的原因:便宜的token如果换来更长的等待和更多的重试,账面上的优势会很快消失。
首答时间(Time to First Token, TTFT) 指从发出请求到收到第一个输出 token 的延迟,直接影响交互体验和流水线吞吐。对批量 agent 任务,TTFT 的差距会叠加成显著的等待成本;这也是“每任务成本”比“每 token 价格”更能反映真实开销的原因——便宜的 token 若换来更长等待和更多重试,账面优势会迅速消失。
结论:不是碾压,是重新划线
Neon没有在所有维度上击败对手——Opus 5.5在部分终端编码测试上仍领先约1分,Sol 6.2在图表类任务上更好,且每token价格更低。但Neon在思考档位一致性、长上下文保持、非幻觉率、提示注入防护和每任务成本上建立了明显优势。
视频结尾部分的内容存在明显的语音识别混乱,涉及合作方等表述无法核实,本文不予采信。可以确定的是:这一轮竞争的重点已经从"谁更聪明"转向"谁在长周期自主任务中更可靠、更便宜"。对正在评估agent基础设施的团队来说,这比排行榜第一名的归属更值得关注。
相关推荐
Gemini 4 Neon实测:成本减半性能逼近旗舰
Gemini 4 Neon 实测汇总:智能指数 61 分超越自家旗舰 Carbon,Coding Agents 性能与 Opus 5.5 打平但成本减半。含纯代码 3D 演示、官方定价与失败案例。
Gemini 4 Neon 实测对比 Claude Opus 5.5:谁更值得切换
Gemini 4 Neon 实测对比 Claude Opus 5.5:官方基准知识工作与长上下文领先,但编程仍略逊;独立评测智能指数更高却更慢更啰嗦,两轮实测各有胜负,告诉你什么场景该切换。
Gemini 4 Neon一次性建我的世界克隆:魔法与翻车
Gemini 4 Neon 在对比测试中用一次性提示词完胜 Claude Opus 5.5,但实测冷启动暴露水物理崩坏与 bash 可靠性短板。本文拆解其 API 定价陷阱、8 智能体 Swarm 的真实威力,以及什么场景该用 Neon、什么场景该换 GPT 6.2 Sol。