Gemini 4 Neon实测:半价挑战Opus 5.5,谁更强?
Gemini 4 Neon以半价任务成本逼近Opus 5.5,但硬核编程仍略逊。
Google新模型Gemini 4 Neon在开发者实测中展现出显著的成本优势:每任务成本约6.86美元,仅为Opus 5.5(12.61美元)的一半,但每token价格仅便宜25%。在像素城生成、代码修复等任务中,Neon质量接近Opus,智能指数61略高于59,但在Terminal Bench和Frontier Code等硬核编程测试中仍落后约一个百分点。Neon在长时任务中表现高效,能修复破损程序并找出全部预埋bug,但出现容量错误导致中断。社区讨论的“半价吊打”并不准确,实际策略应是组合使用:Neon承担高频agent与长文档任务,Opus把关高风险深度编程。
Google新发布的Gemini 4 Neon在开发者社区引发了激烈讨论。最抓眼球的说法是:它能以一半的成本达到Claude Opus 5.5的水平,甚至在某些测试中反超。但真实情况远比一句"半价吊打"复杂。我梳理了发布24小时内多位开发者的实测、第三方基准和官方定价表,试图还原一个更接近事实的图景。
实测对决:像素城与前端生成
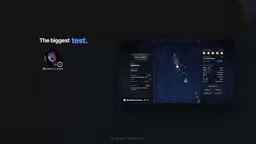
开发者Jazzy用同一个提示词让两个模型在最高推理档位下生成一座细节丰富的像素艺术城市。Neon耗时约20分钟,成本约3.50美元;Opus耗时18分钟,成本约7.20美元。Jazzy的评价是,Neon的产出细节密度惊人,是Gemini 4系列在该测试上最好的一次表现。但最终结论仍然是Opus整体更好。这组对比奠定了整场讨论的基调:成本优势明确,质量差距缩小但未消失。
另一位测试者AJ将Neon与Google更快的Hydrogen模型并排对比前端生成能力。Neon主动加入了昼夜循环、时间跳转和真实的星空星座——这些都不在提示词里。Hydrogen则给出一个克制版本。AJ的结论是,Hydrogen加Neon可能是当前效率最高的组合。
最高推理档位通常指模型在生成内容时启用的最大计算量配置,例如更多的思维链步骤或更长的内部推理时间。这会影响生成质量、耗时和成本。在像素城测试中,Neon和Opus均以最高档位运行,但Neon耗时20分钟、成本3.50美元,Opus耗时18分钟、成本7.20美元。最高档位下模型能处理更复杂的细节,但并非所有任务都需要此配置;日常使用中,开发者可能选择较低档位以平衡速度与成本。这也解释了为何AJ将Neon与更快的Hydrogen对比时,强调组合使用可能更高效。
长时任务与代码修复:一天的真实压力测试
ChubbyOnX获得早期访问权限后,在Google的编程工具Anti-Gravity里完整用了一天。Neon构建了17个交互演示,其中包括一个带敌人波次、生命值、弹药和换弹机制的3D竞技场射击游戏,全部可运行。不过首次构建因服务器错误崩溃,需要第二轮修复。
更能说明问题的是三个刻意破坏的程序修复任务:预订检查器从5项测试通过1项提升到5项全过;任务调度器从14项通过8项提升到全过;异步加载器从16项通过10项提升到全过。在代码审查环节,Neon找出了预先埋入的全部四个bug。日志显示,13个会话中共发生762次工具调用,模式高度一致:一次性读取所需文件,一次编辑写入修复,再读回验证,每个修复耗时两到三分钟。
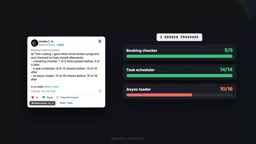
弱点同样明显。Chubby记录到一次容量错误"Capacity 57",当天出现四次运行直接中断,没有报错。这可能是发布首日的负载问题,但确实消耗了真实时间。
工具调用(Tool Call) 指模型在完成任务过程中主动调用外部工具(如文件读取、代码编辑、终端执行等)的行为。在ChubbyOnX的测试中,Neon在13个会话中共发生762次工具调用,平均每个会话约58次,模式为“读取-编辑-验证”循环。这种高频调用是Agent型模型的典型特征,但也意味着模型需要具备稳定的规划能力,避免重复或无效操作。工具调用次数过多可能增加延迟和成本,过少则可能遗漏关键步骤。Neon的一次性读取和写入策略较为高效,但容量错误导致的中断暴露了其在长时任务中的可靠性风险。
基准与定价:半价说法的真相
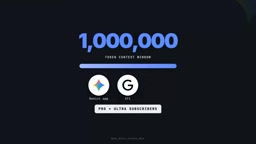
Neon发布于11月18日,定位在Google新模型阵容的中层:Carbon负责最重最长的项目,Hydrogen主打快速廉价,Neon介于两者之间并取代Argon。它拥有100万token上下文窗口,已在Gemini应用(Pro和Ultra订阅)、API以及Anti-Gravity中上线。
Artificial Analysis的九项困难评估汇总成一个智能指数,Neon得分61,Opus 5.5得分59,位列全球第三,仅次于Clawed Fable 5.2的65和GPT 6.2 Astra的62。基于4200个真实agent会话的Agent Arena指数中,Neon排名第二,Opus第三。但Google自己的对比表里,Opus仍在Terminal Bench 4.1和Frontier Code 2.0两项硬核编程测试中领先,优势约一个百分点,差距虽小却关键。独立评测者Beto的结果差距更大:Opus约87%,Neon约80%。
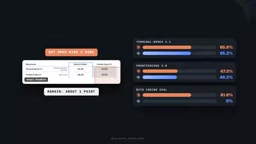
定价需要拆开看。按token计,Neon每百万输入3美元、输出15美元,Opus是4美元和20美元,实际只便宜25%,并非一半。"半价"来自每任务成本:Neon完成同样工作消耗更少token,Artificial Analysis测得每任务6.86美元对12.61美元,接近一半。准确说法是"半个任务量,半张账单",而不是价格标签减半。
智能指数与Agent Arena指数是评估AI模型能力的两种不同方式。Artificial Analysis的智能指数将九项困难评估的得分汇总为一个综合分数,侧重模型在标准化测试中的静态表现。而Agent Arena指数基于4200个真实agent会话,模拟模型在交互式、多步骤任务中的实际行为,更贴近真实使用场景。两者结合可以避免单一基准的偏差,例如Neon在智能指数上略高,但在Agent Arena中排名第二,说明其在实际任务中可能受限于稳定性或工具调用效率。这种差异也解释了为何Google自己的对比表仍显示Opus在特定编程测试中领先。
该选谁:场景决定答案
科技博主Greg Eisenberg的总结颇具代表性:Neon表现出色、速度快、每任务成本约为一半,但面对最难的问题,他仍然会拿起Clawed。这解释了社区中"超越Opus"的说法为何流行——它在多数通用基准和成本维度上确实领先,但在最考验工程判断的深度编程任务上,Opus仍以微弱优势守住阵地。
实际策略可以是组合使用:日常agent运行、研究和长文档处理交给Neon,充分利用其长上下文和成本优势;面对一次错误改动就可能耗费数小时的硬核编程任务,仍用Opus把关。Google在七周内推出四个模型,头部差距已缩小到一到两个百分点,竞争格局重新变得紧张。
(本文基于多位开发者的公开实测与第三方基准数据交叉整理,具体表现可能随模型版本更新而变化。)
相关推荐
Gemini 4 Neon一次性建我的世界克隆:魔法与翻车
Gemini 4 Neon 在对比测试中用一次性提示词完胜 Claude Opus 5.5,但实测冷启动暴露水物理崩坏与 bash 可靠性短板。本文拆解其 API 定价陷阱、8 智能体 Swarm 的真实威力,以及什么场景该用 Neon、什么场景该换 GPT 6.2 Sol。
Gemini 4 Neon vs Claude Opus 5.5:基准测试与真实代码的反转
Gemini 4 Neon 在 19 项基准中赢 16 项,但生产代码测试 Opus 以 7 分胜出。本文解析工具链 AntiGravity 如何扭曲分数,以及按任务类型选模型的实用建议。
Gemini 4 Neon对决Claude与GPT:王座易主?
Google Gemini 4 Neon发布,在Artificial Analysis榜单多个档位超越Claude Opus 5.5与GPT 6.2 Sol,自主编码与长上下文优势明显,成本低63%、首答快六倍。本文拆解基准数据、真实交付项目与安全指标。