GPT-6.1 Sol对决Sonnet 5.5:基准虚高还是Token效率王者?

GPT-6.1 Sol与Sonnet 5.5实测质量相当,但前者Token消耗低4-10倍,效率是核心优势。
本文通过前端设计、JavaScript视频、旅行仪表板和浏览器坦克游戏四组实测,横向比较了OpenAI GPT-6.1 Sol与Anthropic Sonnet 5.5的实际表现。结论是:两者最终成品质量大体相当,Sonnet在细节精致度和速度上略占优,但GPT-6.1 Sol在Token消耗上几乎每项都领先数倍,部分场景低达Sonnet的1/10。两款模型纸面API定价相同,差距完全来自实际Token用量。文章同时指出,OpenAI将200美元套餐用量从20倍降至10倍引发争议,但Anthropic的"20倍"本就附带5小时窗口限制,两家实质上都在管控用量。在此背景下,Token效率比原始基准分数更值得关注,6.1 Sol由此成为预算敏感场景下一个颇具竞争力的选择。
OpenAI开发者大会上最受关注的公告之一,就是GPT-6.1 Sol的发布。这个动作让不少人措手不及——此前发布的GPT-6 Astra口碑并不理想,仿佛才刚露面几天,紧接着就来了个基准测试成绩爆表的6.1版本。这不禁让人产生疑问:如果手里握着明显更强的6.1,OpenAI为什么要先推出表现平平的GPT-6 Sol?本文基于B站搬运的海外实测视频,通过GPT-6.1 Sol与Anthropic旗下Sonnet 5.5的一对一横评,试图厘清基准数据背后的真实情况。
基准数据的另一半故事:成本与Token效率
单看OpenAI放出的基准成绩,GPT-6.1 Sol确实惊艳。在DeepSuite基准上,6.1 Sol以极低成本反超了自家的GPT-6 Astra。但原始分数只讲述了故事的一半。
从Artificial Analysis指数来看,两者总体咬得很紧:Sonnet略微领先,在医疗领域领先约7分算是比较显著的差距。在偏重编程的测试中,6.1 Sol在DeepSuite上领先4.2分,而Sonnet在AutomationBench上以8.7分的明显优势胜出。纸面上两者每百万Token价格一致——输入2美元、输出10美元。
真正拉开差距的是Token效率。测试数据显示,在某些场景下6.1 Sol的运行成本比Sonnet低了10倍。在最高努力级别下,Sol每个任务成本仅72美分,而Sonnet高达7.6美元。即便在两者同样达到50%得分的公平对比中,Sol依然便宜4倍。不过代价是速度——报告显示Sonnet的速度约为Sol的两倍。
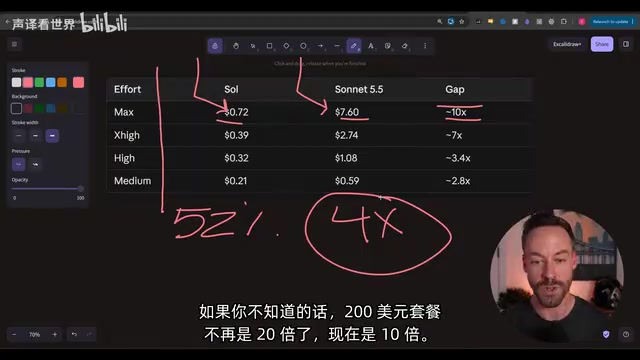
值得警惕的是,这些是基准测试环境下的理想成本,并非普通用户日常使用的真实开销。而这种极致的Token效率背后,也有OpenAI调整套餐的现实压力——200美元订阅的用量从20倍降到了10倍,相当于削减了一半用量。
DeepSuite与AutomationBench都是专为评估大语言模型在复杂任务中表现而设计的第三方基准测试集。DeepSuite侧重于软件工程类任务,包括多步骤代码生成、调试与系统设计;AutomationBench则更贴近自动化工作流场景,考察模型处理浏览器操作、API调用和多工具协作的能力。Artificial Analysis指数是一个综合多个子维度得分的加权排名,用于提供跨模型的横向比较,但其权重设置本身也会影响最终排序,因此单一基准胜出并不等同于综合能力领先。Token效率(每任务Token消耗量)近年来被越来越多的工程团队列为核心评估维度,因为同等API定价下,消耗更少Token意味着实际单次调用成本大幅下降,在高频调用或长上下文场景中差异尤为显著。
前端设计横评:干净专业 vs 细节丰富
第一组实测聚焦前端设计,要求为虚构精品酒店"Dune House"打造落地页。由于Sonnet不像6.1 Sol那样内置图像生成,测试中为其接入了Higgsfield API来生成图像素材。
6.1 Sol交出的页面延续了GPT系列一贯的风格——非常干净、专业,不算花哨但观感扎实。美中不足的是房间查询功能过于简单,缺少按日期和人数筛选可用性的常见栏目。创建这个页面仅消耗约10,090个Token。
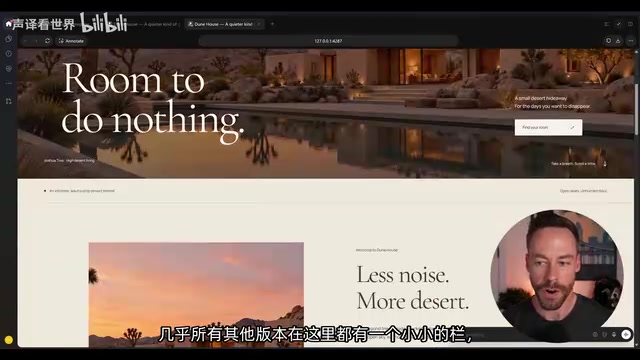
Sonnet 5.5的版本在功能性上更胜一筹,英雄区支持直接查询可用性,向下滚动还有图片裁剪等AI以往不会主动尝试的精致处理。但"检查可用性"按钮的设计略显廉价,字体也有争议。整体上设计偏好因人而异,测试者判定为平局——但Sonnet消耗的Token约为Sol的两倍。
视觉奇观与JavaScript视频:各有胜负
在JavaScript解说视频生成测试中,新一代模型能纯粹通过代码生成视频,无需依赖AI生成工具。6.1 Sol的成品被评为"平庸"——视觉尚可,但音频像是随机配乐,缺乏融合感,消耗70K Token。Sonnet 5.5则明显更好,多场景切换加上音画高度协调,形成连贯叙事,但代价是约30万Token。
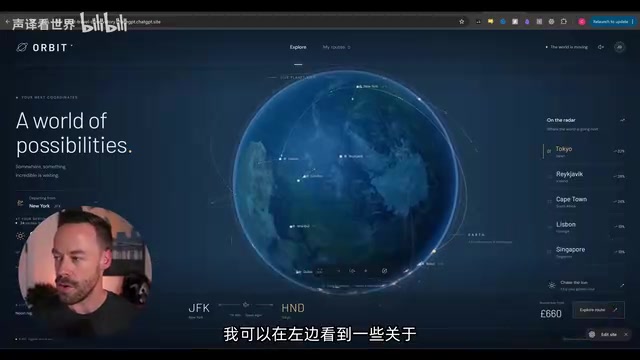
旅行仪表板测试要求做出"视觉奇观"。6.1 Sol的3D地球仪能展示航线、目的地天气和黄金时刻信息,但存在闪烁黑框的小bug,且信息深度不足。Sonnet 5.5则在视觉表现上占优,配有音频、城市图片(经Higgsfield生成)和随时间变化的天气信息,地球滚动效果颇为惊艳。这一局测试者把优势给了Sonnet,但Sol只用了约15万Token,Sonnet则花了40万。
用JavaScript纯代码生成视频(即无需调用Sora、Runway等AI视频生成服务)是近年兴起的一种能力评测方向。其原理是让模型输出一套完整的HTML/CSS/JavaScript代码,借助Canvas API或WebGL在浏览器中以动画形式逐帧渲染画面,同时通过Web Audio API合成或调度音频,最终录屏导出为视频文件。这种方式能较为纯粹地测试模型对复杂逻辑、时序协调和视觉布局的综合把控能力,而不依赖外部生成工具的质量。Three.js是基于WebGL封装的主流JavaScript 3D渲染库,被广泛用于浏览器端的3D场景、地球仪和游戏原型开发,其API抽象程度适中,要求模型既理解3D空间概念,又能正确组织渲染循环、相机、光照与材质等模块。
浏览器坦克游戏:主观打平,Token再胜
最后一组测试要求用Three.js克隆《坦克世界》并在浏览器运行。6.1 Sol给出四种坦克选择、三种弹药、实时小地图和敌我血量显示,UI相当扎实,但缺少穿透机制略显遗憾。Sonnet 5.5则在坦克数据统计上更详尽,地图更大、缩放控制更顺手,但坦克的氛围感稍弱。
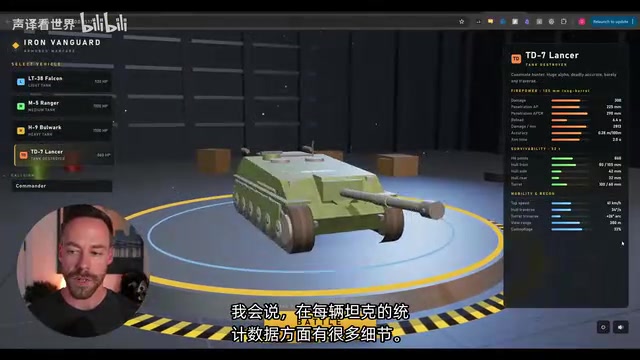
这类涉及UI与手感的评价高度主观,测试者判定基本持平。Token与速度方面的对比再次印证结论:Sol慢了很多,耗时超过两小时才完成,Sonnet约一小时;但Sonnet用了约70万Token,Sol只用了约一半。
定价背后的"20倍"真相
针对外界对OpenAI下调套餐用量的抱怨,测试者提供了一个容易被忽略的背景:Anthropic的"20倍"套餐从来都不是真正的20倍,它专门与5小时限制挂钩,而非每周限制;而OpenAI的计划没有5小时限制。换句话说,按同样逻辑衡量,两家都在"用量管理"上留了后手,只是OpenAI把每周用量的调整说得更明白。
这段分析并非为OpenAI辩护,而是提醒用户:在两家都收紧用量的现实下,Token效率反而成了比原始分数更值得关注的指标。
主流AI订阅服务普遍采用"用量倍数"而非固定Token配额来描述套餐权益,这使得跨平台比较极易产生误导。Anthropic的"20倍"指的是在任意连续5小时窗口内相对基础用量的上限倍数,而非每日或每周总量;OpenAI的"10倍"则对应按周重置的累计用量上限,且不设单次连续使用的时间窗口限制。两种计量方式针对的使用模式不同:短时高强度用户在Anthropic的规则下更易触发限流,而持续全天候使用的用户在OpenAI的规则下更容易逼近周上限。在两家都在收紧实际可用量的背景下,模型每完成一个任务所消耗的Token数量,比订阅标称的"倍数"更能直接反映用户的真实使用体验。
结论:便宜4倍的扎实选择
综合所有测试,6.1 Sol在最终成品质量上大致与Sonnet 5.5相当,个别场景略逊,但在Token消耗上几乎每一项都显著领先。它更便宜、更省Token,但速度更慢。
对大多数现实任务而言,用6.1 Sol替代Sonnet甚至Opus、Astra完全可行,关键取决于你的具体用例和预算。如果这种超高效率不只是发布期的"基准优化",而能长期保持,那就意味着市场多了一个极其便宜又相当强大的选项——在部分相同基准上得分相当,成本却低4倍,这一点确实不容忽视。
相关推荐

AI温和派的崛起:在狂热与末日论之间寻找中间地带
AI舆论正陷入加速主义与末日论的两极撕裂,但一群"AI温和派"正在崛起。本文梳理福山、"AI作为常规技术"作者及好莱坞制片人卡森伯格的最新观点,呈现在狂热与恐惧之间寻找中间地带的思潮。
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。