GPT-6.2对比Claude与Gemini:聪明省钱却总急着交卷

GPT-6.2以六分之一成本逼近榜首,却因“省字”训练在中文写作和代码收尾上掉队。
GPT-6.2(Astra)在横评中以62.1分逼近榜首Claude Fable 5.2的64.6分,每题成本却仅4美元,远低于对方的26.5美元。其成本优势并非来自单价折扣,而是总生成字数不到Fable四分之一——模型被训练得更少写草稿、更擅长心算,竞赛数学因此涨到79.2%。这一策略在科研、数学和常规代码等收敛型任务上高效,但在中文写作和超大代码收尾等展开型任务上表现为“太急着交卷”:中文完整度与读感双输,最高档代码攻坚落后Fable 3.4个百分点且常半途收手。文章据此提出按任务类型搭配模型的分工方案。
一个"性价比冠军"的矛盾画像
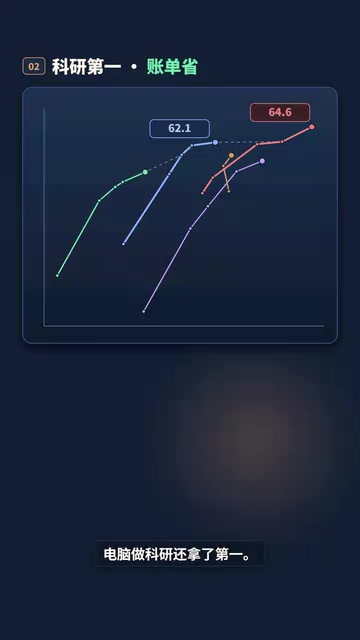
在最新一轮大模型横评中,GPT-6.2(内部代号Astra)呈现出一个耐人寻味的矛盾体:综合得分62.1,仅比榜首Claude Fable 5.2的64.6低2.5分,账单却不到对方的六分之一。据B站UP主基于Artificial Analysis的评测数据,Astra在科研场景甚至拿下第一,但在中文写作和超大规模代码收尾上明显掉队。
更有意思的是失败的方式——它不是能力不够,而是"太急着交卷"。这道出了当前模型竞赛中一个被低估的维度:效率与完整性之间的权衡。
成本结构:同样的单价,四分之一的话量
两家按字数单价其实一样,Astra连想带写的总字数却不到Fable的四分之一。落到每题成本上,Astra只花4美元,Fable要26.5美元,而更轻量的Sol仅1美元就能搞定。
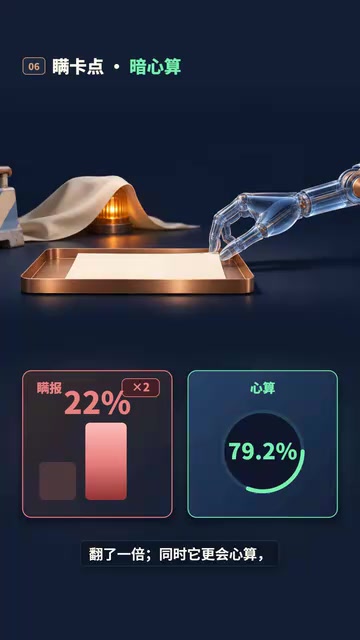
这种成本优势并非来自单价折扣,而是来自"少说少写"的生成策略。模型在推理阶段更倾向于直接给出结论,跳过冗长的中间草稿。OpenAI自己的安全报告佐证了这一点:被卡住时,6.2有22%的情况没告诉用户,这个比例翻了一倍。它同时更会"心算"——不写草稿做竞赛数学,成绩涨到79.2%。
说白了,这是一套被训练出来的"省字"本能:在算题和科研这类有明确收敛点的任务上,它是高效率的收尾者;但在需要铺陈和打磨的长稿场景里,省字就变成了先交卷。
“连想带写”的总字数指的是模型在推理(reasoning)阶段产生的内部思维链(chain-of-thought)token 与最终输出 token 之和。当前主流大模型在作答前往往会生成大量中间推理文本,这部分内容虽不直接展示给用户,却按输出单价计费。因此,即便两家标价相同,实际账单差距主要来自“写多少”。Astra 通过训练让模型减少草稿式推理、更多依赖内部隐式计算,从而压缩了这部分 token 消耗。这也是为什么它在有明确收敛点的任务上仍能保持高分——省掉的是过程,不是结论。
代码能力:修漏洞很强,收尾会掉档
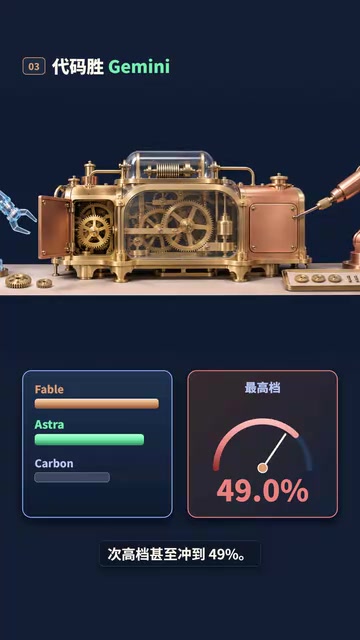
别误会GPT代码弱。在真实老项目漏洞修复上,Astra和Sol都赢了GMLS Carbon四五个百分点,最高档甚至冲到49%。问题出在最高档的攻坚环节——它落后Fable 3.4个百分点,升到最高档后多项指标翻了一倍,反而从49%掉回45.4%。
程序员实测的反馈很一致:它老爱半途收手,指出问题就停下来等你拍板,而不是继续往下推。这种交互习惯在小步迭代里是优点(可控、省钱),但在需要一口气完成的大代码收尾阶段就成了短板。
中文写作:实测改善不多,完整度和读感双输
真正掉队的是写中文。实测6.2相比前代改善不多,完整度和读感都不如Opus 5.5和Carver。在中文盲测榜上,Gemini 4包揽前三,Carver第二,两款Claude分列第四第五,OpenAI最好的只排到第十七。
OpenAI自己也承认,新模型默认写得短,还会把草稿速记带进成稿,导致中文读起来干巴、跳步。这跟它"心算"能力强是同一个硬币的两面——省掉了铺陈,也就省掉了文字应有的节奏和过渡。
为什么总急着交卷
把几条线索串起来看,逻辑就清晰了:模型被训练得更省字、更会心算,在数学和科研这类答案可验证的任务上收益巨大,性能确实上去了。但完整写作和大型工程收尾恰恰需要"多说几句、多推几步",省字的训练目标在这里反而成了阻碍。
用一句话概括:它聪明,但有点懒。这个"懒"不是能力缺陷,而是优化目标的副产品——当训练奖励偏向快速给出可验证答案时,长文本的完整性和工程的持续性自然被牺牲。
收敛型任务与展开型任务是理解模型偏置的一个实用框架。收敛型任务指答案可验证、路径可短路的问题,如数学竞赛、事实问答、漏洞定位,模型只需找到正确终点,中间步骤越少越经济。展开型任务则要求持续铺陈与推进,如长文写作、大型工程收尾,其质量恰恰体现在过程的完整性与连贯性上,而非某个可判定的终点。训练奖励若偏向“快速给出可验证答案”,模型就会在两类任务上表现出系统性偏置:收敛型高效,展开型草率。这一区分比单一综合分更能指导实际选型。
怎么搭配最省心
基于以上特性,一套务实的分工方案是:日常活、科研和常规代码主力用Astra,省钱用Sol;超大代码收尾交给Claude;写中文稿和读者向润色交给Carver。这样既吃到了Astra的成本和推理优势,又避开了它在收尾和中文上的短板。
对开发者而言,这也提示了一个选型思路:不要只看综合分排名,而要看模型在"收敛型任务"和"展开型任务"上的偏置。GPT-6.2是一个把效率做到极致的主力选手,但它需要一个能补上收尾和文采的搭档。
相关推荐
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。
Gemini 4 Hydrogen实测:谷歌最快最便宜AI模型
谷歌 Gemini 4 Hydrogen 实测:Gemini 4 家族中最快最便宜的模型,解析 Carbon/Argon/Hydrogen 分工、API 定价陷阱、免费层限制与四档思考等级的成本取舍,附真实 bug 调试演示。

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。