解剖对话式AI的网络搜索:ChatGPT、Claude、Grok谁更靠谱?
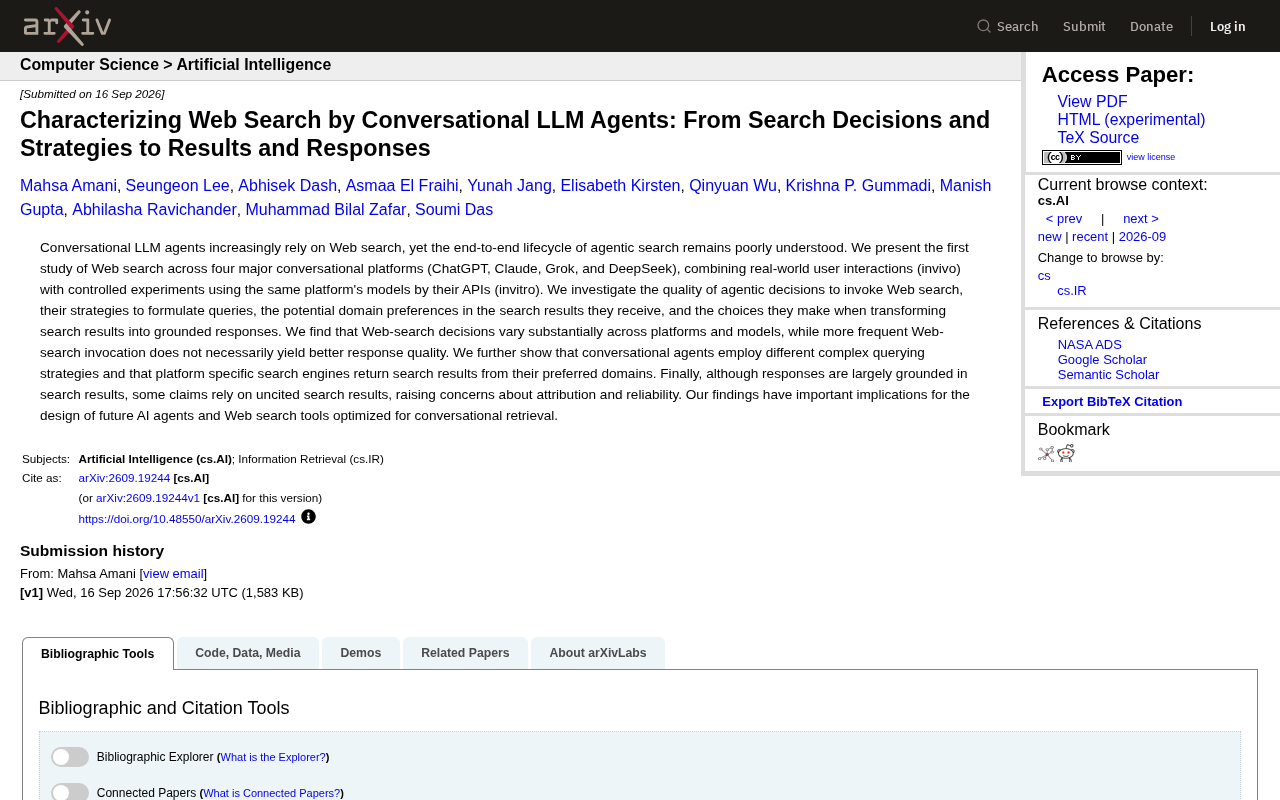
首项系统研究揭示四大对话AI平台网络搜索的完整行为链路,发现搜多不等于答好、引用缺失与信源偏差等关键问题。
这项发表于arXiv的研究首次从检索决策、查询构造、信源偏好到答案生成,对ChatGPT、Claude、Grok、DeepSeek四大平台的网络搜索全流程进行系统剖析。研究同时采用真实用户交互(invivo)和API受控实验(invitro)双轨方法,得出三项核心发现:搜索调用频率与回答质量并不正相关,决策质量比数量更重要;各平台搜索后端存在领域偏好,倾向返回特定域名的内容,构成隐性信息偏差;模型回答中存在未注明来源的论断,影响透明度与可追溯性。研究为未来AI代理的检索机制、查询策略、引用规范等设计方向提供了实证依据,同时提醒用户对AI给出的"事实性"信息保持审慎。
对话式大语言模型(LLM)代理越来越依赖网络搜索来获取实时信息,但从决定何时搜索、如何构造查询、到最终生成回答的完整链路,学界始终缺乏系统性的理解。一篇发表于 arXiv 的最新研究(arXiv:2609.19244)首次对这一端到端流程展开了全面剖析,覆盖了 ChatGPT、Claude、Grok 和 DeepSeek 四大主流对话平台。
这项研究的价值在于,它不仅关注模型"答得对不对",更深入到"它凭什么这么答"——即代理在检索决策、查询策略、结果来源和答案生成四个环节上的行为特征。这对理解当下 AI 助手的可靠性边界,以及未来 AI 代理与搜索工具的设计方向,都提供了实证依据。
研究方法:真实交互与受控实验双管齐下
研究团队采用了一套颇具巧思的双轨方法论。一方面通过"体内"(invivo)观察,收集真实世界中用户与这些平台的交互数据;另一方面通过"体外"(invitro)方式,调用各平台官方 API 中的相同模型进行受控实验。
这种组合的意义在于,真实交互能够反映用户在自然场景下触发的搜索行为,而受控实验则排除了外部变量的干扰,使得跨平台、跨模型的横向比较成为可能。四大平台的选取也具有代表性:ChatGPT 和 Claude 代表西方头部厂商,Grok 深度绑定社交平台的实时数据,DeepSeek 则是近期备受关注的开源力量。
研究围绕四个核心问题展开:代理决定调用网络搜索的质量如何、它们构造查询的策略是什么、返回的搜索结果是否存在领域偏好、以及它们如何将搜索结果转化为有据可依的回答。
核心发现一:搜多不等于答得好
研究得出的一个反直觉结论是——网络搜索的调用频率在不同平台和模型间差异巨大,而更频繁地触发搜索并不必然带来更高质量的回答。
这一发现挑战了"检索越多越可靠"的朴素假设。它意味着搜索决策本身的"质量"比"数量"更关键:一个懂得在恰当时机、针对恰当问题触发检索的代理,可能比一个动辄搜索的代理表现更好。过度检索不仅浪费算力和响应时间,还可能引入噪声信息,反而稀释了回答的准确性。
对于产品设计者而言,这提示了一个优化方向:与其一味增加搜索调用,不如打磨模型判断"何时需要搜索"的能力。何时依赖自身参数化知识、何时求助外部检索,这道"决策题"的答对率,才是决定体验的关键变量。
核心发现二:查询策略与搜索引擎的领域偏好
研究还揭示,不同的对话代理会采用差异化的复杂查询策略。也就是说,面对同一个用户问题,各平台的模型在如何拆解、改写、组合搜索关键词上各有一套自己的方法论,这直接影响了它们能检索到什么样的信息。
更值得警惕的是领域偏好问题。研究发现,各平台特定的搜索引擎倾向于返回来自其"偏好域名"的结果。这意味着不同 AI 助手对同一问题的回答,可能从源头上就受到了各自检索后端的信息筛选影响。
这种偏好背后可能涉及商业合作、数据合规、内容质量评估等多重因素,但对用户而言,它构成了一种隐性的信息偏差。当你在不同 AI 助手上问同一个问题却得到不同答案时,分歧或许并不源于模型本身,而是它们"看到"的世界本就不同。
搜索引擎的"领域偏好"在技术层面与其排名算法、爬取策略及商业合作机制密切相关。以微软必应(Bing)为例,ChatGPT早期版本的搜索功能即依托必应后端,这意味着必应的域名权重评估体系会直接影响模型能"看到"哪些内容。与此同时,不同平台可能存在内容许可协议,限制或优先展示特定媒体机构的结果。对于Grok而言,其深度整合X(原Twitter)平台的实时数据,天然形成了对社交媒体内容的倾斜。这种结构性偏好与传统搜索引擎的"过滤气泡"(filter bubble)现象本质相似,只是在AI代理场景下,用户对这一机制的感知和控制能力更加有限——传统搜索用户尚可通过换词、换引擎来突破信息茧房,而对话式AI的检索过程对用户完全不透明。
核心发现三:引用缺失带来的可信度隐忧
研究在答案生成环节发现,虽然对话代理的回答大体上都基于搜索结果(grounded),但仍有一部分论断依赖于"未被引用"的搜索结果。
换句话说,模型在生成回答时使用了某些检索到的信息,却没有在回答中标注其来源。这直接引发了归因(attribution)与可靠性方面的担忧。用户无法追溯某个具体论断的出处,也就难以判断其可信程度,更无法进行事实核查。
在信息真实性愈发重要的当下,这一问题尤为敏感。一个负责任的 AI 助手,不仅要答得对,还应当"言之有据",让用户能够顺藤摸瓜验证信息。引用缺失的普遍存在,说明当前对话式 AI 在透明度建设上仍有明显短板。
归因(attribution)问题在AI领域有其特定含义:它要求模型不仅给出答案,还要明确指出该答案来自哪个具体来源。这与学术写作中的引用规范类似,但在对话式AI场景下实现难度更高——模型需要在检索、整合、生成三个步骤中始终追踪信息的来源链条。当前主流的RAG(检索增强生成)架构虽然理论上支持引用追踪,但实际部署中,模型往往会将多个来源的内容融合改写,导致具体论断与原始来源之间的对应关系模糊甚至断裂。此外,部分平台出于界面简洁考虑,也未将引用信息完整呈现给用户。这种"用了但不说"的行为,在涉及医疗、法律、财经等高风险领域时,可能对用户决策产生实质性误导。
对未来 AI 代理设计的启示
这项研究的整体结论,为面向对话式检索优化的 AI 代理和搜索工具指明了几个改进方向。
其一,检索决策机制需要更精细,学会"该出手时才出手",而非盲目追求搜索频率。其二,查询构造策略应当更加透明和可评估,避免因策略缺陷导致检索到低质信息。其三,搜索后端的领域偏好需要被正视,理想的代理应尽可能提供多元、无偏的信息来源。其四,答案生成必须强化引用规范,确保每一个来自外部检索的论断都可追溯。
作为首个系统性刻画对话式 LLM 代理网络搜索全生命周期的研究,其方法论和发现为后续工作奠定了基础。对于普通用户,它也是一个提醒:面对 AI 助手给出的"事实性"回答,保持一份审慎,主动核查关键信息的出处,仍是明智之举。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。