开源AI模型可能随时消失?如何备份你的关键模型

AI生态过度依赖Hugging Face单点,模型随时可能消失,建议用两块硬盘完整备份你最在意的模型。
文章指出,当前AI生态存在一个隐蔽的系统性风险:超过300万个模型集中托管于Hugging Face,一旦这一平台因政策、法律或商业变故出现问题,整个下游生态将面临无法轻易恢复的断裂。尤其值得警惕的是,美国政府内部曾多次讨论封禁中国开源模型,而Qwen、DeepSeek、Kimi等主流开源模型均来自中国。Runway删除账户导致SD 1.5消失、Meta下架LLaMA等已有先例表明,模型消失往往毫无预警。作者给出的应对方案颇为务实:挑选三四个最重要的模型,下载包含分词器、配置、许可证和校验和的完整仓库,以两块硬盘异地存储、定期校验,成本不过一个傍晚。
开源模型正面临一个隐蔽的威胁
海外博主发出的这则警告并非危言耸听:你现在能随手下载的开源AI模型,未来可能突然从平台上消失。核心问题在于整个AI生态过度依赖单一的模型托管平台——Hugging Face。这里托管着超过300万个模型,而大多数AI工具默认从它下载权重文件。
更引人关注的是英伟达已同意收购Hugging Face。黄仁勋在宣布交易时承诺,Hugging Face将保持对整个AI生态的开放,用户无需英伟达硬件也能使用。听起来很合理,但正如去除模型审查的工具Heretic的开发者所指出的,AI世界依赖着一个巨大的"单点故障"——一旦这个中心出问题,替代成本极高,因为模型文件实在太大。
一个佐证:负责归档全球源代码的非营利组织Software Heritage曾评估备份Hugging Face。代码部分约12TB,他们愿意保留;而模型权重高达约40PB,被直接列为"超出范围"。换句话说,全球最大的代码档案库打算保存模型周边的代码,却放弃了模型本身。
Hugging Face 是目前全球最大的 AI 模型托管平台,功能类似 AI 领域的 GitHub,允许研究者和开发者免费上传、分享和下载模型权重、数据集及代码。绝大多数主流 AI 框架(如 Transformers、Diffusers、llama.cpp)都将 Hugging Face 的仓库地址硬编码为默认下载源,这意味着一行 from_pretrained('model_name') 调用背后,流量默认都指向同一个平台。所谓"单点故障"(Single Point of Failure)是系统工程术语,指整个系统中一旦某个节点失效,就会导致全局瘫痪的脆弱环节。AI 生态的独特之处在于模型文件本身的体量——40PB 约等于 4000 万GB,是普通互联网归档项目规模的数十倍,这使得任何备份或迁移计划在物理层面都极为昂贵,从而形成了比软件生态更难以打破的平台锁定。
中国开源模型面临的封禁风险
据Axios报道,在Kimi等模型发布后不久,特朗普政府内部曾重新推动针对中国开源模型的限制。选项包括将中国实验室列入商务部实体清单、发布安全警告要求美国公司远离,以及一项行政令——只有当美国公司能保证模型安全并承担泄露责任时,才可托管中国模型。
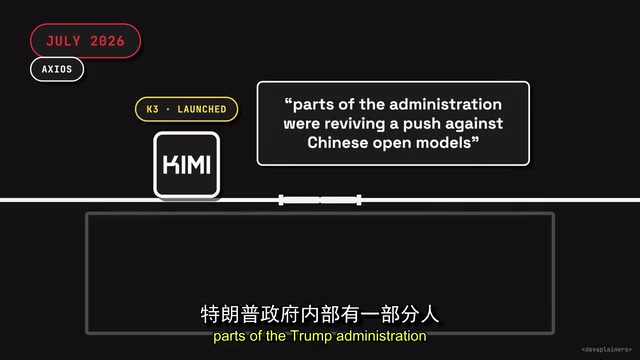
这些措施目前均未落地,且曾在公司内部被否决过一次。但Axios的消息源描述称,领先的AI实验室或其盟友每隔三到五个月就会带着新点子出现,试图禁止开源模型。
几天后,英伟达、Meta、微软、Hugging Face等约20家公司联名致信华盛顿,请求不要限制开放权重。值得对比的是,OpenAI、Anthropic和谷歌DeepMind没有签署。Anthropic随后发布了自己的立场,称从未主张限制开放权重;OpenAI则表示从未倡导封禁,但要求对有能力的模型(无论开源还是闭源)进行强制安全测试。
这里的现实是:Qwen、DeepSeek广告、Kimi、GLM都来自中国。如果你在家里跑模型,一纸针对中国模型的禁令,实际上就是针对你正在用的模型的禁令。禁令无法伸进你的硬盘——已下载的模型离线运行,无人可见。它唯一能关掉的,是那个"下载"按钮。
模型消失早有先例
这类担忧并非空穴来风。Runway曾无预警删除整个Hugging Face账户,Stable Diffusion 1.5也随之消失——而这是AI图像生成领域一大批应用赖以构建的基础模型。Diffusers库把该仓库地址硬编码为默认值,于是当天大量教程和流水线开始报错。Runway的回应是他们不再维护Hugging Face组织。
模型最终得以幸存,只因为很多人手里都有副本,随后有人以新名字建立了镜像。类似地,初代LLaMA以种子形式泄露后,Meta的一封下架函一次性抹掉了GitHub上的下载脚本及其403个分支,但权重依然流传在外。
这揭示了一个关键规律:真正处于危险中的不是知名模型(它们有上百万份副本),而是长尾中的那些——某个人上传、只有十几个人使用的微调版本,去除审查的变体,或是你项目锁定的旧版本。Heretic的索引已列出10个从Hugging Face被移除的模型。当Hugging Face加入开源模型安全合作时,TechCrunch的报道称其站点上6000个无审查模型是"一个巨大的问题",社区则将其解读为真实的预警信号。
像老练的囤货者一样备份模型
你无法保存一切,但可以精准挑选。博主给出的建议很务实:选出你最舍不得失去的三四个模型即可。
估算体积很简单——在完整的16位精度下,模型大约每十亿参数占2GB。所以一个7B模型约14GB,27B约54GB。如果空间允许,保留原始文件,因为你日常运行的量化版本是从中压缩出来的有损副本,就像从RAW照片生成的JPEG。
关键在于备份要完整。仅有权重五年后无法启动,应下载整个仓库,包含分词器、config、聊天模板和生成设置——聊天模板错了,模型能加载,但回答起来像喝了六瓶啤酒。同时保存许可证文件:Apache 2.0的授权是"永久且不可撤销"的,日后仓库改协议也不影响你已持有的副本,而你需要把这份凭证放在同一块盘上。此外,记下确切的版本号和校验和(证明文件未被篡改的指纹),并保留一份当前运行模型的程序,如llama.cpp的构建或容器镜像——模型周边的代码腐坏速度远快于模型本身。
量化(Quantization)是将模型权重从高精度浮点数(如 16 位或 32 位)压缩为低精度整数(如 8 位、4 位甚至更低)的技术,目的是减小文件体积、降低显存占用,使普通消费级 GPU 或 CPU 也能运行大型模型。常见格式包括 GGUF(llama.cpp 使用)和 GPTQ、AWQ 等。量化会带来一定程度的精度损失,类似于将 RAW 照片压缩为 JPEG——日常使用通常无法察觉差别,但信息已是有损的且无法完全还原。文章建议保留原始 16 位权重文件正是出于此考量:保留"底片"意味着未来可以按需重新生成任意精度的量化版本,而仅存量化文件则丢失了这种灵活性。聊天模板(Chat Template)则定义了对话中系统提示、用户消息和模型回复的格式标记,不同模型使用不同的模板规范,加载错误模板会导致模型无法正确理解输入结构,输出质量显著下降。
存储介质怎么选
视频中有位网友把模型烧录到号称可保存千年的蓝光光盘上。但从成本看这并不划算:100GB的档案级光盘每张7到10美元,折合每TB约70到100美元;另一位评论者则选择购买二手服务器硬盘。
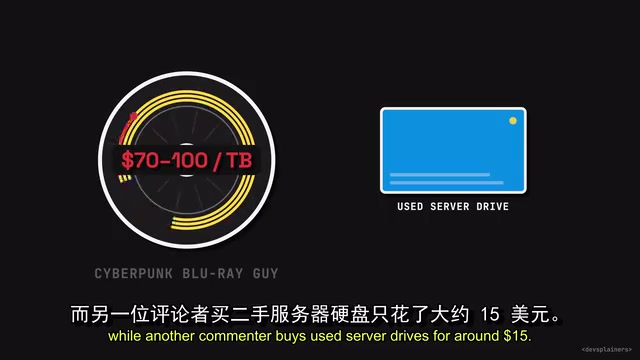
最高赞的技术回复一针见血:能存千年的光盘,如果读取它的驱动器10年就坏了,也没什么用。更实际的方案是:两块普通硬盘放在两个不同地点,每半年用校验和核对一次,足以让人安心。
至于"盗版版的Hugging Face"?它已经存在了。Pirate Face以种子形式列出了超过66.9万个模型,仅限Apache或MIT许可证的那些。而对于微调模型,若只有配方文件(一个约9KB的文本),只要还留着基础模型,重建大约一分钟就能完成;但真正的微调需要数据集和GPU时数,那些才需要完整保留。
校验和(Checksum)是对文件内容计算得出的固定长度哈希值(常见算法如 SHA-256),可用于验证文件在存储或传输过程中是否发生了比特位损坏或被篡改。硬盘在长期存放中存在"静默数据损坏"(Silent Data Corruption)风险,即文件表面上仍然存在,但内容已悄然变化,普通文件管理器无法发现。定期用校验和核对备份文件(工具如 sha256sum 或 md5sum)是判断数据完好性的低成本手段。做种(Seeding)是 BitTorrent 协议中的术语,指用户在下载完成后继续向他人提供上传的行为,做种者越多则文件在网络中越难彻底消失,这也是为何文章建议备份后参与做种——个人存档行为同时转化为分布式保存网络的一个节点。
结论:一个傍晚就能解决的保险
博主的判断相对乐观:完全禁止开放权重不太可能发生,因为太多大公司离不开它,英伟达尤其如此,而且你无法召回已经存在于上百万块硬盘上的文件。
但真正的风险在于——迄今为止每一次模型消失都毫无预警,往往只源于一个被删的账户或一封法律信函。而修复这个隐患的成本,不过是两块硬盘和一个傍晚:挑出你在意的模型,下载完整仓库,放到两块盘上,然后做种共享。最坏的情况也不过是什么都没被禁,而你拥有了一个断网时仍能工作的编程助手。
相关推荐

LTT的AMD终极升级:5000美元花在哪?从NAS到纹身机
LTT的AMD终极升级系列把5000美元花在了NAS装机、iPad Air绘图和专业纹身机上。文章梳理Ryzen 5 8500G的NAS选型、装机避坑要点与非典型硬件配置,适合DIY NAS入门参考。

LTT Store新品曝光:游戏玩家包、全棉T恤与DMS联名耳机
LTT Store 曝光多款新品:带 RFID 屏蔽和掌机收纳位的游戏随身包、回归纯棉的经典黑T恤,以及与 DMS 联名打造的高音质耳机。了解这批周边产品的设计亮点与定位。

AirPods 5 评测:129美元买到越级降噪体验
AirPods 5 评测:129美元起售,入门款也标配出色的主动降噪、全天续航与更小充电盒。详解其降噪、音质、续航短板及对 Android 的不友好,附基础款与升级款选购建议。