让Qwen跑63小时攻克黎曼猜想:一次开源模型自主推理实验
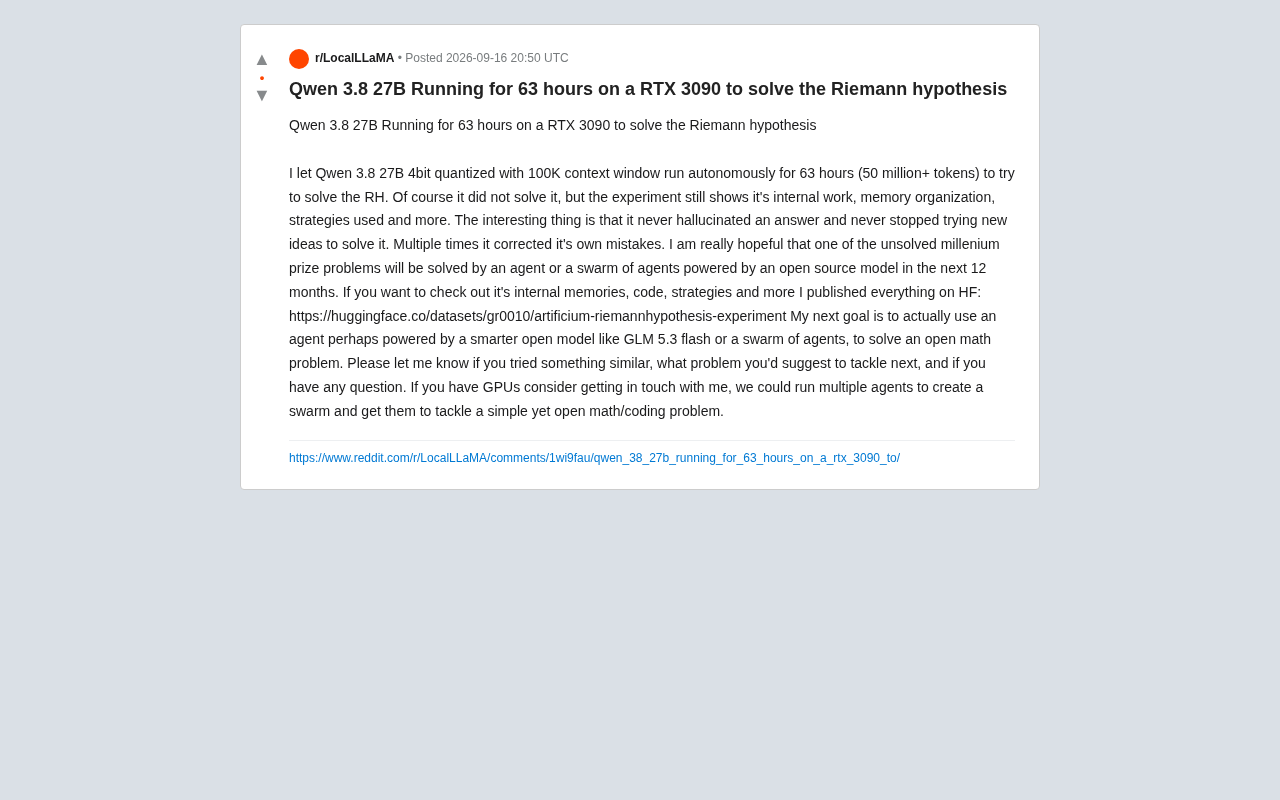
开发者用单卡RTX 3090让Qwen 3.8 27B自主运行63小时挑战黎曼猜想,未果但展示了开源模型的长程推理稳定性。
一位开发者将Qwen 3.8 27B(4bit量化,100K上下文)部署在单张RTX 3090上,令其自主运行63小时、生成超5000万tokens,目标是尝试证明黎曼猜想。模型最终未能破解这一千禧年难题,但实验过程呈现了三项值得关注的特性:全程零幻觉答案、持续探索新策略、多次主动自我纠错。完整数据已开放至Hugging Face。实验者认为真正价值不在结果而在方法论——这是一次对开源模型长时间自主推理稳定性的压力测试,其记录的记忆组织与策略演化数据对AI Agent研究具有参考价值。下一步计划是引入更强模型或多智能体集群,协作攻克规模更适中、答案可验证的开放问题。
一个大胆的实验:63小时、5000万tokens
一位Reddit用户分享了一个颇具野心的实验:他让Qwen 3.8 27B(4bit量化版本,配备100K上下文窗口)在一张RTX 3090显卡上连续自主运行了63小时,生成超过5000万tokens,目标是尝试证明数学界最著名的未解难题之一——黎曼猜想(Riemann Hypothesis)。
结果并不意外:模型没有解出这个千禧年难题。但实验者认为,这次尝试的价值并不在于最终答案,而在于观察模型在长时间自主运行状态下的内部工作机制、记忆组织方式和策略演化过程。
黎曼猜想(Riemann Hypothesis)由德国数学家波恩哈德·黎曼于1859年提出,核心内容是:黎曼ζ函数所有非平凡零点的实部均等于1/2。这个命题看似简洁,却与素数分布规律深度关联,是解析数论的基石之一。克雷数学研究所将其列为七大千禧年难题之一,悬赏100万美元。迄今为止,已有数以千计的职业数学家尝试攻克,均未成功。它之所以极难,在于需要全新的数学框架而非已有工具的延伸——这也正是AI暴力推理难以企及的根本原因。
Qwen 3是阿里巴巴通义实验室发布的开源大语言模型系列,具备混合推理模式(可切换"思考模式"与"非思考模式")和强化学习后训练能力。4bit量化是一种模型压缩技术,通过将模型权重从16/32位浮点数压缩为4位整数来大幅降低显存占用,使27B参数模型得以在单张消费级GPU(如RTX 3090的24GB显存)上运行,代价是轻微的精度损失。100K上下文窗口则意味着模型单次可"记住"约10万个token的历史信息,是支撑此次长时间自主推理的关键硬件条件之一。
实验中最值得关注的几个观察
实验者提到了几个让人意外的现象。首先是模型在长达63小时的运行中从未编造出一个虚假答案——这在动辄产生幻觉的大语言模型中并不常见。其次,模型从未停止尝试新思路,而是在推理链条中不断切换策略、探索不同的证明路径。
更有意思的是,模型多次主动纠正了自己的错误。这种自我修正能力,正是当前AI Agent研究中最受关注的方向之一。它意味着模型在超长上下文和自主循环的环境下,具备了某种程度的"元认知"——能够回看自己的推理并判断其中的漏洞。
实验者将全部过程数据公开发布在了Hugging Face上,包括模型的内部"记忆"、生成的代码、采用的策略等完整记录,供社区研究和复现。
元认知(Metacognition)在认知科学中指"对思维本身的思维",即个体监控、评估并调整自身认知过程的能力。在大语言模型领域,这一概念被借用来描述模型回溯自身推理链、识别逻辑矛盾并主动纠偏的行为。传统LLM的自回归生成机制决定了它本质上是逐token向前预测,缺乏天然的"回头看"能力。Qwen 3等具备显式思维链(Chain-of-Thought)和强化学习训练的模型,通过在训练阶段奖励自我纠错行为,使得模型在生成过程中能够对已输出内容进行质疑和修正——这是当前Agent可靠性研究的核心突破方向之一。
为什么解不出,却仍有意义
需要理性看待的是,黎曼猜想是数学界公认的最难问题之一,属于克雷数学研究所设立的七大千禧年难题。这类问题需要的是全新的数学洞见,而非算力堆砌或token数量的暴力枚举。一个27B参数的开源模型在63小时内解决它,从概率上几乎不可能。
但这个实验的真正价值在于方法论层面的探索:它展示了当前开源模型在长时间自主运行下的稳定性边界。5000万tokens的连续生成不崩溃、不陷入无意义循环、不产生幻觉答案,本身就是对模型鲁棒性的一次压力测试。
对于研究AI Agent的开发者来说,这类数据集是宝贵的——它记录了模型如何组织记忆、如何在无人干预下规划任务、如何在遇到死胡同时重新调整方向。这些正是构建可靠自主智能体所需要理解的核心问题。
下一步:智能体集群与更强模型
实验者对未来12个月内"由开源模型驱动的智能体或智能体集群解决某个千禧年难题"表达了相当乐观的态度。虽然这个预期或许过于激进,但其背后的技术方向值得关注。
他的下一步计划是使用更强的开源模型(提到了类似GLM系列的更聪明模型),或者组建**智能体集群(swarm of agents)**来协同攻克一个"简单但仍然开放"的数学或编程问题。这种从单一Agent转向多Agent协作的思路,符合当前Agent研究的主流趋势——通过分工、辩论和交叉验证来提升整体推理质量。
实验者还向社区发出了协作邀请:如果有闲置GPU资源,可以联合运行多个Agent形成集群,共同尝试解决一个可验证的开放问题。
智能体集群(Agent Swarm / Multi-Agent System)是指多个AI智能体并行或协同工作的架构,各Agent可承担不同子任务(如文献检索、公式推导、代码验证),通过共享记忆或消息传递相互校验结果。与单一Agent相比,集群架构的优势在于:可并行探索多条证明路径、通过"辩论"机制过滤错误推理、以及利用分工降低单个Agent的上下文压力。AutoGen、CrewAI、LangGraph等框架已提供了构建此类系统的工具链。然而,多Agent系统也引入了新的复杂性:Agent间的通信开销、一致性维护以及错误传播问题,均是当前研究的活跃难点。
对开源AI社区的启示
这个实验虽然是个人化的尝试,却折射出开源AI社区的一种典型探索精神:用有限的硬件(单张RTX 3090)和开源模型,去挑战看似不可能的任务,并把全部过程透明公开。
从实用角度看,与其期待模型"证明黎曼猜想",不如把这类长时间自主运行实验视为评估模型自主推理能力的测试平台。选择一个规模适中、答案可验证的开放问题(而非黎曼猜想这样的世纪难题),可能会产生更有实际意义的结果。
无论最终能否有智能体解出千禧年难题,这类实验都在推动我们理解:当把一个模型"放养"数十小时,它究竟能走多远、又会在哪里停下。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
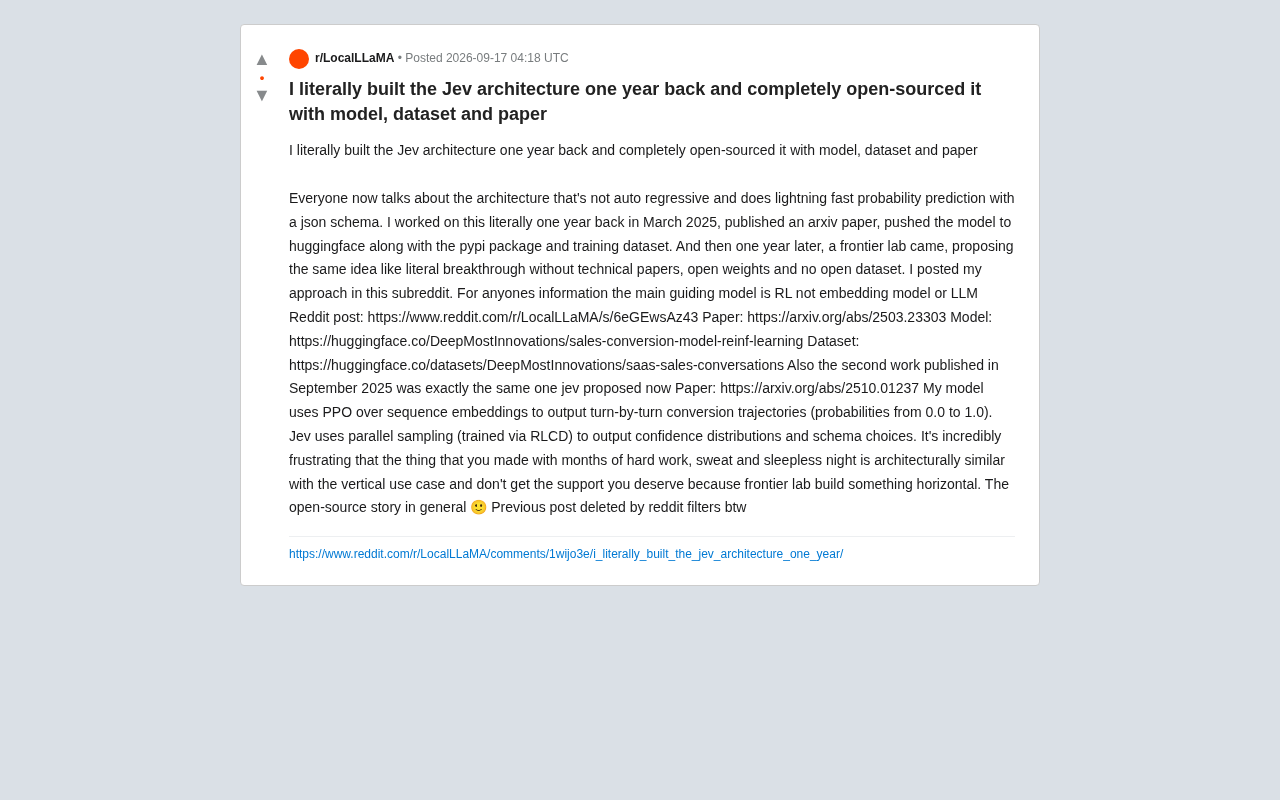
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
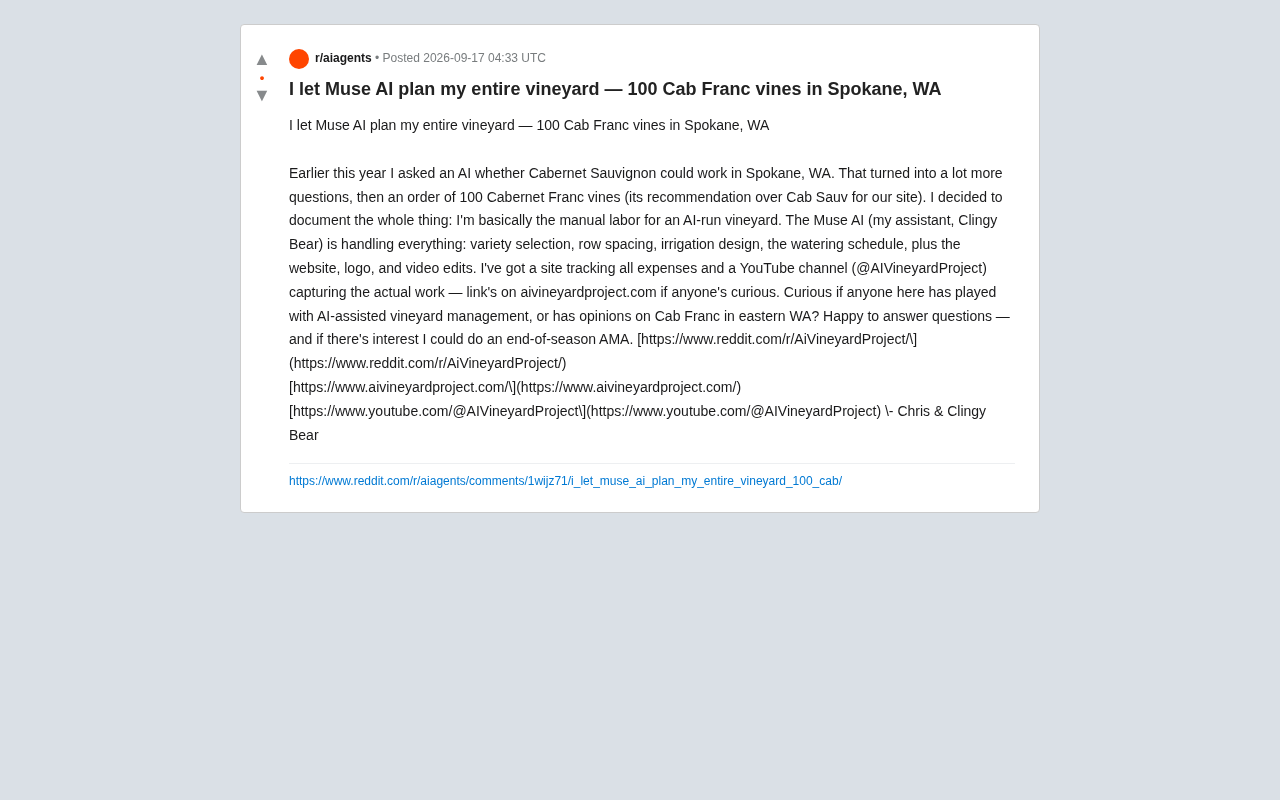
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。