科研自动化Agent实测:零样本复现NeurIPS顶会论文全流程

当科研复现进入全自动时代
论文复现,一直是科研工作中最耗时也最考验耐心的环节。从检索文献、理解方法,到搭建环境、跑通代码、验证结果,往往需要研究者投入数天甚至数周的精力。而如今,一个名为 Klaus Goh 的科研自动化 Agent,正试图把这个繁琐的闭环压缩成一次「一键交付」。
据 B 站 UP 主的实测演示,Klaus Goh 被定位为「全球首个全流程科研自动化 Agent」,能够独立完成科研复现的完整链路:论文检索、环境搭建、代码实现、实验验证到结果分析,最终直接交付一份完整的复现报告与可复现的实验成果。这次实测的对象,是 IBM 发表于 NeurIPS 的时序预测前沿工作——TTM(Tiny Time Mixers)。
复现目标:极小模型挑战大模型
TTM 论文的核心思想
TTM 是时间序列预测领域一个颇具颠覆性的成果。它的核心思路,是用一个极小的 MLP Mixer 架构来做时间序列的零样本预测。
MLP Mixer 架构的由来与演进:MLP Mixer 最初由 Google Research 于 2021 年提出,用于图像识别任务,论文发表于 NeurIPS 2021。它的核心创新在于彻底摒弃了 Transformer 中计算复杂度为 O(n²) 的自注意力机制(Self-Attention)——Self-Attention 需要序列中每个位置与其他所有位置进行两两交互计算,导致计算量随序列长度的平方级增长,在长序列场景下资源消耗极为可观。MLP Mixer 转而通过两种轻量级的全连接层(MLP)来捕捉数据的全局与局部关系:其中一种 MLP 沿「通道」维度混合特征,负责捕捉不同特征维度之间的关联;另一种 MLP 沿「位置」维度混合特征,负责捕捉序列中不同时间步之间的依赖。这种「双向混合」的设计使计算复杂度降至线性,极大降低了训练和推理的资源消耗。TTM 将这一思路迁移至时间序列领域,充分利用了时序数据在通道(多变量)维度和时间维度上天然存在的结构性规律——例如不同传感器之间的相关性、时序数据的周期性——从而在参数量极少的前提下仍能有效建模复杂的时序模式,实现参数效率与预测性能的双重优化。值得一提的是,MLP Mixer 在图像领域的成功已表明:注意力机制并非深度学习的唯一有效归纳偏置,「用更简单的线性操作替代复杂的非线性交互」在特定结构化数据上同样奏效,TTM 正是这一设计哲学在时序领域的延伸验证。
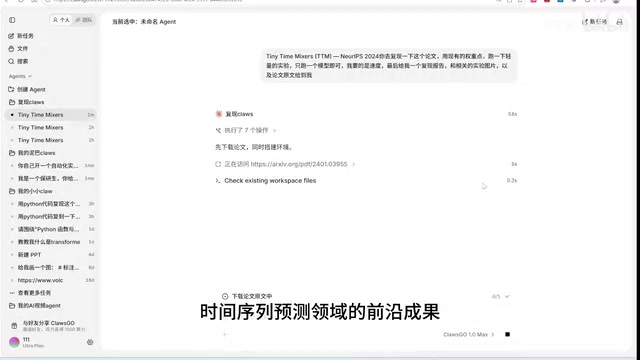
在大模型军备竞赛愈演愈烈的今天,时序预测领域也不例外——TimesFM、PatchTST 等模型动辄拥有数十亿参数,对算力要求极高。而 TTM 反其道而行之,模型参数仅有约 0.8M(百万级),文件大小只有三兆字节,甚至无需 GPU,在普通 CPU 上就能顺畅运行。
零样本预测的技术含义与价值:零样本预测(Zero-shot Forecasting)指模型在未见过目标数据集的情况下,直接利用预训练权重进行推理,无需在目标域上进行任何微调(Fine-tuning)。这一能力的核心依赖于预训练阶段对海量多样时序数据的充分学习——TTM 的预训练语料涵盖了能源、交通、气象、金融等多个领域的时序数据集,使模型习得了跨域通用的时序规律表示。这一过程与大语言模型的「预训练-微调」范式高度类似:通过海量异质数据的预训练,模型形成对底层规律的通用编码能力,再在特定下游任务上泛化,区别仅在于零样本场景下省去了后者的微调步骤。在时序预测领域,零样本能力尤为珍贵:许多工业物联网、医疗监测等实际应用场景中,目标域的标注数据极为稀缺,或数据分布随季节、设备老化等因素持续漂移,传统的监督学习方法难以泛化。TTM 能以 0.8M 的超小参数量实现有竞争力的零样本预测表现,意味着其预训练策略在时序规律的压缩编码与跨域泛化上达到了极高的参数效率,也为后续「小型基础模型」(Small Foundation Models)的研究方向提供了有力的实证支撑。
这种「小而美」的设计,直接指向了一个极具价值的应用场景:边缘设备上的时间序列预测。当一个模型可以在资源受限的终端上部署时,它的落地空间被大大拓宽。
Klaus Goh 的复现全过程
第一步:从论文到环境,精准锁定关键信息
拿到复现 TTM 的任务后,Klaus Goh 展现出的第一个能力,是对论文关键信息的快速定位。它读完论文后,立即抓取了三个核心要素:模型架构、预训练权重、评测基准,并一键锁定了 Hugging Face 上的官方仓库。

科研自动化 Agent 的技术架构与演进路径:Klaus Goh 这类 Agent 通常基于大语言模型(LLM)的工具调用(Tool Use)与任务规划(Planning)能力构建,结合代码执行沙箱(如 Jupyter 内核或 Docker 容器)、文件系统访问、arXiv/Semantic Scholar 学术检索、GitHub/Hugging Face API 等外部工具接口,形成「感知(读取论文与代码)→规划(分解复现步骤)→执行(调用工具运行代码)→反馈(分析错误并修正)」的完整闭环。与早期基于规则的 RPA(机器人流程自动化)不同,LLM 驱动的 Agent 能够理解非结构化的论文文本,自主将「复现 TTM 论文」这一高层目标分解为具体的可执行子任务序列,并在遭遇环境报错、依赖冲突时动态调整策略。这种动态容错能力来自 LLM 对代码语义和错误信息的理解,而非预设的异常处理规则——本质上是将「调试」这一原本依赖专家经验的认知任务转化为 LLM 可自主推理的标准化流程。其实现路径与学术界陆续提出的 AI Scientist(Sakana AI)、SWE-Agent(普林斯顿)、AutoML-Agent 等系统思路相近,但更专注于科研复现这一特定领域,代表了 AI Agent 从「对话式辅助」向「具身自主执行者」演进的前沿探索方向。
这一步实际上是复现工作中最容易踩坑的地方——找错权重、用错基准、环境依赖冲突,都可能让后续实验前功尽弃。Agent 能够自动定位官方资源并搭建环境,意味着它对科研生态(论文、代码仓库、模型托管平台)之间的关联已具备实用级的理解能力。
第二步:数据处理与零样本推理
环境就绪后,Klaus Goh 从 ETT-1 数据集的加载、标准化预处理,到加载预训练模型,全部自动完成。随后启动零样本推理。

实测数据显示,零样本推理仅用 10 秒就完成了 2700 多个预测点的计算。这种速度一方面得益于 TTM 模型本身的轻量设计,另一方面也印证了「CPU 可跑」的论文宣称并非空谈。
第三步:结果验证——小模型跑赢大模型
最关键的是结果验证环节。实测复现的结论与论文核心一致:TTM 在 ETT-1 数据集上的 MSE 仅为 0.363,超越了 TimesFM、PatchTST 等一批大模型,而它的参数量只有 0.8M。
ETT 数据集与评测指标的行业背景:ETT(Electricity Transformer Temperature,电力变压器温度)数据集是时序预测领域最广泛使用的开放基准之一,由华中科技大学于 2021 年随 Informer 论文(AAAI 2021 最佳论文)一同发布。该数据集记录了中国某地区两个县级电站的油温及六路电力负载数据,其多变量、长序列的特性使其成为检验模型长期依赖建模能力的标准测试场。ETTh1 以小时为粒度采样,共包含约 17,420 个时间步,覆盖约两年的连续记录,被划分为训练集、验证集和测试集三部分,评测协议在学界已高度统一,确保了不同论文结果之间的直接可比性。MSE(均方误差,Mean Squared Error)是衡量预测精度的核心指标,计算预测值与真实值之差的平方均值,数值越低代表预测越准确。值得注意的是,MSE 对大误差有平方级惩罚,因此在异常值较多的工业数据场景下尤为敏感,TTM 能在此指标上保持优势,说明其预测鲁棒性同样出色。TTM 的 0.363 MSE 显著低于 TimesFM(Google 发布,参数约 2 亿,约为 TTM 的 250 倍)和 PatchTST(基于 Transformer 的时序专用模型)在相同 ETTh1 评测协议下的表现,在控制了评测条件后构成具有参考价值的性能超越,对业界评估「模型规模与性能的缩放定律」(Scaling Law)在时序预测领域的适用边界具有重要意义——它表明,当数据具有足够强的内在结构时,精心设计的归纳偏置(Inductive Bias)可以部分替代参数规模带来的拟合能力。

换句话说,一个三兆字节的模型,在标准评测基准上打败了参数量高出数个量级的对手。这一结论若能被广泛复现,将对时序预测领域的技术路线选择产生实质影响——边缘侧部署不再是算力受限下的妥协,而可能是更优的工程解法。
交付物:一份完整的复现报告
整个复现闭环结束后,Klaus Goh 交付了一套相当完整的成果:
- 完整的复现报告
- 全部可运行的 Python 代码
- 零样本预测对比图
- 误差指标对比图
- 多通道可视化图
- 可直接阅读的论文原文
从论文检索、实验跑通,到报告输出、图表合成,整个流程由 Agent 独立完成。这已经不只是「跑代码」,而是模拟了一名研究助理从读论文到写报告的完整工作流。
一点冷静的观察
提一嘴,本文基于单一来源的实测演示,展示的是一个「结果确定、路径清晰」的复现任务——TTM 有官方开源仓库、公开数据集与明确的评测基准,对 Agent 而言相对「友好」。
真正的科研复现挑战,往往出现在论文细节缺失、代码未开源、超参数需要反复调试的情况下。科研自动化 Agent 能否在这些「非理想」场景中同样稳健,仍有待更多复杂案例的检验。这一局限性与当前 AI Agent 领域的普遍瓶颈一脉相承:在任务空间高度受限、目标明确、反馈信号清晰的场景下,Agent 表现优异;而当任务边界模糊、需要开放式探索时,其规划能力和容错机制仍面临显著挑战。
不过,即便如此,Klaus Goh 的实测依然揭示了一个重要趋势:科研自动化正从「辅助工具」向「独立执行者」演进。当 AI 能够端到端完成一篇顶会论文的复现,研究者的角色或许将从「动手实现」逐步转向「提出问题与判断价值」。这,可能才是 AI 科研自动化带来的更深远变革。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。