KV缓存该放在哪?GPU/CPU/SSD分层放置策略实测解析
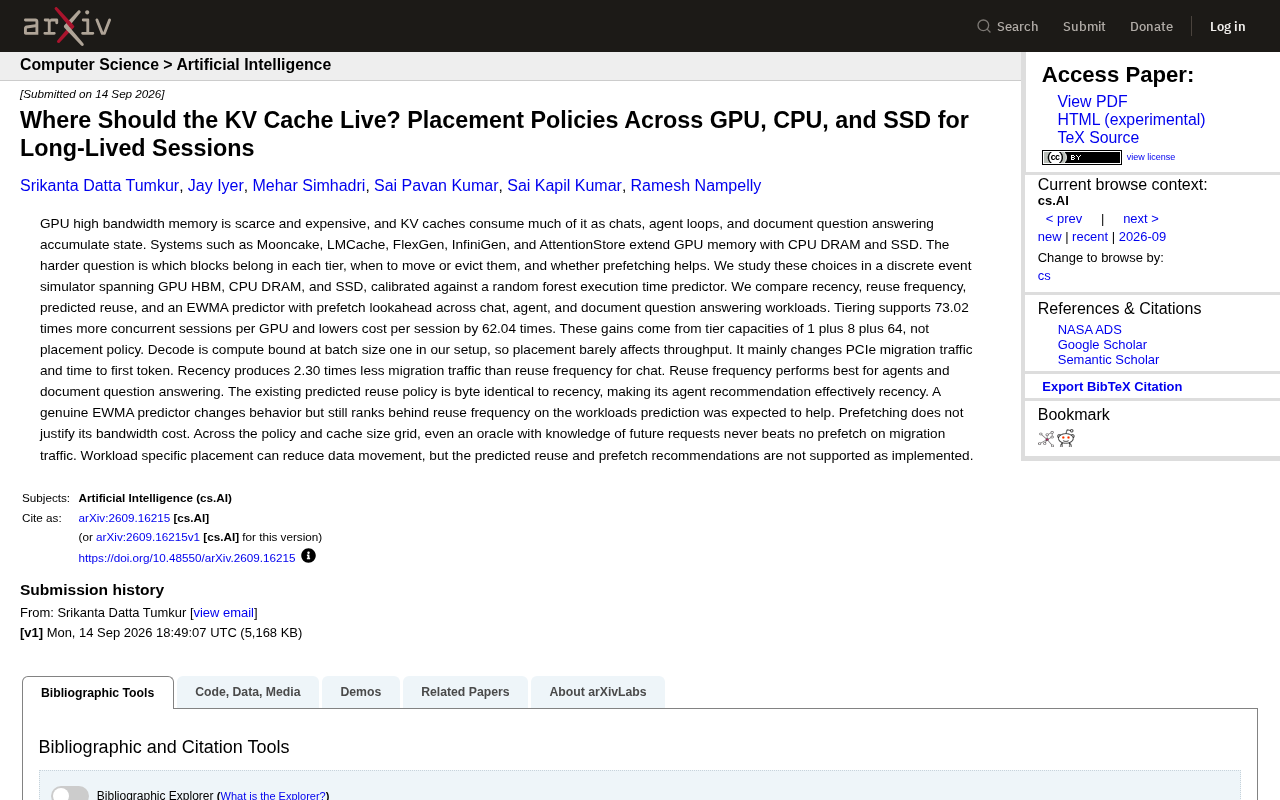
研究发现KV缓存分层存储的核心价值在于容量扩展,而非精巧的放置策略或预取机制。
这篇arXiv研究通过离散事件模拟器系统评估了大模型长会话推理中KV缓存的分层存储策略。核心结论是:跨GPU HBM、CPU DRAM、SSD的三级存储体系可将单GPU并发会话数提升73倍、成本降低62倍,但这些收益绝大部分来自三级存储容量的叠加效应,而非放置算法的精巧程度。在策略选择上,聊天场景适合基于近期访问的Recency策略,Agent和文档问答场景更适合复用频率策略;而"预测复用"策略在实现层面与Recency等价,EWMA预测器也无法超越简单的频率策略。更反直觉的是,即便是拥有未来信息的Oracle预取器,也因额外带宽消耗而无法在迁移流量上胜过不预取方案,预取这一被寄予厚望的优化手段被证明得不偿失。
长会话场景下的大模型推理,正面临一个越来越棘手的资源难题:GPU的高带宽显存(HBM)稀缺且昂贵,而随着对话轮次累积、Agent循环执行、文档问答不断产生上下文状态,KV缓存(KV Cache)正在吞噬大量宝贵的显存空间。一篇新发布的arXiv研究(arXiv:2609.16215v1)系统性地探讨了一个被业界长期忽视的核心问题:这些KV缓存块究竟应该存放在哪一层存储介质上?
分层存储:显存扩展的现实路径
目前已有不少系统尝试用CPU DRAM和SSD来扩展GPU显存的容量上限,代表性方案包括Mooncake、LMCache、FlexGen、InfiniGen以及AttentionStore。这些系统的共同思路是构建一个跨越GPU HBM、CPU DRAM、SSD的多级存储体系,把无法全部塞进显存的KV缓存下沉到更廉价、容量更大的介质中。
但真正困难的问题并不在于"能不能扩展",而在于放置策略(Placement Policy):哪些缓存块该留在GPU,哪些该下放到CPU或SSD?什么时候迁移、什么时候淘汰?预取(Prefetch)到底有没有用?这些决策直接影响系统的迁移开销和响应延迟。
KV缓存(Key-Value Cache)是大模型推理中的核心数据结构。Transformer架构在计算注意力时,每个Token都需要访问序列中所有历史Token对应的Key和Value向量。若每次生成新Token都重新计算这些向量,计算量将随序列长度平方级增长。KV缓存通过将已计算的K/V向量存储下来供后续步骤直接读取,将复杂度降低为线性,但代价是显存占用随上下文长度线性膨胀。以LLaMA-3 70B为例,在FP16精度下,单条32K上下文的KV缓存可达数十GB,远超单卡显存容量。这正是分层存储方案兴起的根本驱动力——GPU HBM容量有限(通常80GB上下),而长会话、多轮Agent、大文档问答场景产生的累积KV缓存可能是其数倍乃至数十倍。
用离散事件模拟器验证策略
研究者搭建了一个覆盖GPU HBM、CPU DRAM、SSD三级存储的离散事件模拟器,并用一个随机森林(Random Forest)执行时间预测器对其进行校准,以保证仿真结果贴近真实运行时表现。
在这个框架下,他们对比了四种放置策略:基于近期访问(Recency)、基于复用频率(Reuse Frequency)、基于预测复用(Predicted Reuse),以及一个带预取前瞻的EWMA(指数加权移动平均)预测器。测试覆盖了三类典型工作负载——聊天对话、Agent循环、文档问答,力求还原真实业务中的多样化访问模式。
离散事件模拟(Discrete Event Simulation,DES)是系统性能研究中的经典方法论。它将系统行为抽象为一系列按时间顺序发生的离散事件(如"KV块迁移开始""解码步骤完成"),通过推进事件队列来模拟系统在真实负载下的运行状态,而无需实际部署全套硬件。相比真机实验,DES的优势在于:可以快速遍历大量策略与参数组合(本研究中涉及4种策略×多种缓存容量配比×3类工作负载的组合网格);可以方便地引入"Oracle预取器"这类在真实系统中不可能存在的理想基线进行上界分析。其局限性在于模型精度依赖校准质量,这也是研究者额外引入随机森林执行时间预测器进行校准的原因——确保仿真的延迟与迁移开销数字与真实GPU推理系统的测量值对齐。
分层带来的收益,主要来自容量而非策略
实验数据相当亮眼:采用分层存储后,单张GPU可支持的并发会话数提升了73.02倍,每会话成本降低了62.04倍。这个数字足以说明分层存储对长会话推理的价值。
但研究给出了一个反直觉的关键结论:这些收益主要来自于容量的堆叠(1 + 8 + 64的三级容量配比),而非精巧的放置策略。在他们的实验设置中,批大小为1时的解码(Decode)阶段是计算密集型(Compute Bound)的,因此放置策略几乎不影响吞吐量。放置策略真正改变的是PCIe迁移流量和首Token时间(Time to First Token, TTFT),而非整体性能上限。
不同工作负载,最优策略并不相同
研究在策略层面给出了细致的对比。对于聊天场景,基于近期访问的Recency策略产生的迁移流量比复用频率策略少2.30倍,表现更优;而对于Agent和文档问答场景,复用频率(Reuse Frequency)策略则是最佳选择。
更值得玩味的是对现有"预测复用"策略的审视。研究者发现,现有的Predicted Reuse策略在字节层面(byte identical)与Recency完全一致——也就是说,它对Agent场景的推荐实际上就是Recency。而一个真正意义上的EWMA预测器虽然改变了行为,但在那些本被寄予厚望的"预测能帮上忙"的工作负载上,其表现仍然落后于简单的复用频率策略。
预取:得不偿失的带宽消耗
预取一直被视为隐藏迁移延迟的手段,但这项研究给出了否定性的证据。在整个策略与缓存大小的组合网格上,即便是一个拥有"未来请求先知"能力的Oracle预取器,在迁移流量指标上也从未战胜"不做预取"的方案。换言之,预取所额外消耗的带宽成本,并不足以换来相应的收益。
预取(Prefetch)在存储系统设计中通常是降低读延迟的利器:提前将数据从慢速介质搬运到快速介质,使得数据真正被需要时已在"近处"等候。在KV缓存场景中,预取的理想情形是:在某个会话的下一轮请求到达前,预判其所需的KV块并提前从SSD或DRAM加载到GPU HBM,从而消除迁移等待时间对首Token延迟(TTFT)的影响。然而本研究的否定结论揭示了一个关键的带宽经济学问题:预取不可避免地带来"无效搬运"——预取进来但最终未被使用的数据占用了宝贵的PCIe或内存带宽,而这些带宽本可服务于真正必要的迁移请求。在解码阶段已是计算密集型、带宽并非瓶颈缓解手段的前提下,预取的边际收益极为有限,反而因额外流量加剧了带宽竞争,导致即便是信息完备的Oracle预取器也无法实现净收益。
对系统设计者的启示
这项研究的价值在于对既有假设的祛魅。它明确指出:面向特定工作负载的放置策略确实能够减少数据移动量,但"预测复用"和"预取"这两项在业界颇受关注的推荐做法,按其当前实现方式而言,并没有得到实验支持。
对于正在构建长会话推理基础设施的团队,这意味着几点务实建议:优先扩充分层容量以获取最大收益;针对聊天场景可采用Recency策略降低迁移流量,针对Agent和文档问答则倾向复用频率策略;对预测复用与预取这类复杂机制保持审慎,先验证再投入。在显存成本高企的当下,把工程精力放在真正见效的地方,或许比追逐花哨的预测算法更有意义。
相关推荐
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。