LangChain Text Splitters 1.1.3 发布:依赖升级与多语言分割修复

langchain-text-splitters 1.1.3 修复多语言分隔符错误、强化 JSON 类型校验并恢复惰性导入,是一次低风险稳定性维护版本。
langchain-text-splitters 1.1.3 是 LangChain 文本分割核心组件的一次维护性发布,主要面向 RAG 应用开发者。本次更新修复了 Kotlin、Rust、Haskell、C#、Elixir 等多个编程语言的分隔符定义错误,使代码文件能按函数、类等语法边界更合理地切分;为 RecursiveJsonSplitter 新增了入口类型校验,非法输入将直接抛出 TypeError;并恢复了对 torch、nltk 等重型可选依赖的惰性导入机制,降低包启动开销。此外,版本对 tornado、urllib3、lxml 等网络与解析库进行了大量安全相关的依赖升级,并将类型检查工具从 mypy 迁移至 ty。整体无破坏性 API 变更,推荐生产环境跟进。
LangChain 生态的核心文本处理组件 langchain-text-splitters 发布了 1.1.3 版本。这个看似常规的补丁版本,背后反映出 LangChain 团队在依赖安全、代码质量和多语言支持上的持续打磨。对于构建 RAG(检索增强生成)应用的开发者来说,文本分割器是数据预处理链路中极为关键的一环,任何稳定性改进都值得关注。
文本分割器在 LangChain 中的角色
langchain-text-splitters 负责将长文档切分成适合嵌入模型和大语言模型上下文窗口的文本块。无论是递归字符分割(RecursiveCharacterTextSplitter)、按代码语言结构分割,还是对 JSON 结构化数据的处理,这个包都是 LangChain RAG 流水线中不可或缺的底层工具。
分割质量直接影响检索效果:切得太碎会丢失上下文语义,切得太粗又会稀释检索精度。因此该库对各类编程语言和文档格式的分隔符定义,直接决定了下游应用的检索召回表现。1.1.3 版本正是围绕这些细节做了多处修复。
RAG(检索增强生成)是目前主流的大语言模型落地范式:先将外部知识库切分成文本块并编码为向量存入向量数据库,用户提问时检索出相关块后拼入提示词,再由模型生成回答。文本分割是这条链路的第一道工序,其质量对整个系统的天花板有决定性影响。langchain-text-splitters 提供的 RecursiveCharacterTextSplitter 是最常用的通用分割器,它按段落、句子、单词等层级递归尝试切分,尽量在不超过目标块大小的前提下保留语义完整性。对于代码文件,则需要按语言语法(函数定义、类声明、代码块边界)定义分隔符,才能避免把一个函数切成两半——这正是本次修复所针对的问题所在。
本次版本的核心修复
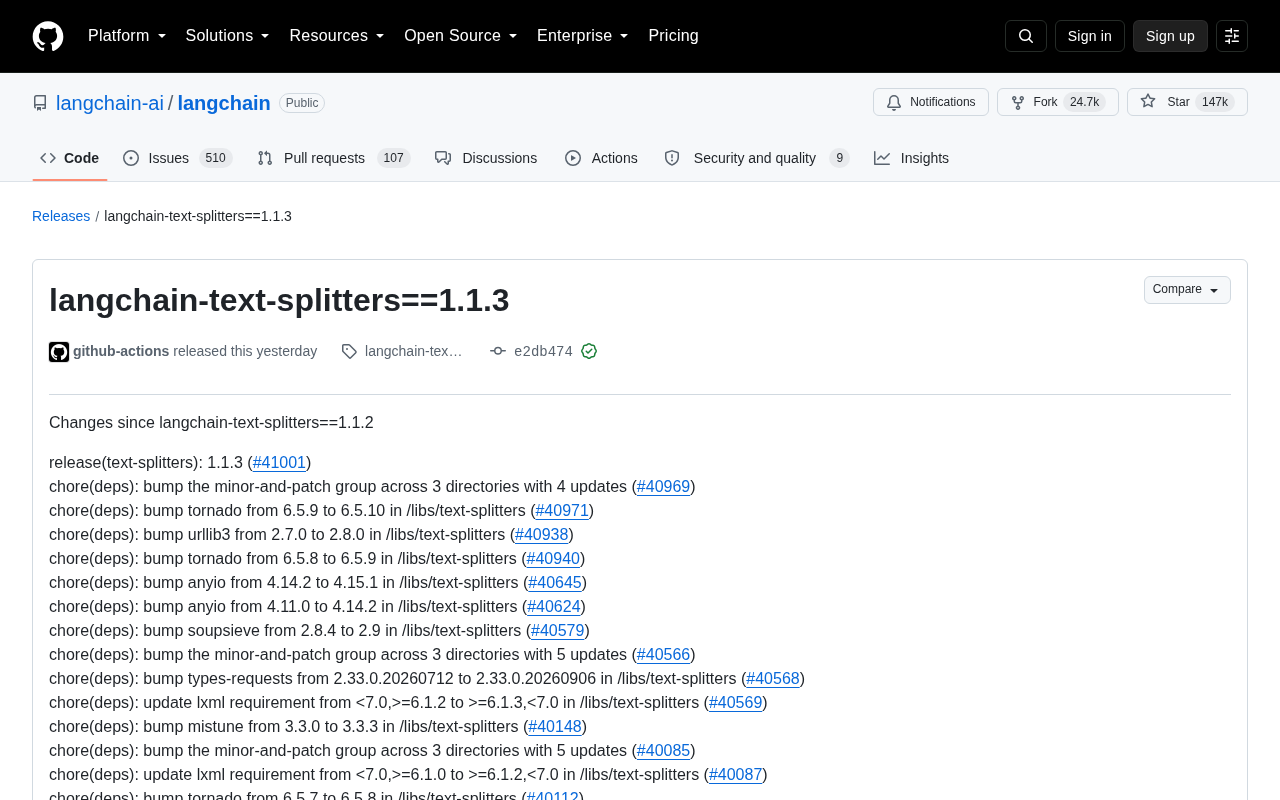
从提交记录看,1.1.3 相对 1.1.2 包含几类实质性的功能修复,而非单纯的依赖更新:
多语言分隔符修正
版本修复了多个编程语言分隔符定义错误:
- 移除了 Kotlin、Rust 和 Haskell 中无效及重复的分隔符(#37039)
- 移除了 C# 和 Elixir 中错误的分隔符关键字(#37037)
这类修正直接影响基于语言结构的代码分割效果。错误或重复的分隔符可能导致代码块被不合理地切断,破坏函数、类等语法单元的完整性。对于用 LangChain 做代码库检索、代码问答的场景,这些修复能带来更合理的分块结果。
JSON 分割器的类型校验
另一处值得关注的修复是针对 RecursiveJsonSplitter:当输入为非字典且无法转换的类型时,现在会主动抛出 TypeError(#39238)。这是一种防御性编程的改进——与其让错误在后续处理中以难以定位的方式暴露,不如在入口处明确报错,帮助开发者更快排查数据格式问题。
可选依赖的惰性导入
版本还恢复了对重型可选依赖的惰性导入(lazy imports)机制(#35469)。文本分割器可能依赖 torch、nltk、lxml 等体量较大的库,惰性导入意味着只有在真正使用相关功能时才加载这些依赖,从而降低包的启动开销和内存占用,对轻量级部署场景尤为友好。
惰性导入(Lazy Import)是 Python 中一种延迟模块加载的模式:在模块顶层不执行 import torch 等语句,而是在真正调用相关功能的代码路径上才触发导入。其好处在于,仅安装了 langchain-text-splitters 基础包但未安装 torch 的用户,在使用不依赖 torch 的分割器时不会因导入失败而报错,也不会在进程启动时承受 torch 数百毫秒的初始化开销。这对于 Serverless 函数、容器冷启动等对启动时延敏感的部署场景尤为重要。1.1.2 版本中该机制被意外回退,1.1.3 将其恢复,属于对工程体验的关键修补。
大量依赖升级与安全维护
本次发布中占比最高的是依赖版本升级(chore(deps)),涉及数十个 PR。这些升级覆盖了直接依赖与开发工具链:
- 安全相关组件:tornado、urllib3、anyio、mistune、lxml 等多次升级,这类网络与解析库的更新往往伴随安全补丁
- 核心计算库:torch 从 2.9.1 一路升级,nltk 升级到 3.10.0
- 工具链变更:用
ty替换mypy进行类型检查(#38658),并在 monorepo 中统一类型检查配置
持续的依赖维护是开源项目健康度的重要指标。LangChain 通过 Dependabot 自动化地跟进上游安全更新,并对版本边界做了加固(#37510),这降低了下游用户因依赖链漏洞而暴露的风险。
对开发者的实际意义
如果你的项目涉及以下场景,升级到 1.1.3 是推荐的:
- 使用 Kotlin、Rust、Haskell、C#、Elixir 代码分割功能,本次修复能改善分块准确性
- 使用
RecursiveJsonSplitter处理结构化数据,新增的类型校验有助于提前发现输入问题 - 关注依赖安全,希望跟进上游库的安全补丁
整体来看,1.1.3 是一个以稳定性和安全性为主的维护版本,没有破坏性的 API 变更,升级风险较低。对于生产环境的 RAG 应用,这类版本通常可以放心跟进。
小结
langchain-text-splitters==1.1.3 并非功能大版本,但集中体现了成熟开源项目的日常运维逻辑:在依赖安全上保持警惕,在边缘功能(如小众语言分隔符、JSON 类型校验)上持续打磨,并通过惰性导入等手段优化工程体验。对于深度使用 LangChain 的团队,关注这些看似琐碎的版本更新,正是保障应用长期稳定的基本功。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。