LangChain4j从入门到实战:Java程序员的大模型进阶课

Java程序员必须掌握LangChain4j等大模型技能,才能避免成为"传统Java程序员"。
文章指出,只会微服务的Java程序员正被贴上"传统Java程序员"的标签,大模型技能已从加分项变为招聘门槛。企业架构正在原有微服务之上叠加AI赋能层,用Spring AI或LangChain4j让业务系统调用大模型。面试中向量数据库、长文本总结、提示词工程、RAG等概念已成常见考点,LangChain4j通过EmbeddingStore、ChatLanguageModel等接口统一了向量库与大模型的调用方式。作者认为,Java+AI大模型正在重演Spring Boot的普及路径——从选择题变成必考题,建议开发者通过项目实战把课程知识落到真实业务场景中。
为什么Java程序员需要掌握大模型技能
最近在B站上看到一套名为《LangChain4j从入门到实战》的教程,UP主在开篇就抛出一个犀利观点:只会微服务的Java程序员,正在变成"传统Java程序员"。
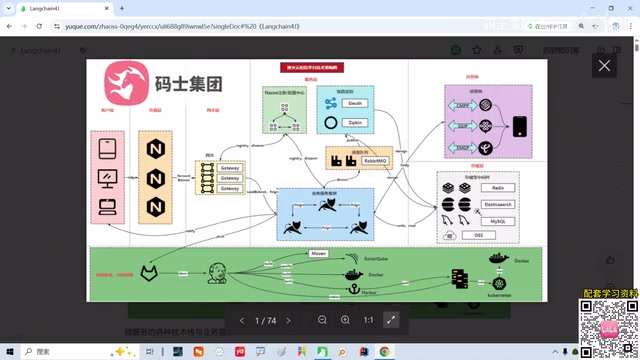
这个判断并非危言耸听。过去三五年,Spring Boot、Spring Cloud、Docker、Redis、Nexus、网关、容器化上云——这套技术栈确实是Java后端找工作的"标配"。但UP主指出,当这些成为每个程序员不得不会的基操之后,企业招聘的要求已经悄然升级。
按照教程中的说法,现在打开Boss直聘看后端开发工程师的JD,除了传统技术栈之外,大模型相关技能已经成为硬性加分项甚至必选项。不是说微服务不重要了,而是仅仅靠微服务已经很难在简历筛选中突围。
企业架构正在增加一个"AI赋能层"
这套课程最有价值的部分,是它没有停留在"大模型很火所以要学"的空泛层面,而是从企业架构演进的角度给出了具体解释。
UP主提到,现在很多公司——不只是大厂,中小厂也一样——都在原有业务系统上叠加一个模型层或AI赋能层。这个层的作用是让传统微服务系统能够调用通用大模型能力,对既有业务进行智能化改造。
这就带来了一个很现实的技术选型问题:Java项目要用什么框架来对接大模型?教程中提到了两个主流方案——Spring AI 和 LangChain4j。前者是Spring官方生态的AI扩展,后者则是受Python版LangChain启发、专为Java开发者设计的LLM应用开发框架。
LangChain4j的定位很清晰:让Java程序员用熟悉的编程范式来构建大模型应用,包括Prompt模板管理、对话链编排、向量数据库集成、RAG检索增强生成等能力。
RAG(Retrieval-Augmented Generation,检索增强生成) 是当前大模型落地企业场景最主流的架构模式之一。其核心思路是:不直接让大模型凭记忆回答问题,而是先从企业私有知识库中检索出与问题相关的片段,再把这些片段作为上下文拼进Prompt交给大模型生成答案。这样做的好处有三点:一是解决了大模型训练数据不包含企业内部文档的问题;二是显著降低模型"幻觉",因为答案有据可依;三是无需重新训练模型即可更新知识,只要更新向量库即可。RAG的典型链路包括:文档切分(Chunking)→ 向量化(Embedding)→ 存入向量数据库→ 用户提问时向量检索 Top-K 相似片段→ 拼接Prompt→ 大模型生成。LangChain4j 对这条链路有完整的抽象,例如 EmbeddingModel、EmbeddingStore、ContentRetriever 等。
面试中绕不开的几个大模型概念
教程中有一段很真实的描述:面试官问你什么是向量数据库、什么是长文本总结、什么是提示词工程,你能不能说出几个向量数据库的名字?
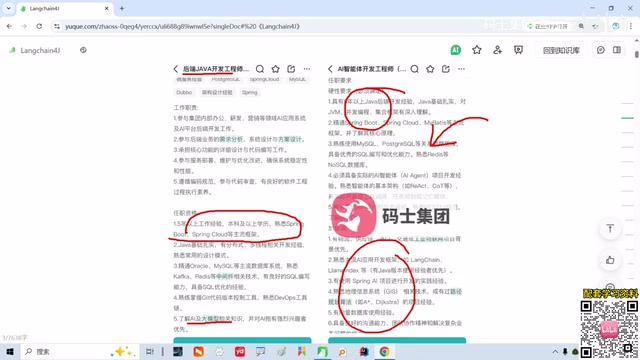
这里涉及的几个核心概念,确实是Java程序员转型大模型方向必须储备的:
- 向量数据库:用于存储文本的向量化表示,是RAG架构的关键组件。常见的包括Qdrant、PGVector、Milvus、Chroma等。UP主特别提到Qdrant和PGVector作为入门了解的对象。
- 长文本总结:利用大模型的上下文窗口能力,对超出单次请求限制的长文档进行分段处理与摘要生成。
- 提示词工程:通过精心设计的Prompt模板来引导模型输出符合业务需求的结果。
这些概念在LangChain4j中都有对应的API封装。比如它的EmbeddingStore接口可以对接不同的向量数据库,ChatLanguageModel接口统一了不同大模型的调用方式。
Embedding(向量化) 是把文本、图片等非结构化数据映射为高维浮点数向量的过程,语义相近的内容在向量空间中距离更近。它是向量数据库和RAG能够工作的前提。常见的中文可用 Embedding 模型包括 OpenAI 的 text-embedding-3、BGE、M3E、通义千问广告 text-embedding 等。在 LangChain4j 中,EmbeddingModel 负责把文本转成向量,EmbeddingStore 负责存储与相似度检索,两者解耦,因此可以灵活替换底层模型和向量库。理解 Embedding 的维度、相似度度量方式(余弦相似度、点积、欧氏距离)以及分块策略(chunk size、overlap),是排查 RAG 效果问题的关键。
Prompt Engineering(提示词工程) 并非简单的"会写提示词",而是一套系统化引导模型输出的方法。常见技巧包括:Few-shot 示例、Chain-of-Thought 思维链、角色设定(System Prompt)、输出格式约束(如要求返回 JSON)、以及把复杂任务拆解为多步。在生产环境中,Prompt 往往被抽象为模板(Prompt Template),通过变量占位符动态注入用户输入和检索到的上下文。LangChain4j 提供 PromptTemplate、@SystemMessage、@UserMessage 注解等方式来管理提示词,使 Prompt 与业务代码分离,便于版本管理和A/B测试。掌握这些能力,才能在面试中体现出"工程化"而非"调 API"的水平。
一个残酷的竞争现实
UP主在课程中说了一句很扎心的话:十个Java程序员出去找工作,如果有两个能说出大模型相关的技术点,面试官就会把它当作统一的衡量标准。
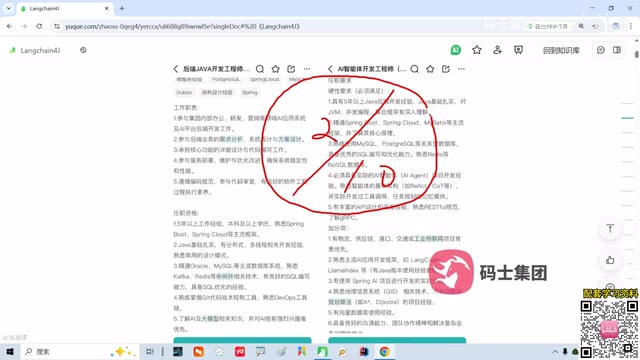
这意味着什么?意味着大模型技能正在从加分项变成门槛项。当一部分候选人已经具备AI应用开发能力时,不具备的候选人就会处于明显劣势。
这跟当年Spring Boot刚普及时的情形很像——最开始会Spring Boot是亮点,后来不会Spring Boot就找不到工作。UP主在课程中的核心论点就是:Java+AI大模型正在走同样的路径,从选择题变成必考题。
这套课程适合谁
从内容结构来看,这套LangChain4j教程适合以下人群:
- 有Java基础、熟悉Spring生态的后端开发者
- 希望在简历上增加大模型项目亮点的求职者
- 需要为企业项目引入AI能力的架构师或技术负责人
- 对RAG、向量检索、Prompt工程感兴趣但不知从何下手的Java程序员
课程强调"从入门到代码实战开发",说明它不只是概念科普,而是会涉及具体的编码实践。对于习惯通过动手来学习的开发者来说,这种项目驱动的方式通常比纯理论更有效。
不过也需要理性看待:一套课程能帮你建立知识框架和完成入门项目,但真正的竞争力来自于把LangChain4j应用到你实际的业务场景中。学完之后能不能在简历上写出有说服力的项目经历,取决于你自己的动手实践。
总结
Java程序员学大模型已经不是"要不要学"的问题。LangChain4j作为Java生态中最贴近大模型应用开发的框架之一,提供了一条从传统后端开发向AI应用开发延伸的路径。这套B站教程的价值在于它降低了入门门槛,但最终能不能抓住机会,还是取决于你愿不愿意在原有技术栈之上持续做技术储备。
正如UP主所说,没有不行的技术,只有不足的技术。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。