LangChain教程:Agent智能体与RAG项目实战入门

Java开发者正面临向AI大模型转型的岗位需求变化,LangChain4j成为进入大模型应用开发的关键框架入口。
文章指出,企业招聘关键词已从单纯的Java转向「Java AI大模型」,向量数据库、RAG、提示词工程、指令微调等能力正成为Java后端开发者的必备项。上硅谷推出的LangChain4j零基础速通实战课程覆盖从原生框架使用、Spring Boot整合,到RAG、向量数据库、Function Calling、MCP等进阶内容,前置要求为JDK 17与Spring Boot 3。文章还通过已就业学员简历案例说明,向量数据库、RAG、MCP等关键词直接影响ATS初筛结果,并给出「补齐版本—掌握框架—搭建RAG—深入进阶」的学习路径。此外,Python路线与DeepSeek应用级资料可并行学习,核心能力相通。
为什么Java开发者需要关注LangChain
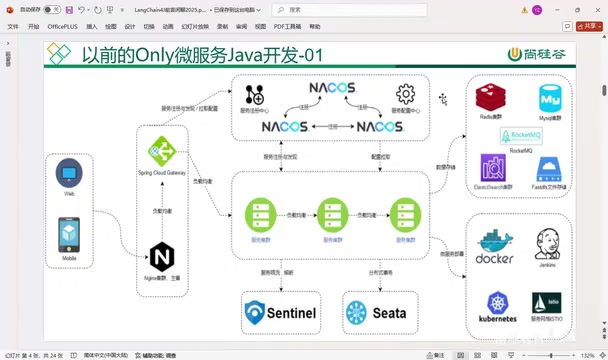
传统Java技术栈——Spring Boot、Spring Cloud、分布式微服务、容器化部署——曾经是进入中大型企业的通行证。但这套技能组合正在被大模型时代重新定义。据B站UP主「上硅谷」的分析,企业招聘需求已经出现明显转向:招聘方不再只搜「Java」,而是搜「Java AI大模型」。
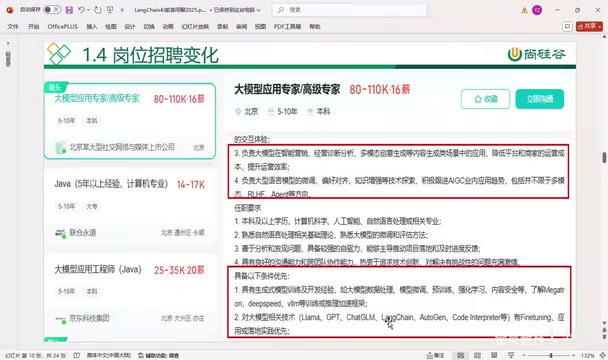
具体来看,当前企业对大模型方向的人才诉求集中在几个关键词上:向量数据库、RAG、文本嵌入、提示词工程、指令微调、舆情分析。这些概念不再是算法工程师的专属,而是Java后端开发者需要理解并落地的工程能力。
一个值得注意的信号是:Spring AI、阿里云广告百炼、LangChain4j等框架正在成为企业技术栈的新成员。招聘信息中开始出现「有大模型应用开发经验优先」的要求,甚至直接列出对GPT、Ollama、DeepSeek广告等工具的部署和调试经验。这意味着,学习AI大模型不再是选择题,而是Java开发者的必考题。
LangChain4j课程核心内容拆解
从入门到框架整合
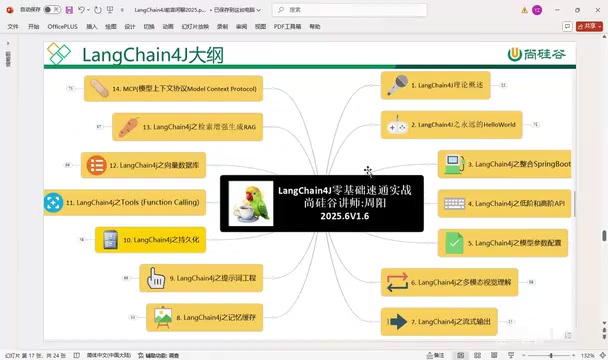
上硅谷推出的「LangChain4j零基础速通实战」课程,路线设计覆盖了从基础到实战的完整链路。入门阶段聚焦LangChain4j原生框架的使用,以及它与Spring Boot的整合方式。此外还引入了第三方大模型平台的对接,包括阿里云百炼和千帆大模型平台。
这部分内容的价值在于:多数企业并不会从零搭建大模型能力,而是基于现有云平台和开源框架做集成。掌握LangChain4j与Spring Boot的整合,意味着你能在现有Java微服务架构中快速嵌入AI能力。
LangChain4j 与 Spring AI 的差异
LangChain4j是LangChain理念在Java生态中的独立实现,并非Python版LangChain的移植。它提供统一的ChatLanguageModel、EmbeddingModel、EmbeddingStore等抽象,屏蔽不同厂商API差异,并内置对话记忆、RAG组件、工具调用等能力。优势是生态成熟、文档丰富、对多模型平台适配广。
Spring AI是Spring官方推出的AI应用框架,遵循Spring一贯的抽象与自动配置风格,与Spring Boot集成更自然,强调可移植性和企业级可维护性。两者定位相近但风格不同:LangChain4j更偏「AI能力全家桶」,Spring AI更偏「Spring原生体验」。实际项目中也可组合使用,例如用Spring AI做模型抽象、用LangChain4j的RAG组件补齐检索链路。理解差异有助于在面试和架构选型中做出合理判断。
进阶实战:RAG与向量数据库
课程中后段进入当前最热门的技术领域——RAG(检索增强生成)和向量数据库。这是企业级大模型应用落地中最常见的架构模式:将私有知识库通过嵌入模型转化为向量存储,在推理时检索相关片段注入提示词,从而让大模型输出更准确的答案。
课程还涉及提示词持久化、Function Calling、MCP(Model Context Protocol)等前沿话题。模型参数调优、多模态处理、流式输出等工程细节也在覆盖范围内。这些内容对应的是企业实际开发中的高频需求:如何让大模型稳定、高效地服务于具体业务场景。
说个细节,LangChain4j路线要求JDK 17和Spring Boot 3以上版本。如果仍在使用Java 8,需要先完成版本升级。前置知识方面,需要了解DeepSeek、通义千问、文心一言、Moonshot等主流大模型的基本概念。
关于RAG、向量数据库与文本嵌入的技术背景
RAG(Retrieval-Augmented Generation,检索增强生成)是一种把「外部知识检索」与「大模型生成」结合起来的架构范式。大模型的参数化知识存在时效性和领域盲区,RAG通过在推理阶段动态检索私有或实时数据,将其作为上下文注入提示词,从而显著降低幻觉、提升答案的准确性与可溯源性。其典型流程为:文档切分 → 文本嵌入 → 向量入库 → 查询嵌入 → 相似度检索 → 拼接提示词 → 生成回答。
向量数据库是RAG的存储与检索底座,常见产品包括Milvus、Chroma、Qdrant、PgVector等。它们通过ANN(近似最近邻)索引(如HNSW、IVF)在亿级向量中实现毫秒级相似度搜索,是传统关系型数据库难以替代的能力。文本嵌入(Embedding)则把文本映射为高维稠密向量,使语义相似度可以转化为向量距离计算,是检索效果的关键变量。对Java开发者而言,理解这三者的协作关系,是落地企业级AI应用的前提。
Function Calling 与 MCP 的定位
Function Calling(函数调用)指大模型根据用户意图,输出结构化的函数名与参数,由应用层实际执行后再把结果回传给模型,从而让LLM具备调用外部工具、查询数据库、发起API请求的能力。它是构建Agent智能体的基础机制,使模型从「只会聊天」变成「能做事」。
MCP(Model Context Protocol)是Anthropic提出的开放协议,用于标准化大模型与外部数据源、工具之间的连接方式。可以把它理解为「AI领域的USB-C接口」:过去每接一个工具都要写一套适配代码,MCP则通过统一的客户端-服务器协议,让模型以一致方式访问文件、数据库、API等资源。对Java生态而言,LangChain4j对MCP的支持意味着开发者可以用标准化方式扩展Agent能力,降低工具集成的重复成本。
简历与岗位趋势:多源信息交叉验证
招聘关键词的变化
从多个来源的分析来看,Java岗位的招聘关键词正在发生结构性变化。传统的「Spring Cloud」「分布式架构」「中间件」仍然是基础要求,但越来越多的岗位开始附加「RAG开发经验」「向量数据库使用」「提示词工程」等条件。
据上硅谷展示的已就业学员简历案例,成功拿到大模型方向offer的学员在简历中增加了以下关键词:向量数据库(如Milvus、Chroma)、RAG、MCP、提示词工程、LangChain4j、Spring AI等。这些关键词直接对应企业ATS系统的筛选逻辑——如果你的简历中没有这些词,很可能在初筛阶段就被过滤掉。
ATS 关键词筛选的机制
ATS(Applicant Tracking System,申请人追踪系统)是中大型企业用于简历初筛的软件系统,它会解析简历文本,按岗位JD中预设的关键词、技能标签进行匹配打分,低分简历在人工介入前即被过滤。这意味着简历能否进入HR视野,很大程度上取决于是否命中目标关键词。
对Java+AI方向求职者来说,除了传统的Spring Cloud、分布式、中间件等词,还应有意识地加入向量数据库、RAG、Embedding、Prompt Engineering、LangChain4j、Spring AI、Function Calling、MCP、Agent等术语,并在项目描述中用具体场景佐证(如「基于Milvus搭建知识库问答,召回率提升X%」)。关键词要与真实经历对应,避免堆砌,否则在技术面环节容易暴露短板。
学习路径建议
对于有一定Java基础的开发者,建议的学习路径是:先补齐JDK 17和Spring Boot 3的版本要求,然后通过LangChain4j的官方文档和实战项目理解框架的基本用法。在此基础上,选择一个向量数据库(如Milvus或Chroma)搭建一个简单的RAG应用,理解嵌入、检索、生成的完整流程。最后再深入Function Calling和MCP等进阶能力。
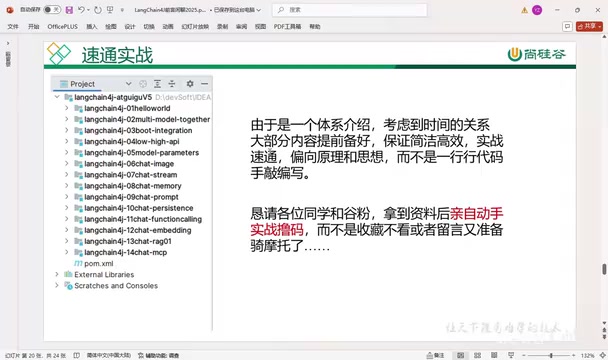
课程设计者考虑到学习者时间有限,对重复和常用的代码做了预处理,学员可以直接复用;困难部分则尽量保证在最短时间内学到最有效的技术。这种「速通实战」的思路,适合有一定工程经验但时间紧张的开发者。
课程之外:Python路线与大模型应用
除了Java路线的LangChain4j,上硅谷同时推出了Python路线的大模型课程,由另一位讲师负责。两条路线可以并行学习,互为补充。对于编码能力较弱、更偏向应用层面的学习者,还有基于DeepSeek的应用级学习资料可供选择,覆盖从工具使用到工作流搭建的内容。
从行业趋势看,无论是Java还是Python路线,大模型应用开发的核心能力是相通的:理解模型能力边界、掌握提示词设计方法、能够搭建RAG和Agent系统。区别主要在于工程实现的语言和框架选择。对于Java开发者而言,LangChain4j提供了一条在现有技术栈内平滑过渡到大模型开发的路径。
总结
LangChain4j的出现让Java开发者有了进入大模型应用开发领域的框架级入口。从招聘趋势到课程设计再到实际项目落地,RAG、向量数据库、Agent智能体已经成为企业级AI应用的标准组件。对于还在观望的Java开发者来说,现在开始学习LangChain4j,或许是一个值得投入的方向。
相关推荐
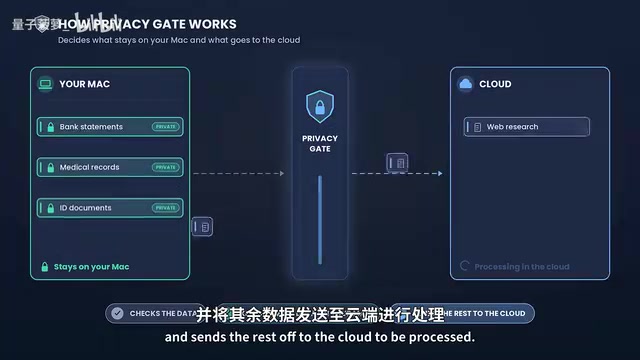
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。