LangChain入门详解:AI Agent智能体开发从0到1
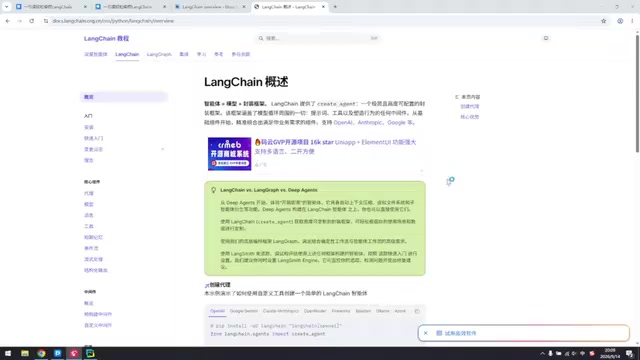
LangChain 是让大模型连接工具、数据与记忆的封装框架,是入门 AI Agent 开发的首选起点。
LangChain 是一个开源框架,核心定位是"智能体 = 模型 + 封装框架",作用类似后端开发中的 Spring,帮助开发者快速构建由大语言模型驱动的应用。它主要解决三大痛点:纯模型只知道训练截止日期前的信息,LangChain 可通过联网工具突破这一时间边界;模型无法直接访问外部数据库或企业内部系统,LangChain 提供完整的 RAG 工具链打通这条链路;模型本身无状态、不具备多轮记忆,LangChain 的上下文管理模块解决了这一问题。其名字取自 Language + Chain,体现了让模型以链式方式连接外部世界的设计哲学。由于难度适中、官方文档健全,LangChain 是大模型应用开发的推荐入门框架,但学习时应以英文官方文档为准,中文文档存在翻译不全及术语误译等问题。
LangChain 是什么:模型 + 封装框架
对刚接触大模型开发的人来说,LangChain 往往是储备了 Python 基础后第一个上手的框架。它的整体难度不高,官方文档也相当健全,无论是入门 demo 还是代码示例都有提供,因此非常适合作为大模型应用开发的起点。
用一句话概括 LangChain 的定位:智能体 = 模型 + 封装框架。这里的“模型”就是大家熟悉的 DeepSeek广告、Claude、Gemini、GPT 等大语言模型;而“封装框架”指的就是 LangChain 这一整套生态。换个更贴近官方说法的角度,智能体(Agent)= 模型 + Harness,而 LangChain 本身就是 Harness 的一套解决方案。
准确地说,LangChain 是一个用于开发大语言模型驱动应用程序的开源框架。它的作用类似于后端开发里的 Spring——Spring 帮你快速驱动 Web 应用,LangChain 则帮你快速驱动大模型。它不仅仅是对模型 API 调用做一层封装,还把工具调用、上下文管理等一系列复杂能力都集成在了生态内部,让开发者无需从零搭建复杂架构。
LangChain 名字的由来
LangChain 的名字来自“Language(大语言)”与“Chain(链式)”的组合。它的核心思路,是让大模型能够以链式的方式,和本地计算机或外部资源连接起来,最终构建出一个功能较强的 Agent 智能体,去解决实际问题。
理解了这个命名逻辑,也就理解了 LangChain 的设计哲学:单个模型的能力是有限的,真正强大的应用来自模型与外部世界的“连接”与“编排”。
LangChain 解决的三大核心问题
大模型本身有几个天然短板,而 LangChain 的价值恰恰体现在填补这些短板上。虽然它能解决的问题远不止三个,但以下三点最为关键。
一、突破模型的知识时间边界
大模型并非无所不知,它的知识边界取决于训练的时间节点——只能知道训练时间之前的事情。举个例子,如果一个模型是 6 月份训练的,你问它 8 月份发生的事,它是无法回答的。
模型自身没有能力直接调用工具或访问外网,但它“知道自己不知道”。这时就可以借助 LangChain 生态内提供的联网工具去查询外部信息。
这里有一个容易被忽视的常识:当你在 DeepSeek 这类产品界面里发消息时,其实并不是在跟纯粹的模型交互——它本身已经是一个封装好的智能体或知识库,内部已经集成了访问外网的能力。而真正“纯粹”的模型,是没有办法自行关联外网获取信息的。
二、连接外部数据与企业内部系统
第二个问题是访问外部数据。比如做 RAG(检索增强生成)、搭建知识库,都需要连接向量数据库、做溯源等操作,甚至访问公司内部的数据库。模型本身同样不具备这些能力,而 LangChain 可以帮开发者把这条链路打通,让模型与企业内部系统做交互。
RAG(Retrieval-Augmented Generation,检索增强生成)是当前企业落地大模型最常见的方案之一。其核心原理是:将私有文档或业务数据预先切片、向量化后存入向量数据库(如 Chroma、Pinecone、Milvus 等),当用户提问时,系统先从向量数据库中检索出最相关的文本片段,再将这些片段连同问题一起送入模型,由模型基于真实材料生成回答。这样既能突破模型训练知识的局限,也能让回答有据可查、支持溯源。LangChain 内置了完整的 RAG 工具链,包括文档加载器、文本切分器、向量存储接口以及检索链,开发者无需自己拼接这些环节,大大降低了构建企业知识库的门槛。
三、多轮对话的记忆与状态管理
第三个是状态能力,也就是常说的“记忆”。在多轮对话中,模型能根据你之前说过的话来理解当前的问题,这种上下文连贯的体验非常好。但正常来说,纯模型是一问一答、不具备记忆的——你每问一句,它只根据当前这一句作答,不会参考之前的对话。
LangChain 提供了上下文管理能力来解决这个问题。当然,开发者自己也可以手动实现,只是 LangChain 把这些繁琐的事情变得容易处理了。
从技术层面理解,大语言模型本质上是无状态的——每次 API 调用都是独立的,模型不会自动记住上一轮说了什么。多轮对话的"记忆感"实际上是通过将历史消息拼接进每次请求的 Prompt(提示词)上下文窗口来实现的。LangChain 提供的 Memory 模块封装了多种记忆策略:最简单的是将全部历史消息逐条保留(ConversationBufferMemory),但对话过长时会超出模型的上下文窗口限制;更进阶的方案会自动对历史进行摘要压缩(ConversationSummaryMemory),或只保留最近 N 轮对话。理解这一机制有助于开发者在实际项目中根据对话长度和成本需求,选择合适的记忆策略。
为什么建议从 LangChain 入手
市面上除了 LangChain,OpenAI、DeepSeek 也各自推出了类似的方案,套路大致相近,只是方向不同——有的走插件维度,有的走自己的生态。而 LangChain 走的是比较通用的路线,加上难度不高、文档健全,因此适合作为大模型开发的第一站。
值得强调的一个学习建议是:一定要看官方文档。无论学习 LangChain 还是其他框架的 Harness,官方文档永远是最准确的参考。中文文档虽然方便,但基本是靠 AI 翻译,功能覆盖也不全——比如“Agent(智能体)”曾被误译为“代理”,容易让人误以为要配置 VPN。此外,中文文档中 Gemini、Claude 等部分示例可能缺失,仍需回到英文原生文档查看。
对于英文基础一般的开发者,可以先看中文文档建立整体认知,遇到关键概念时再对照英文文档核实准确性,两者结合是较为务实的学习方式。
除 LangChain 之外,目前同类框架还包括微软推出的 AutoGen、由前 OpenAI 团队开发的 CrewAI,以及更底层、强调工作流可控性的 LlamaIndex 等。这些框架各有侧重:LlamaIndex 更专注于数据索引与 RAG 管道,CrewAI 主打多智能体协作,AutoGen 则以对话驱动的多 Agent 交互见长。LangChain 的优势在于生态最成熟、社区最活跃、与各类模型和工具的集成数量最多,因此在快速验证想法或构建通用 Agent 时往往是首选。随着对大模型开发理解的加深,再根据具体场景选择或切换其他框架,会更有针对性。
小结
LangChain 的本质,是把大模型从“孤立的问答机器”升级为“能连接工具、数据和记忆的智能体”。它解决的三大核心问题——突破知识时间边界、连接外部数据源、管理多轮对话状态——正是构建实用 AI Agent 的基础能力。理解了这套“模型 + 封装框架”的思路,再配合官方文档动手跑代码,就能顺利迈出 Agent 开发的第一步。
相关推荐
Codex+Skills+Playwright:从需求文档到自动化测试用例的AI落地实践
基于Codex(Cloud Code)+Skills+Playwright实现从需求文档自动生成测试用例的实战方案。涵盖文档解析、需求拆分、多模态测试点提取、评审到用例导出与自动化执行的完整五步工作流。
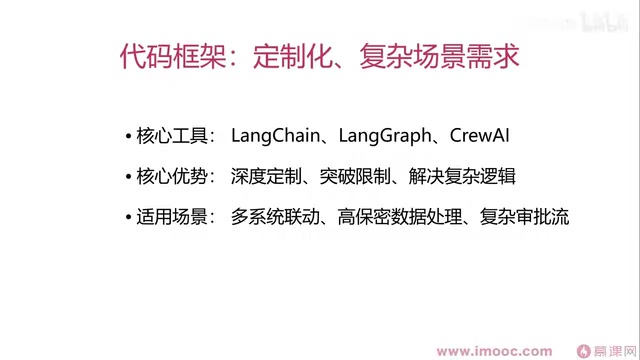
从单智能体到多智能体:AI Agent企业实战开发全景解析
一份B站强推的AI Agent企业实战课程解析:从低代码平台到LangChain、LangGraph等硬核框架,覆盖MCP协议、九大核心岗位与四大企业级实战项目,带你系统构建从单智能体到多智能体的开发能力。
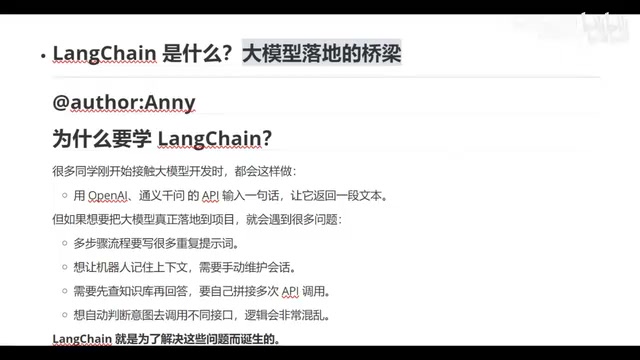
为什么大模型应用离不开LangChain?框架入门核心概念详解
为什么会调 API 还要学 LangChain?本文从工程化落地角度解析 LangChain 的核心价值,详解提示词模板、Chains、Memory、RAG、Agent 五大模块及企业真实应用场景,帮你理清从调 API 到做产品的关键差距。