零样本晶圆图分类:免训练多模态大模型方案

研究提出免训练零样本晶圆图缺陷分类框架,结合连通域高亮与规则排序提示,在多数据集上取得显著效果。
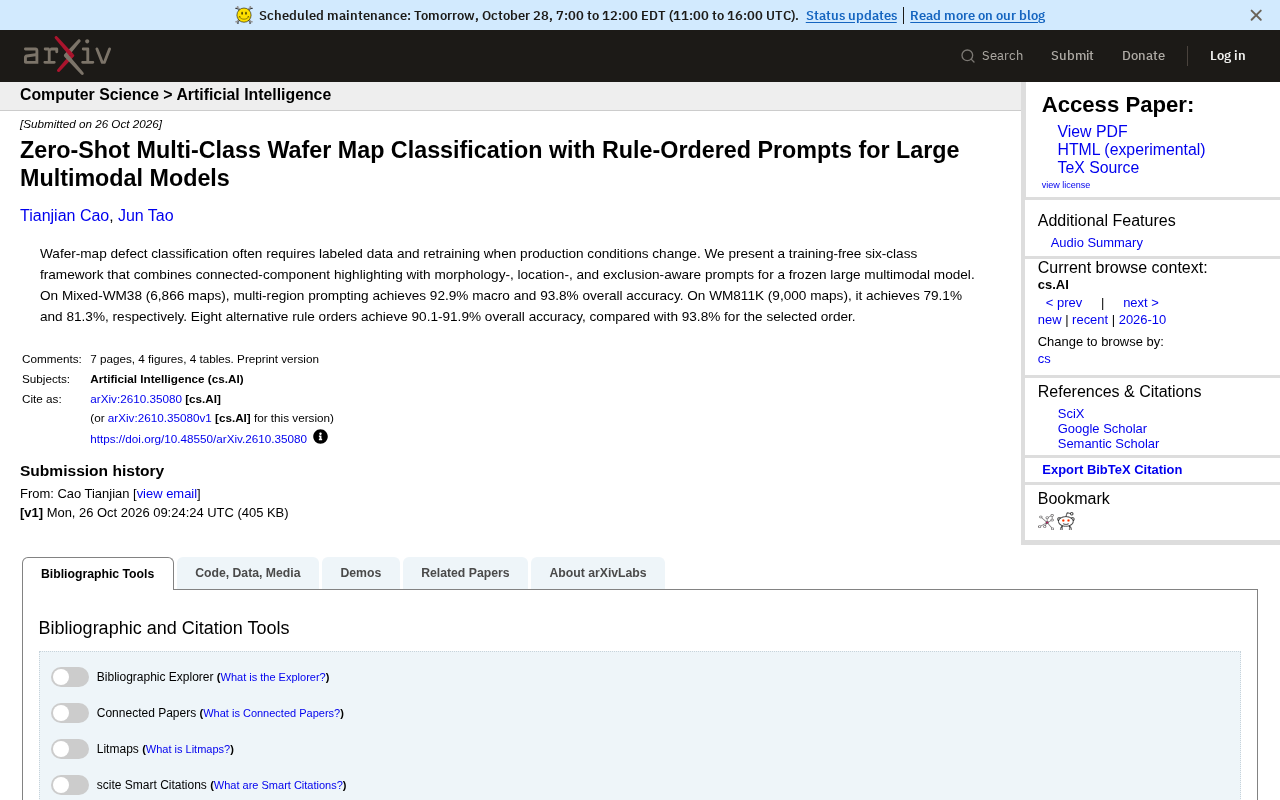
一项最新研究提出无需训练的六类晶圆图缺陷分类框架,利用冻结的大型多模态模型,通过连通域高亮与多维度规则提示实现零样本分类。在Mixed-WM38数据集上达到93.8%的总体准确率,在WM811K上达到81.3%。研究还发现提示中规则顺序对性能有实质影响,选定顺序比八种替代顺序高约2-3个百分点。该方法无需标注数据或模型微调,适应生产条件变化,为半导体良率分析提供了低门槛的新路径,但目前在公开数据集上验证,实际产线复杂噪声和规则顺序自动化调优仍是待解挑战。
晶圆图缺陷分类是半导体制造中良率分析的关键环节,传统方法依赖大量标注数据,且生产条件变化时需重新训练模型。一篇最新研究提出了一种无需训练的六类分类框架,利用冻结的大型多模态模型,通过连通域高亮与规则排序提示实现零样本分类,在多个数据集上取得了显著效果。
免训练框架的核心设计
该研究的关键创新在于将连通域高亮与多维度提示结合。具体而言,系统首先对晶圆图进行连通域分析,高亮出潜在的缺陷区域,然后将这些视觉信息与形态学、位置和排除感知的提示(prompts)一同输入冻结的多模态大模型。由于模型参数完全冻结,整个流程无需任何标注数据或微调,真正实现了零样本分类。
这种方法的核心优势在于适应性强:当生产条件变化导致缺陷模式漂移时,传统模型需要重新收集数据并训练,而该框架只需调整提示规则即可快速部署。
连通域分析是图像处理中的经典技术,用于将二值图像中相邻的像素(通常按4邻域或8邻域连通准则)聚合为独立的区域。在晶圆图分析中,缺陷通常表现为局部异常的像素簇,通过连通域分析可以快速定位这些簇的边界和位置,并对其进行高亮标记。这一步骤并不依赖任何模型训练,纯粹基于几何规则,因此与冻结的多模态大模型天然兼容,能够为后续的提示提供空间和形态上的结构信息。
零样本分类指模型在从未见过目标类别标注样本的情况下直接进行类别预测。其可行性依赖于模型在大规模预训练中获得的泛化表示能力,以及通过自然语言提示将任务知识注入模型的方式。与传统监督学习不同,零样本分类不进行参数更新,因此对新类别的适应速度极快,但性能高度依赖于提示设计的质量。
性能表现:Mixed-WM38与WM811K
在Mixed-WM38数据集(包含6,866张晶圆图)上,多区域提示策略达到了92.9%的宏平均准确率和93.8%的总体准确率。在规模更大的WM811K数据集(9,000张图)上,同一方法取得了79.1%的宏平均准确率和81.3%的总体准确率。两个数据集上的表现差异可能源于缺陷类别分布和图像复杂度的不同,但整体结果证明了该方法在不同数据规模下的有效性。
与需要训练的传统方法相比,这种免训练方案在准确率上并不逊色,同时省去了数据标注和模型迭代的成本。
宏平均准确率与总体准确率是分类任务中两种不同的聚合指标。总体准确率是所有样本中预测正确的比例,容易受类别样本数量分布的影响;宏平均准确率则先分别计算每个类别的准确率,再取算术平均,对少数类别的表现更为敏感。在晶圆图缺陷分类中,不同缺陷类型的样本量往往不均衡,因此宏平均准确率能更公平地反映模型对各类缺陷的识别能力,这也是该研究同时报告两个指标的原因。
WM811K是半导体缺陷图分析领域最常用的公开基准数据集之一,包含约81万张晶圆图,涵盖多种缺陷模式。该研究从中选取了9,000张图进行实验,属于子集验证。由于WM811K的类别分布和图像噪声水平与Mixed-WM38存在差异,跨数据集性能下降是预期之中的现象,这也提示零样本方法在实际部署前需要针对目标产线的数据特性进行提示适配。
规则顺序的影响
研究还探讨了提示中规则顺序对分类性能的影响。除了选定的最优顺序外,另外八种替代规则顺序的总体准确率在90.1%到91.9%之间,均低于选定顺序的93.8%。这表明规则排序对最终效果有实质性影响,合理的顺序设计能够带来约2-3个百分点的提升。虽然差距不大,但在晶圆图分类这种对精度要求较高的场景中,这样的提升具有实际价值。
这一发现也提示我们,在多模态大模型的提示工程中,规则的组织方式并非无关紧要,而是需要精心设计的环节。
提示工程中的规则顺序之所以会影响输出,与大型多模态模型的注意力机制和上下文处理方式有关。当多条规则以文本形式依次输入时,模型对靠前内容的关注权重通常更高,后续规则可能被部分稀释或覆盖。此外,规则之间若存在语义重叠或潜在冲突,排列顺序会改变模型消解歧义的路径。因此,即便规则集合完全相同,不同的组织顺序也可能导致分类决策的偏移。这一现象在零样本场景下尤为突出,因为没有训练过程来平滑提示变化带来的波动。
行业意义与局限
从行业角度看,这项研究为半导体制造中的缺陷检测提供了一条新路径。免训练的特性意味着更低的部署门槛和更快的响应速度,尤其适合小批量、多品种的生产环境。不过,该方法目前仅在两个公开数据集上验证,实际产线中的复杂噪声和罕见缺陷模式可能带来挑战。此外,规则顺序的调优仍需要一定的领域知识,如何自动化地搜索最优规则顺序是未来值得探索的方向。
总体而言,这项研究展示了多模态大模型在工业视觉任务中的潜力,零样本分类不再停留在理论层面,而是有了可落地的技术方案。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
30行Python自建MCP服务器并接入Claude Code
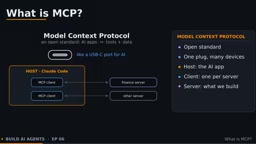
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。