Liquid AI发布LFM3:六个2B级模型覆盖端侧全模态
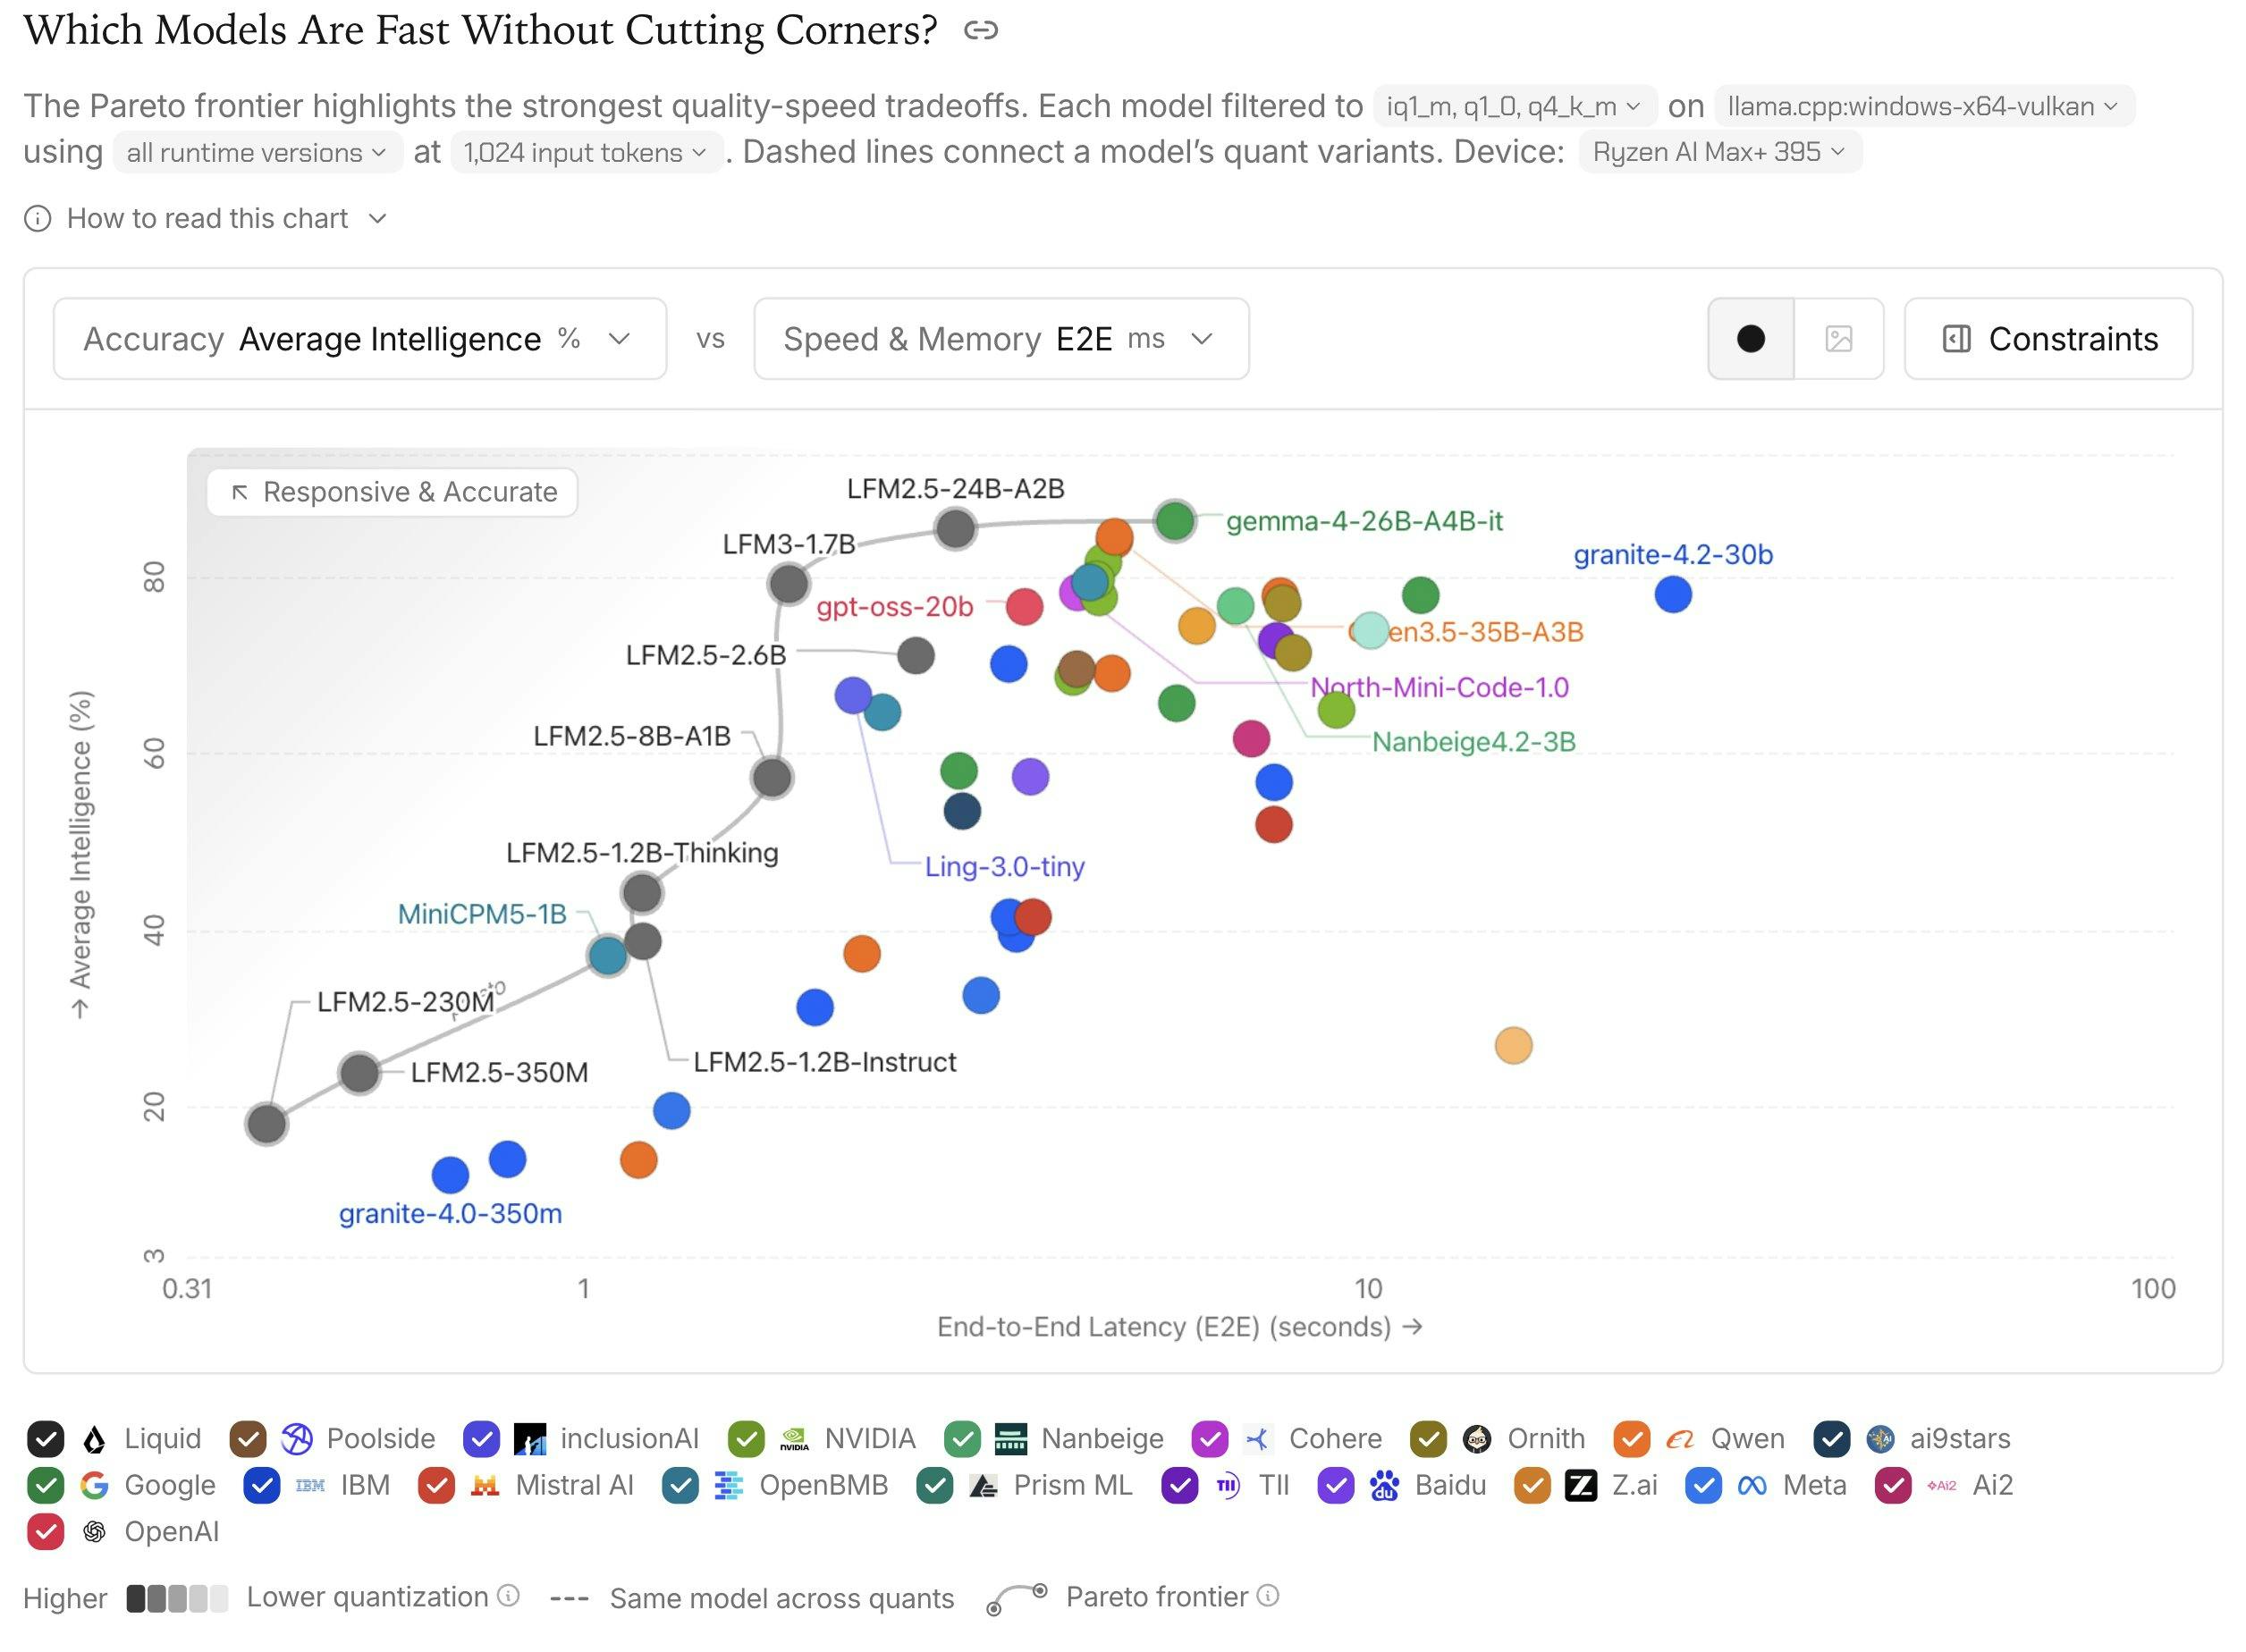
Liquid AI 发布 LFM3 六个 2B 级共享骨干模型,覆盖多模态并支持端侧部署与单卡微调。
Liquid AI 在 Product Hunt 发布第三代 Liquid Foundation Models(LFM3),首批六个 2B 级模型采用共享骨干设计,覆盖文本、视觉、音频、全模态和决策模型,定位手机、笔记本和机器人等边缘设备。最小的 1.7B 文本模型在 4-bit 量化下体积约 1 GB,支持 256K 上下文,并可在单张 GPU 上微调。权重以开放形式发布在 Hugging Face,打通了下载、微调、端侧部署的链路。不过官方尚未公布各模态能力边界、推理速度和不同硬件表现的横向对比数据,社区反馈也较有限,实际选型仍需自行跑基准测试。
Liquid AI 在 Product Hunt 上发布了第三代 Liquid Foundation Models——LFM3,首批一次性放出六个 2B 级模型,官方称它们可以跑在手机、笔记本和机器人等边缘设备上。这组模型采用开放权重,共享同一套骨干网络,覆盖文本、视觉、音频、全模态和决策模型。其中最小的一款是 1.7B 文本模型,4-bit 量化后体积约 1 GB,支持 256K 上下文,并且可以在单张 GPU 上完成微调。
一套骨干,六种模态
LFM3 最值得关注的设计是“共享骨干”(shared backbone)。按官方描述,文本、视觉、音频、omni 和 decision 五类模型并非各自独立训练出来的孤立体系,而是建立在同一套底层结构之上。这种做法在端侧模型里并不常见,它的直接好处是模型家族之间的行为更一致,下游团队做多模态组合时不需要分别适配几套差异巨大的网络结构。
首批六个模型都属于 2B 级,这个规模区间是当前端侧部署的甜点位置:足够大到能承担实际任务,又小到可以在消费级硬件上运行。Liquid AI 明确把它们定位在手机、笔记本和机器人三类设备上,说明目标不是云端推理,而是本地化、低延迟、数据不出设备的场景。
共享骨干指的是多个不同模态的模型复用同一套底层网络参数或结构,而不是为每个模态从头训练独立模型。常见做法是在一个基础 Transformer 上通过模态特定的输入输出适配层(如视觉 patch embedding、音频编码器)接入不同数据,让大部分参数在各模态间共享。好处包括:参数总量更小、多模态对齐更容易、下游组合时接口一致。难点在于不同模态的数据分布和计算需求差异大,共享过多可能导致某个模态性能下降,因此需要在共享与专用之间做权衡。
1.7B 文本模型的工程量:1 GB 与 256K 上下文
六个模型里最具体的一个数字来自 1.7B 文本模型:4-bit 量化下体积约 1 GB,上下文长度 256K。这两个指标放在一起看才有意义。256K 上下文通常意味着可观的 KV cache 开销,能把整体占用压在 1 GB 量级,说明模型在架构和量化策略上都做了针对性设计,而不是简单地把一个通用模型压缩后塞进手机。
对应用开发者来说,1 GB 的门槛意味着模型可以随应用一起分发,或者在中低端机型上留出足够的内存余量给其他功能。256K 上下文则为长文档处理、长对话记忆、代码库检索这类任务提供了本地化的可能——此前这些能力基本依赖云端大模型。
4-bit 量化是将模型权重从常见的 16-bit 浮点压缩到 4-bit 整数表示,使存储和内存占用降到约四分之一。对 1.7B 参数模型而言,4-bit 下理论体积约 0.85 GB,加上嵌入层、量化缩放因子等开销接近 1 GB。量化会引入精度损失,通常通过分组量化、校准数据等方式缓解。KV cache 是自回归推理时缓存历史 token 的键值对,上下文越长占用越大;256K 上下文下 KV cache 可能达到数 GB,因此需要结合量化、分页注意力或稀疏化等策略才能把总占用控制在端侧可接受范围。
单卡微调降低了定制门槛
官方提到的另一个关键点是“can be fine-tuned on one GPU”,即单个 GPU 即可完成微调。对端侧模型而言,这条信息的分量不亚于模型本身的大小。企业客户真正在意的是能不能用自己的数据把通用模型改成专用模型,而微调成本直接决定了这件事的门槛。单卡可微调意味着中小团队甚至个人开发者都能参与定制,不必依赖大规模训练集群。
权重已经放在 Hugging Face 上,采用开放权重发布。结合单卡微调能力,LFM3 实际上把“下载—微调—部署到端侧”这条链路打通了,这对机器人、车载、工业设备等需要私有化部署的场景尤其有吸引力。
开放权重(open weights)指模型参数可公开下载,但训练代码、数据或完整训练流程未必开放,与完全开源的模型有区别。使用方可以本地推理、微调、量化部署,但需遵守模型卡上的许可条款(如是否允许商用、是否要求署名)。单卡微调通常依赖参数高效微调技术(如 LoRA),只训练少量附加参数,大幅降低显存需求;1.7B 模型在 4-bit 量化基座上做 LoRA 微调,单张消费级 GPU(如 24 GB 显存)即可完成。
端侧全模态的竞争位置
LFM3 的发布延续了 Liquid AI 一贯的路线:不做最大最强的通用模型,而是把资源集中在高效架构与边缘部署上。六个 2B 级模型一次性覆盖五种模态,加上开放权重和单卡微调,构成了一套相对完整的端侧方案。
提一嘴,目前公开的信息集中在模型规格与部署条件上,关于各模态的具体能力边界、实际推理速度、不同硬件上的表现,官方尚未给出可横向比较的数据。Product Hunt 上该产品获得 104 票、位列当日第 5,讨论热度尚可,但评论区只有 3 条,社区反馈还很有限。对于真正要选型落地的团队来说,权重已经开放,实际跑一遍基准测试比看规格表更有参考价值。
常见问题
LFM3 可以商用吗? 权重在 Hugging Face 上以开放权重形式发布,具体许可条款需查阅模型卡说明,不同模型可能适用不同协议。
1 GB 的体积是压缩后的吗? 是 4-bit 量化后的体积,对应 1.7B 文本模型。全精度版本会显著更大。
256K 上下文在所有设备上都能用满吗? 长上下文会带来额外的内存与算力开销,实际可用长度取决于设备内存和推理框架的优化程度。
相关推荐
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。
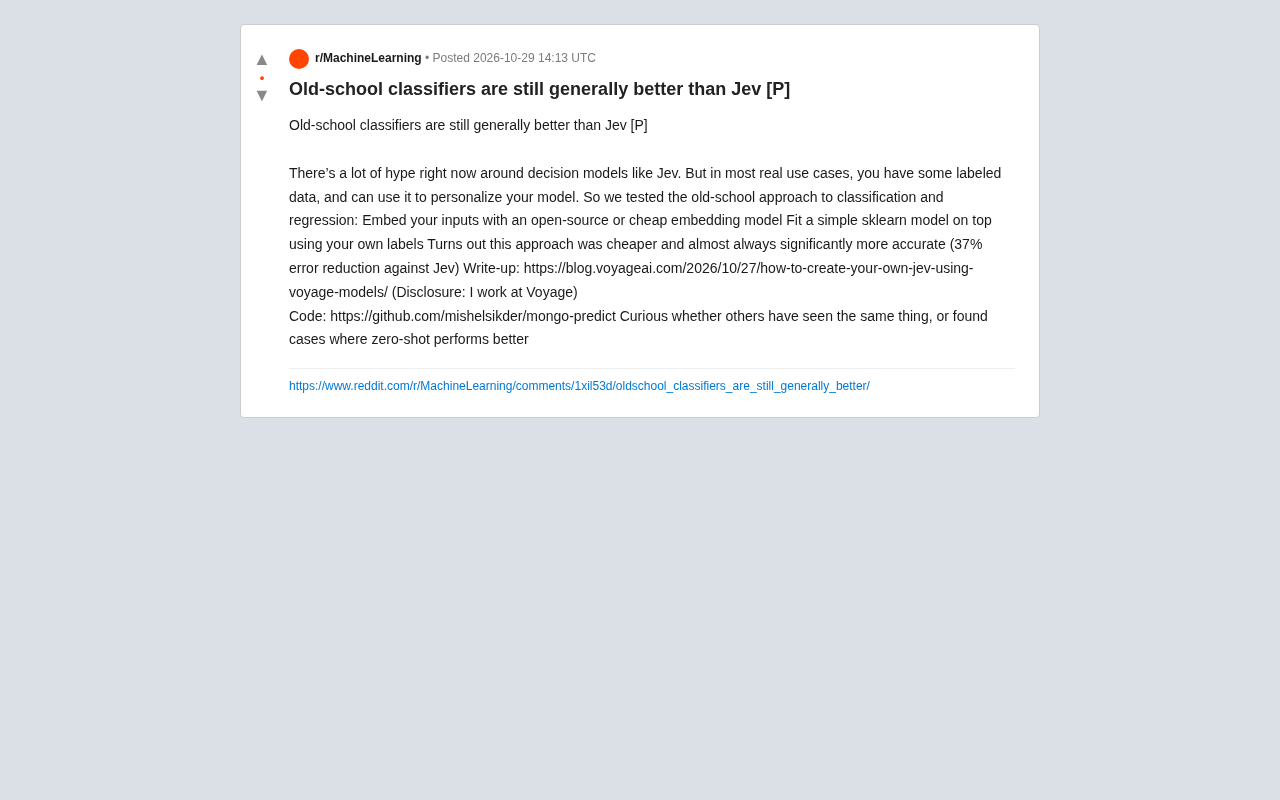
老派分类器仍胜Jev:嵌入+sklearn误差降37%
Voyage AI工程师测试发现,用开源嵌入模型加sklearn分类器的老派方案,比当红决策模型Jev更便宜且错误率降低37%。讨论有标注数据时传统方法是否被低估,以及零样本与有监督学习的适用边界。