LLM辅助多保真贝叶斯优化:融合专家知识与数值数据

LLM将专家定性知识转化为知识基,与数值数据融合,加速高保真数据稀缺下的多保真贝叶斯优化。
本文提出一种LLM辅助的多保真贝叶斯优化(MFBO)方法,旨在解决高保真数据稀缺时低保真与高保真模型残差难以准确建模的问题。该方法利用大语言模型解读专家对低保真模型遗漏物理机制的文字描述,通过成对比较判断不同设计所需的残差修正方向,再经成对高斯过程将定性知识量化为连续的基函数(知识基),并与数值数据校准融合。在锂离子电池设计实验中,该方法相比传统MFBO将遗憾曲线下面积降低61%。控制实验表明,知识质量而非LLM的具体选择是加速搜索的关键因素。该框架为工程优化中融合专家定性与定量信息提供了新途径。
引言
在工程设计中,多保真贝叶斯优化(MFBO)通过结合廉价的低保真(LF)模型和少量昂贵的高保真(HF)评估,能够显著降低优化成本。然而,当高保真数据稀缺时,仅从数值数据中学习低保真与高保真之间的差异十分困难,尤其当低保真模型忽略的物理机制与设计相关时。尽管数据不足,领域专家往往清楚低保真模型忽略了哪些物理机制,以及这些机制在何种条件下影响会加剧。现有方法无法直接利用这类定性知识,但大语言模型(LLM)可以解读专家描述,并据此比较不同设计。本文介绍一种LLM辅助的MFBO方法,通过将专家知识转化为知识基,与数值数据融合,从而加速优化过程。
核心挑战:高保真数据稀缺下的多保真优化
多保真贝叶斯优化旨在平衡低保真模型的低成本与高保真模型的准确性,以最少的高保真评估找到最优设计。但在实际工程中,高保真数据往往来之不易,导致低保真与高保真之间的差异(即残差)难以准确建模。更棘手的是,当低保真模型忽略的物理现象(如某些非线性效应)与设计参数相关时,残差不再是简单的常数偏移,而是随设计变化的复杂函数。此时,仅靠有限的数值数据训练的多保真模型容易产生偏差,影响优化效率。
贝叶斯优化是一种基于概率代理模型(通常是高斯过程)的全局优化方法,特别适合目标函数评估代价高昂且无梯度信息的黑箱优化问题。它通过构建代理模型来近似目标函数,并利用采集函数(如期望改进EI、置信上界UCB)在探索(exploration)与开发(exploitation)之间权衡,从而以尽量少的评估次数找到最优解。在多保真贝叶斯优化中,代理模型同时融合不同保真度的数据:低保真数据量大但精度低,高保真数据量少但精度高。典型的多保真模型(如自回归高斯过程)假设高保真函数可表示为低保真函数乘以缩放因子再加上一个残差函数,残差通常也用高斯过程建模。当高保真数据稀缺时,残差函数的后验不确定性很大,导致采集函数决策不可靠,这正是本文要解决的关键痛点。
LLM辅助的MFBO框架
知识基的构建
该方法的核心是在传统多保真模型基础上增加一个“知识基”。具体而言,从专家对遗漏物理机制的文字描述出发,利用LLM判断两个设计之间哪个需要更大的带符号残差修正。这些成对判断通过成对高斯过程转换为连续的基函数,从而将定性知识量化为模型可用的先验信息。
成对高斯过程(pairwise GP)是一种基于成对比较数据的概率模型。与传统高斯过程直接建模函数值不同,成对GP的观测是“设计A的响应是否大于设计B的响应”这类相对比较信息。其核心思想是假设存在一个潜在函数f,观测到的成对比较结果由f(A)-f(B)的符号决定,并通过一个链接函数(如probit函数)将差值映射为比较结果的概率。给定若干成对比较后,可以通过拉普拉斯近似或变分推断获得潜在函数f的后验分布。这种方法在心理测量学(如偏好学习)和排序问题中广泛应用。在本文中,LLM对两个设计哪个需要更大残差修正的判断,本质上就是成对比较,因此成对GP自然成为将定性判断转化为连续基函数的数学桥梁。
校准与融合
为避免盲目信任专家知识,高保真数据被用于校准知识基的贡献大小和符号。通过这种方式,知识基与数值数据协同工作,既利用了专家的定性洞察,又确保了模型对数据的适应性。
实验验证:锂离子电池设计问题
在锂离子电池设计问题上,该方法相比传统MFBO将遗憾曲线下面积降低了61%。这一显著提升表明,LLM解读的专家知识能够有效补充数值数据,加速优化搜索。此外,一项控制实验独立变化知识质量和LLM选择,结果显示决定搜索加速的关键因素是知识质量而非LLM的具体选择。知识层面的消融实验进一步量化了每条知识陈述的贡献。
遗憾曲线下面积(Area Under the Regret Curve, AURC)是衡量优化算法效率的常用指标。遗憾(regret)定义为当前最优解的目标值与全局最优值之间的差距,随着迭代进行,理想的优化算法应使遗憾快速下降。将遗憾随评估次数变化的曲线积分得到AURC,其值越小说明算法越快逼近最优解。与仅看最终最优值相比,AURC能够综合反映优化过程的收敛速度,避免“运气好一次性找到最优”的偶然性。本文报告AURC降低61%,意味着在相同的评估预算下,LLM辅助方法找到的近优解质量显著优于传统MFBO,且优势在整个优化过程中持续存在,而非仅在终点体现。
多源视角与启示
尽管当前分析主要基于单一来源,但该研究揭示了融合定性与定量信息的新途径。专家知识与数值数据的结合并非简单叠加,而是通过LLM的语义理解能力实现互补。未来,这种方法有望推广至其他依赖昂贵仿真的工程领域,如航空航天、材料设计等。
结论
LLM辅助的MFBO通过将专家知识形式化为知识基,并与数值数据校准融合,有效缓解了高保真数据稀缺下的优化难题。实验证明,知识质量是加速搜索的关键,而LLM的选择影响较小。这一框架为工程优化中的人机协作提供了新思路。
相关推荐
Gemini 4 Hydrogen发布:速度提升2.5倍的日常AI模型
Google发布Gemini 4 Hydrogen,宣称比Gemini 3.8 Flash快2.5倍,支持四级思考控制、百万token上下文和Orchestrator多模型协作,API定价每百万输入token 1.50美元。
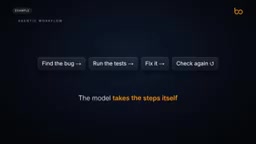
Gemini 4 Hydrogen实测:谷歌最快最便宜AI模型
谷歌 Gemini 4 Hydrogen 实测:Gemini 4 家族中最快最便宜的模型,解析 Carbon/Argon/Hydrogen 分工、API 定价陷阱、免费层限制与四档思考等级的成本取舍,附真实 bug 调试演示。

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。