LoopKV:面向循环Transformer的循环感知KV缓存压缩

LoopKV按循环与层的敏感度分级压缩KV缓存,使Ouro推理吞吐提升1.7-2.2倍。
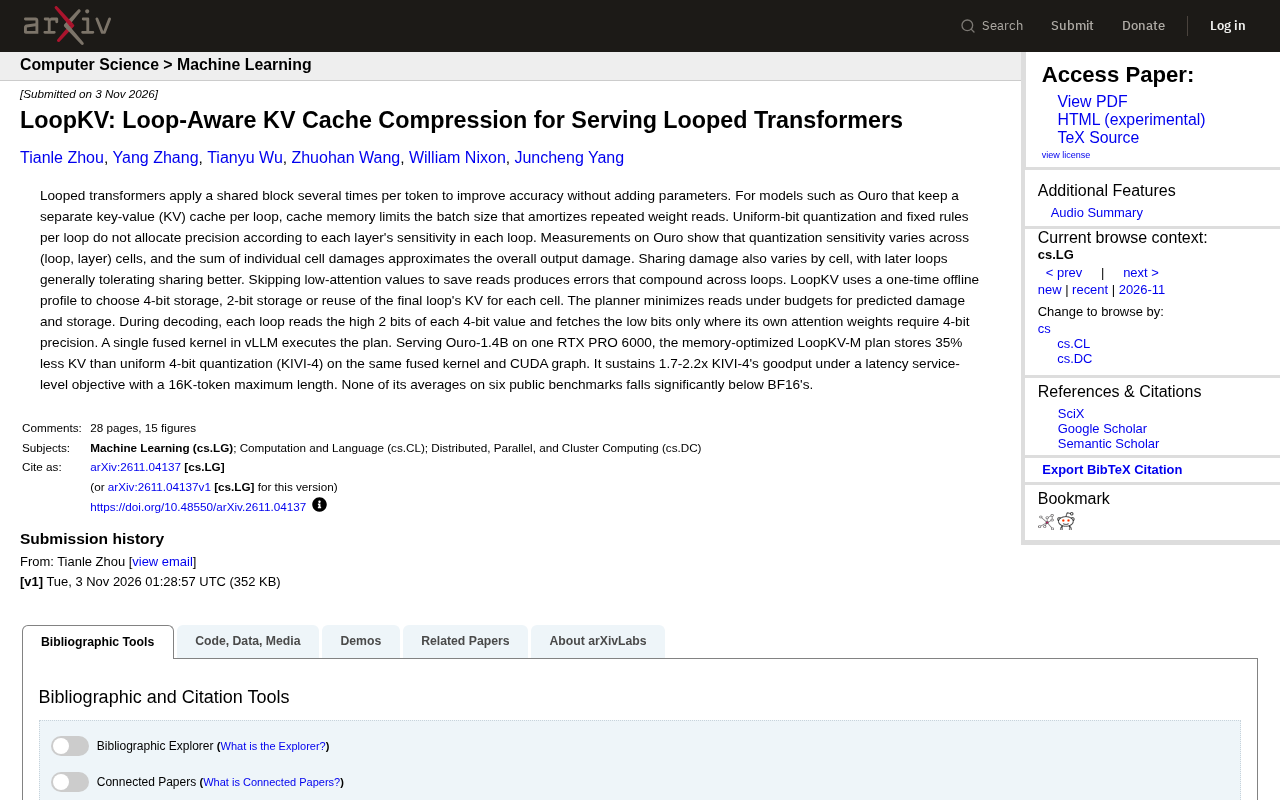
循环Transformer通过多次复用同一模块提升精度而不增加参数,但Ouro等模型每次循环维护独立KV缓存,缓存内存随循环次数线性增长,成为限制批量大小与吞吐的瓶颈。LoopKV发现量化敏感度在不同(循环,层)单元间差异显著,且各单元损害可近似加和,后续循环更能容忍缓存共享。基于此,它离线为每个单元规划4比特存储、2比特存储或复用最终循环KV三种方式,并在解码时先读高2位、按需读取低位,全部由vLLM中的单个融合内核执行。在单张RTX PRO 6000上服务Ouro-1.4B,LoopKV-M比均匀4比特量化减少35% KV存储,延迟目标下吞吐提升1.7-2.2倍,六个基准平均性能未显著低于BF16。
循环Transformer(Looped Transformer)通过共享同一个模块多次执行来提升精度,而不增加参数量。但对于Ouro这类模型,每次循环都维护独立的键值(KV)缓存,缓存内存成为限制批量大小的瓶颈。近日提出的LoopKV方法,通过细粒度感知每个循环和每层的量化敏感度,实现了更高效的KV缓存压缩,在单张RTX PRO 6000上运行Ouro-1.4B时,相比均匀4比特量化(KIVI-4)减少了35%的KV存储,并在延迟服务等级目标下实现了1.7-2.2倍的吞吐量提升。
循环Transformer的KV缓存困境
循环Transformer的核心思想是让模型对每个token多次应用同一个块(block),从而在不增加参数的情况下提升表达能力。Ouro是这类模型的代表之一,它在每次循环中保留独立的KV缓存。这种做法虽然灵活,却带来了显著的内存开销——缓存大小随循环次数线性增长,直接限制了可服务的批量大小。批量大小又决定了权重读取的摊销效率,因此缓存内存成为端到端服务吞吐的关键约束。
传统的KV缓存压缩方法,如均匀比特量化和按循环固定规则分配精度,无法根据每个层在每个循环中的实际敏感度来分配资源。换句话说,它们对所有(循环,层)单元一视同仁,而实际上不同单元的量化敏感度差异很大。
KV缓存是自回归推理中为避免重复计算而保存的中间状态:每生成一个token,模型需要之前所有token的键(Key)和值(Value)向量来完成注意力计算,这些向量被缓存下来,其大小随序列长度线性增长。在标准Transformer中,每个token只经过一次前向,因此每层只有一份KV缓存;而在循环Transformer中,同一个块被反复应用,若每次循环都保留独立的KV缓存,则缓存总量还要再乘以循环次数。这就是Ouro类模型内存开销显著高于同参数量标准模型的原因。缓存占用直接挤占可用于存放批量样本的显存,而批量越大,权重读取的收益越能被更多样本分摊,因此KV缓存大小会通过批量大小间接决定推理吞吐。
量化指用低位宽整数近似表示浮点数值,例如4比特仅能表示16个离散级别,2比特只有4个级别。位宽越低,存储与带宽开销越小,但引入的舍入误差越大,可能损害模型输出质量。均匀量化对所有参数使用相同位宽,实现简单却忽略了不同部分对误差的敏感程度差异。
量化敏感度的细粒度观察
研究团队在Ouro上进行了测量,发现量化敏感度在不同(循环,层)单元间存在显著差异。更重要的是,各个单元单独造成的损害之和,可以近似整体输出损害。这意味着可以独立评估每个单元的敏感度,并据此制定压缩策略。
另一个关键发现是,共享损害(sharing damage)也因单元而异——后面的循环通常更能容忍共享。这为复用最终循环的KV缓存提供了依据。此外,跳过低注意力值以节省读取的做法会产生误差,并且这些误差会随着循环累积,因此需要谨慎处理。
**敏感度(量化敏感度)**通常定义为对某个单元施加量化扰动后,模型输出与全精度输出之间的偏差程度,可用KL散度、均方误差或任务指标下降来衡量。敏感度高意味着该单元需要更高位宽才能维持精度,敏感度低则可以用更低位宽甚至复用近似值。文章所说的“损害可近似加和”,指的是一种可加性假设:若各(循环,层)单元单独量化造成的输出偏差之和接近所有单元同时量化时的总偏差,则可以在离线阶段逐单元独立测量敏感度,而无需穷举组合,这使规划问题从指数复杂度降为线性可解。
共享损害指多个单元复用同一份缓存(例如都复用最终循环的KV)时引入的额外误差。后续循环的表示往往已趋于收敛,对缓存精度的依赖较弱,因此复用最终循环的KV在这些位置造成的损害较小。
LoopKV的三级存储策略
基于上述观察,LoopKV设计了一个一次性的离线分析流程,为每个(循环,层)单元选择三种存储方式之一:4比特存储、2比特存储,或复用最终循环的KV。规划器在预测损害和存储预算的约束下,最小化读取次数。
在解码阶段,每个循环先读取每个4比特值的高2位,仅当该循环自身的注意力权重需要4比特精度时,才获取低位。这种按需读取的机制进一步降低了内存带宽压力。整个方案通过vLLM中的单个融合内核执行,确保了高效实现。
vLLM是面向大模型推理的高吞吐服务框架,其核心机制包括分页式KV缓存管理和融合算子。**融合内核(fused kernel)**指把多个细粒度操作合并进一个GPU内核中执行,以减少内核启动开销和中间结果的显存往返。LoopKV的解码路径需要“先读高2位、按需再读低2位”,若拆成多个独立操作会引入额外延迟,因此在单个融合内核内完成读取与反量化对达成延迟目标至关重要。CUDA图则把一串固定的GPU调用录制成图后整体重放,进一步压低调度开销,这也是对比实验中双方都采用的基础设施,从而保证吞吐差异主要来自缓存压缩本身。
性能表现与意义
在单张RTX PRO 6000上服务Ouro-1.4B时,内存优化的LoopKV-M方案相比同样使用融合内核和CUDA图的均匀4比特量化(KIVI-4),KV存储减少了35%。在16K token最大长度和延迟服务等级目标下,其有效吞吐量(goodput)达到KIVI-4的1.7至2.2倍。在六个公开基准测试上,LoopKV的平均表现没有显著低于BF16基线。
这一结果说明,针对循环Transformer的缓存压缩需要更精细的感知能力。LoopKV通过离线规划与在线按需读取的结合,在保持精度的同时大幅提升了服务效率,为循环Transformer的实际部署提供了有力支持。
对AI应用开发的启示
对于使用循环Transformer构建AI应用的开发者而言,KV缓存管理是影响推理成本和响应速度的关键因素。LoopKV的思路——根据敏感度动态分配精度、利用循环间的容忍度差异——可以启发其他长上下文或迭代推理场景的优化。虽然该方法针对特定模型架构,但其核心原则具有通用性:精细化的资源分配往往比一刀切的策略更有效。
随着循环Transformer在需要高精度且参数受限的场景中受到更多关注,类似的系统级优化将成为推动其落地的重要力量。LoopKV展示了算法与系统协同设计的潜力,也为后续研究指明了方向。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。