Mac M5 Ultra 256GB本地大模型跑分之谜:社区为何呼吁严肃测试
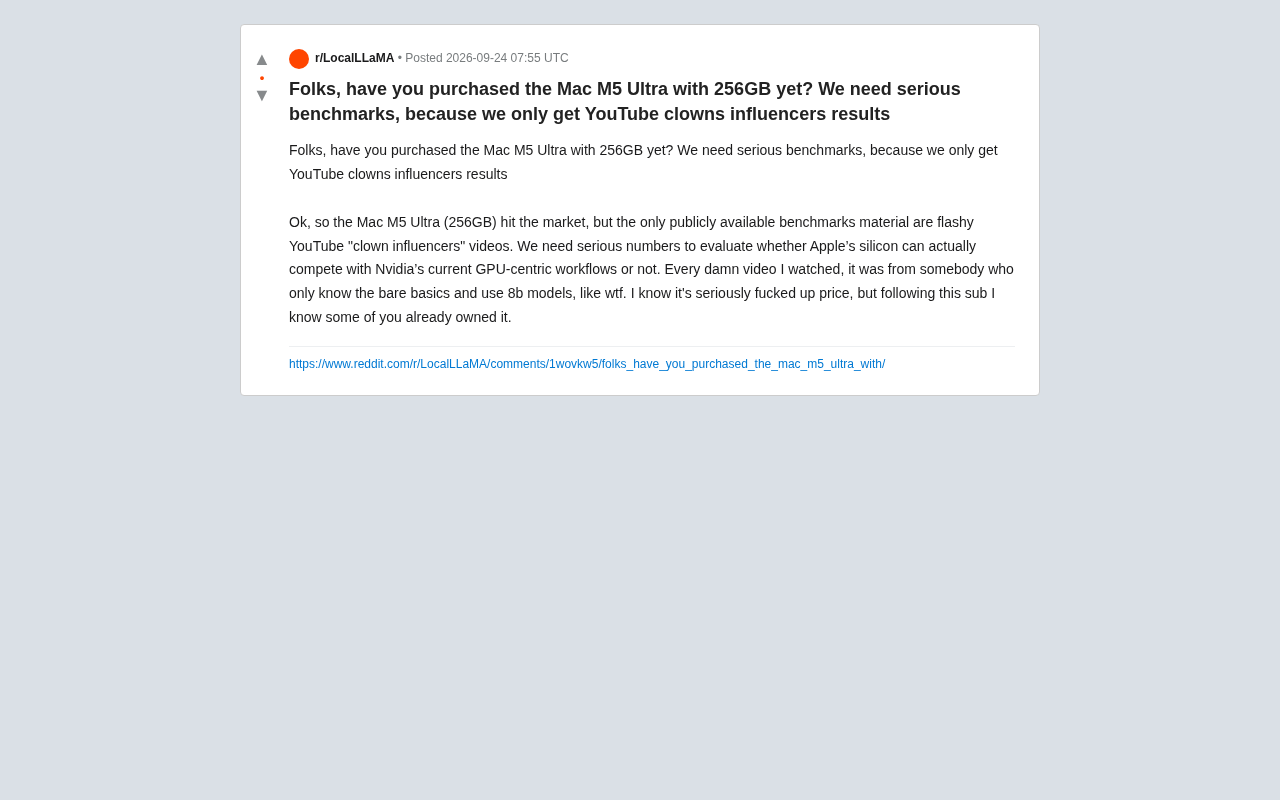
Mac M5 Ultra上市后严肃大模型评测稀缺,社区呼吁以70B级模型替代8B跑分来验证其真实价值。
苹果Mac M5 Ultra(256GB内存版)上市后,本地大模型社区发现市面上几乎所有评测都只使用8B小模型,这对于一台核心卖点是"可本地运行70B以上大模型"的机器而言毫无参考价值。文章指出,苹果统一内存路线与Nvidia GPU路线形成竞争,前者以超大容量低功耗换取了生态成熟度和峰值算力;但"能跑"和"跑得好"是两回事,量化精度、推理吞吐量与软件适配均需实测验证。高价硬件面临结构性评测困境:购买者少导致专业测评稀缺,而网红内容又以浅层演示掩盖了核心性能问题。文章建议潜在买家主动向专业社区索取具体场景的一手数据,而非依赖精心剪辑的宣传视频。
一条Reddit求助帖引发的思考
苹果Mac M5 Ultra(256GB内存版本)上市后,本地大模型爱好者社区里出现了一个颇具代表性的声音。一位Reddit用户直言不讳地表达了不满:市面上关于这台机器的公开跑分资料,几乎全部来自"华而不实的YouTube网红视频",缺乏真正有参考价值的数据。
"我看的每一个视频,都是那些只懂皮毛、只会跑8B模型的人做的,这算什么?"这位用户的抱怨,实际上点出了当前AI硬件评测领域一个普遍存在的痛点——面向本地大模型部署的高端硬件,其真实性能表现往往被浅尝辄止的内容所掩盖。
为什么8B模型跑分说明不了问题
对于配备256GB统一内存的Mac M5 Ultra而言,用8B(80亿参数)级别的模型来测试,确实是一种"大材小用"。这类小模型即便在消费级显卡甚至部分笔记本上也能流畅运行,根本无法体现大内存机器的核心优势。
苹果高端芯片在本地AI场景下最大的卖点,恰恰是其庞大的统一内存架构——256GB内存理论上可以容纳70B、甚至更大参数量的模型,而这正是Nvidia消费级显卡(受限于24GB或32GB显存)难以单卡实现的。因此,真正有意义的评测,应该聚焦于大参数模型(如70B、120B量化版本)的加载速度、推理吞吐量(tokens/秒)以及长上下文处理表现。
用小模型跑分,就好比用一辆超跑去测试市区堵车时的油耗——数据或许准确,却完全偏离了这台机器的设计初衷和购买者的真实需求。
量化(Quantization)是理解大模型本地运行的关键概念。原始大模型通常以FP16或BF16格式存储权重,70B参数模型约需140GB内存;通过量化技术,可将每个权重压缩至4位(Q4)甚至更低,使70B模型的内存占用降至约40GB左右,从而在256GB统一内存机器上运行。常用的量化工具包括llama.cpp的GGUF格式和GPTQ方案。量化会带来一定的精度损失,Q4量化的70B模型与全精度相比在复杂推理任务上通常仍有可感知的性能下降,但远优于参数量更小的模型。推理吞吐量通常以tokens/秒(t/s)衡量,对于本地对话场景,15-30 t/s被普遍认为是流畅体验的门槛,而这正是256GB大内存机器真正需要被验证的核心指标。
苹果芯片 vs Nvidia:本地推理的路线之争
这条帖子背后其实隐藏着一个更深层的行业议题:苹果的统一内存路线,能否真正挑战Nvidia以GPU为中心的工作流?
两条技术路线各有取舍。Nvidia凭借CUDA生态、成熟的推理框架和强大的显存带宽,在训练和高吞吐推理上占据绝对优势;但其消费级产品的显存容量是硬伤,想跑超大模型往往需要多卡并联,成本和功耗急剧上升。
苹果的M5 Ultra则走了另一条路:牺牲部分峰值算力和生态成熟度,换取超大容量的统一内存和极低的功耗。对于"我就想在本地跑一个70B模型做推理"的个人用户来说,一台整机可能比堆多张显卡的方案更省心、更省电。
但"能跑"和"跑得好"是两回事。内存够大只是入场券,实际的推理速度是否可用、量化后精度损失多少、软件生态(如llama.cpp、MLX框架)的适配程度如何,这些都需要严肃的实测数据来回答。而这,正是社区目前最缺乏的。
苹果统一内存架构(Unified Memory Architecture,UMA)与传统分离式显存的根本区别在于:CPU与GPU共享同一块物理内存,消除了数据在主内存与显存之间传输的带宽瓶颈。M5 Ultra通过两颗M5 Max芯片的互联拼接,可提供高达800GB/s以上的内存带宽,这一数字虽低于Nvidia H100的3.35TB/s,但已显著高于消费级GPU(如RTX 4090约1TB/s)。在本地推理场景中,内存带宽往往是决定tokens/秒的关键瓶颈而非纯算力,这使得苹果高端芯片在运行大型量化模型时具备实际竞争力。MLX是苹果专为Apple Silicon设计的机器学习框架,针对统一内存做了专项优化,与llama.cpp并列成为当前本地推理的两大主流软件路径。
高价机器与评测内容的错位
发帖者也承认,这台机器"价格贵得离谱"。正因为售价高昂,愿意购买的用户本就不多,其中能够进行专业级评测的更是凤毛麟角。这就造成了一个内容供给的结构性矛盾:
最需要严肃评测的高端产品,恰恰最难获得严肃评测。网红博主追求的是流量和眼球,跑个8B小模型、展示一下"丝滑"的界面就能收割播放量;而真正的深度评测需要专业知识、时间投入和对目标场景的理解,回报却未必成正比。
这也提醒潜在买家:在为这类高价AI硬件掏钱之前,与其相信精心剪辑的宣传视频,不如主动到专业社区(如本地大模型相关的技术论坛)寻找一手实测反馈,或直接向已购用户提出具体的测试请求——比如"请跑一下Llama 70B Q4量化,看看每秒多少token"。
写在最后
这条看似情绪化的Reddit帖子,实际上代表了本地AI部署社区日益理性和专业的诉求。当AI硬件从数据中心走向个人桌面,用户对评测质量的要求也水涨船高——他们要的不再是花哨的演示,而是能指导实际购买决策的硬核数据。
对于Mac M5 Ultra这类产品,答案或许要等到更多专业用户完成大模型实测后才会逐渐清晰。在此之前,保持理性、拒绝"网红跑分"的诱惑,是每一个考虑本地部署大模型的用户应有的态度。
相关推荐
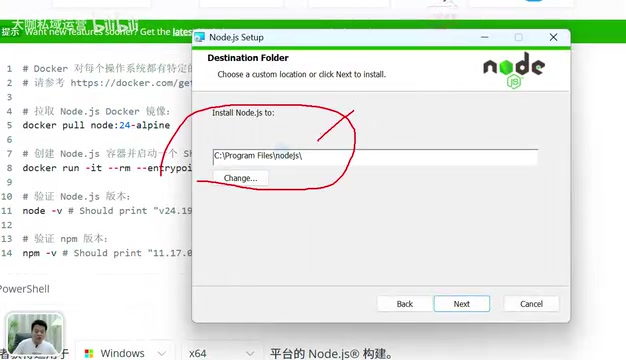
DeepSeek Harness入门:Node.js环境安装与配置全指南
DeepSeek Harness 零基础入门教程:详解 Node.js 环境安装、npm 配置与系统环境变量设置全流程,避开 C 盘占满、路径中文等常见坑,为搭建 AI 智能体框架打好基础。
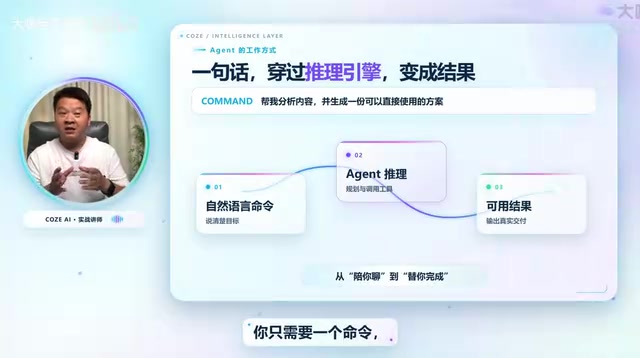
Coze扣子智能体实操指南:从零搭建AI自动化工作流
基于B站系统教程,详解Coze扣子智能体的自动搭建与手动搭建两种方式,覆盖电商、数字人、教育等实战场景,帮助零基础用户搭建AI自动化工作流与专属应用。
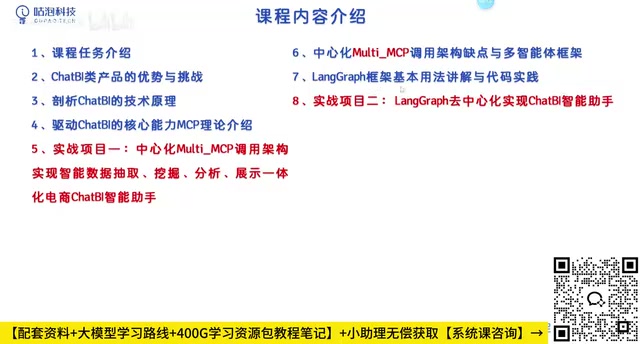
ChatBI企业级实战:用LangGraph与Multi-MCP打造去中心化数据分析智能体
B站UP主威斯利的ChatBI企业级实战教程解析:如何用Multi-MCP与LangGraph框架构建去中心化数据分析智能体,涵盖NL2SQL、机器学习建模与RAG扩展,替代传统三级数据分析流程,提升企业数据分析效率。