MDT模型:用跨模态冲突识别矛盾与犹豫情绪
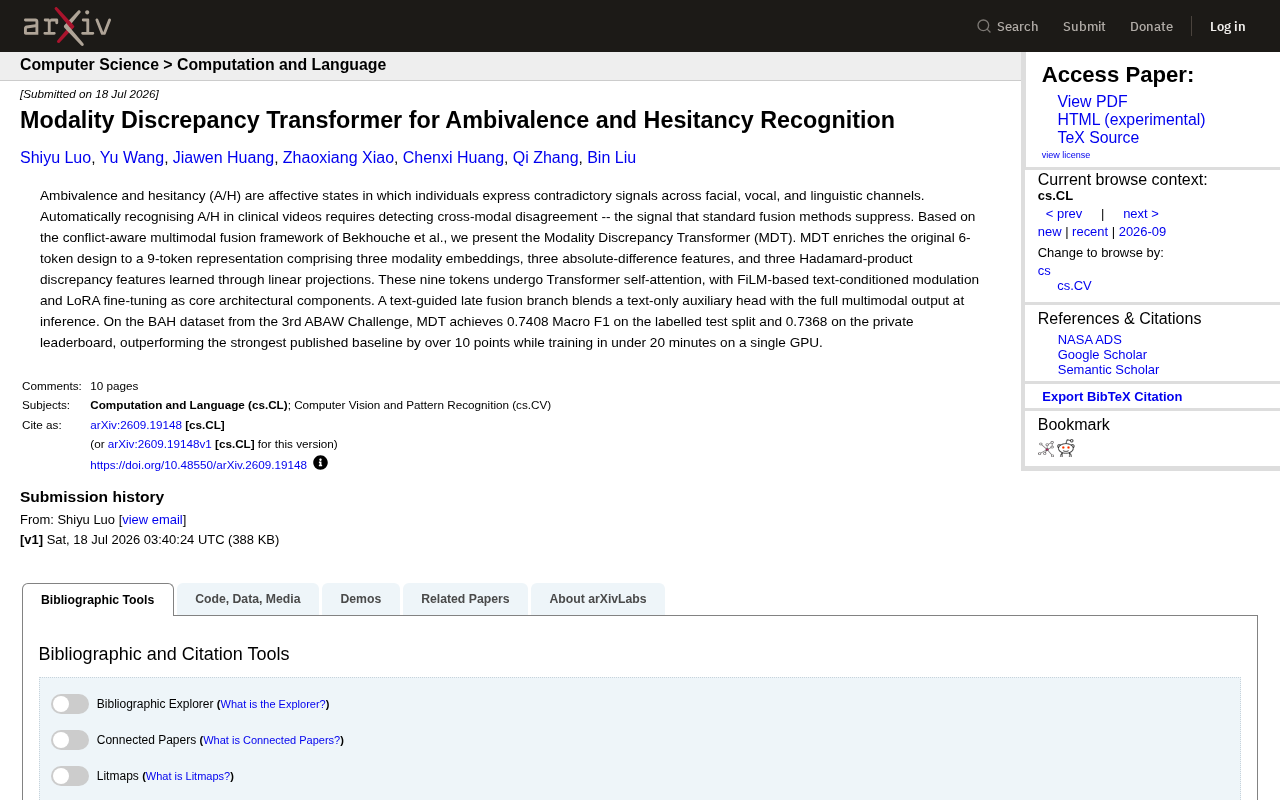
MDT通过显式编码跨模态冲突信号,将矛盾与犹豫情绪识别的Macro F1提升超10个百分点
人在表达矛盾(Ambivalence)或犹豫(Hesitancy)情绪时,面部、语音和语言往往发出相互冲突的信号。传统多模态融合方法以"求同"为目标,反而会抑制这些冲突——而冲突本身正是识别A/H情绪的关键。论文提出Modality Discrepancy Transformer(MDT),将6-token表示扩展为9-token,显式编码模态间的绝对差异与哈达玛积差异特征,配合FiLM文本条件调制、LoRA微调和文本引导后期融合三大组件,在ABAW挑战赛BAH数据集上取得0.7408 Macro F1,领先最强基线超过10个百分点,且训练全程在单块GPU上不到20分钟完成。其核心方法论启示在于:在情感计算等场景中,模态间的不一致本身即是信息,应被显式建模而非过滤。
当情绪出现"言不由衷":A/H识别的核心挑战
人的情绪表达并不总是一致的。当一个人在临床访谈中表现出矛盾(Ambivalence)或犹豫(Hesitancy)时,其面部表情、语音语调和语言内容往往会传递出相互冲突的信号——嘴上说着"我很好",声音却在颤抖,表情也透着迟疑。这种跨模态的不一致(cross-modal disagreement),恰恰是识别矛盾与犹豫(A/H)情绪的关键线索。
问题在于,绝大多数多模态融合方法的设计目标是"求同"——它们试图整合不同通道的信息,得出一个统一的判断。这类方法天然会抑制通道之间的分歧,而分歧本身正是A/H情绪最重要的诊断信号。这就构成了一个方法论上的悖论:标准融合技术把最有价值的信息当噪声给过滤掉了。
一篇发表在arXiv上的研究针对这一痛点提出了新方案——Modality Discrepancy Transformer(模态差异Transformer,简称MDT),专门用来捕捉而非抹平这些跨模态冲突。
MDT的核心思路:从6-token到9-token
MDT建立在Bekhouche等人提出的"冲突感知多模态融合框架"(conflict-aware multimodal fusion framework)之上,其最核心的创新在于把原有的6-token设计扩展为9-token表示。
三类特征,九个token
这9个token由三部分构成:
- 三个模态嵌入:分别对应面部、语音和语言三个通道的原始特征表示。
- 三个绝对差异特征(absolute-difference features):显式地度量不同模态之间的差距。
- 三个哈达玛积差异特征(Hadamard-product discrepancy features):通过逐元素乘积捕捉模态间的交互性冲突。
后两类特征通过线性投影(linear projections)学习得到。这样的设计意图非常明确——不再依赖模型"顺带"学到冲突信息,而是把跨模态差异作为一等公民显式编码进输入表示。这正是MDT区别于传统融合方法的根本之处。
哈达玛积(Hadamard product)即两个同维度向量或矩阵的逐元素乘积,记作 u⊙v,结果中每个位置的值等于两个输入在该位置的值相乘。与矩阵乘法不同,哈达玛积保留了原始的维度结构,并能捕捉两个向量在每个特征维度上的"协同或对立"关系:当两个模态在某维度上符号相同时,乘积为正(协同);符号相反时,乘积为负(对立)。
在MDT的设计中,绝对差异特征(|u - v|)和哈达玛积差异特征(u⊙v)形成互补:前者度量两个模态表示之间的"距离大小",是一种幅度层面的不一致性度量;后者则捕捉两者的"方向关系",能反映更细粒度的交互性冲突。两者共同提供了比单纯差值更丰富的冲突语义,使Transformer的注意力机制能够从多个角度理解跨模态不一致的性质与强度。
注意力机制处理冲突信号
这9个token随后进入Transformer的自注意力(self-attention)模块进行处理。注意力机制天然适合建模token之间的关联,让模型能够权衡不同模态嵌入与差异特征之间的相对重要性,从而在面对冲突信号时做出更精准的判断。
三项关键架构组件
MDT的完整性不仅体现在token设计上,还依赖三个协同工作的架构组件。
FiLM文本条件调制
MDT采用基于FiLM(Feature-wise Linear Modulation)的文本条件调制机制。语言内容在A/H识别中往往承载着最明确的语义信息,通过让文本信号调制其他特征,模型能够以语义为锚点来解读面部与语音信号的含义。
FiLM(Feature-wise Linear Modulation)是一种条件调制机制,最初由Perez等人于2018年提出,用于视觉问答任务。其核心思想是:用一个"条件信号"(如文本)生成一组缩放参数γ和偏移参数β,对另一个特征图进行逐通道的仿射变换(即 FiLM(x) = γ·x + β)。这与Batch Normalization等归一化层的形式相似,但参数不是固定的,而是由外部信号动态生成的。
在MDT中,文本模态被选为"条件源"是有充分理由的:相比面部表情和语音,语言内容通常携带更明确、更结构化的语义信息。即使说话者表现出矛盾情绪,其用词选择往往仍能提供可靠的上下文。通过FiLM让文本信号动态调节视觉和听觉特征的表示,模型能够学会"在什么语义背景下,这个表情/语调意味着什么",从而更准确地解读跨模态冲突的含义。
LoRA微调
研究使用LoRA(低秩适配)作为核心微调手段。这一选择直接关系到训练效率——LoRA只更新少量参数,大幅降低了训练成本,这也是MDT能在极短时间内完成训练的重要原因之一。
LoRA(Low-Rank Adaptation)是Hu等人于2021年提出的参数高效微调方法,专为大规模预训练模型的下游适配设计。其原理是:冻结原始模型的绝大部分权重,仅在需要更新的权重矩阵旁边并联注入两个低秩矩阵A和B(原始更新量 ΔW ≈ BA),通过训练这两个小矩阵来间接修改模型行为。由于可训练参数量远小于全量微调(通常减少99%以上),LoRA大幅降低了显存占用和训练时间。
这一选择对MDT的实用价值至关重要。A/H识别领域的标注数据通常较为稀少(BAH数据集规模有限),全量微调大模型不仅成本高昂,还面临严重的过拟合风险。LoRA的正则化效果恰好契合小样本场景的需求,既保留了预训练模型的泛化能力,又允许模型针对A/H任务的特殊性进行有针对性的适配,这是训练时间压缩至20分钟以内的核心技术保障。
文本引导的后期融合
在推理阶段,MDT引入了一个文本引导的后期融合分支(text-guided late fusion branch),将一个纯文本的辅助预测头(text-only auxiliary head)与完整的多模态输出进行混合。这一设计相当于给模型上了双保险:当多模态信号过于混乱时,纯文本判断可以提供稳定的兜底。
实验结果:以10分优势超越最强基线
MDT在第三届ABAW挑战赛的BAH数据集上进行了评测,结果颇具说服力:
- 在有标签测试集上取得 0.7408 的宏平均F1(Macro F1)
- 在私有排行榜上取得 0.7368 的Macro F1
- 相比已发表的最强基线方法,领先超过10个百分点
更值得关注的是效率表现:整个训练过程在单块GPU上不到20分钟即可完成。10分以上的性能提升配合20分钟以内的训练时间,说明MDT不是靠堆算力换效果,而是通过更合理的架构设计——显式建模冲突——实现了性价比极高的突破。
方法论层面的启示
MDT这项工作最有价值的地方,或许不在于具体的F1数字,而在于它对多模态融合范式的反思。长期以来,融合被默认理解为"整合一致信息",但在情感计算、临床诊断等场景中,信号之间的不一致本身就是信息。
把绝对差异和哈达玛积差异显式编码为token,本质上是在告诉模型:"这里的矛盾很重要,请认真对待。"这种"冲突感知"的思路,对处方任何存在通道分歧的多模态任务都具有借鉴意义,例如谎言检测、心理健康评估以及人机交互中的情绪理解。
当然,作为一篇预印本论文,MDT目前的验证仍局限于BAH单一数据集,其在更大规模、更多样化临床场景下的泛化能力还有待进一步检验。但就现有结果而言,它为矛盾与犹豫这类"言不由衷"情绪的自动识别提供了一个清晰且高效的技术路径。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。