Naive-N0.5-Flash实测:AI训练AI是真突破还是营销噱头?

Naive-N0.5-Flash以「AI训练AI」为卖点,实为基于小米开源模型的二次训练,无原创突破,更像概念营销。
Naive-N0.5-Flash是一款309B参数的MoE开源模型,其核心宣传点「完全由AI训练」实际上是行业80%公司的通行做法,并无独特性。经UP主坤蒙头实测分析,该模型本质是基于小米MiMo-V2.5进行二次训练,技术栈全部来自成熟开源方案。性能方面,单并发约2000 token/s,官方声称在SWE-bench等代码基准上表现领先,但缺乏与真正强劲对手的全面对比。部署成本方面,BF16权重高达618GB,性价比不突出,且不支持多模态。唯一值得肯定的是其曾提供完整可复现工具链,但在视频录制时已被删除。综合来看,这更多是一次成功的概念包装,而非实质性的技术突破,国产开源模型在同类竞争中依然处于领先地位。
近期一个名为 Naive-N0.5-Flash 的开源模型在海外社交平台引发讨论,其宣传的核心卖点是「完全由AI训练出来的模型」。B站UP主坤蒙头对该模型进行了实测解析,得出的结论相当直接:这更像是一次概念包装,而非真正的技术突破。本文结合其实测内容,拆解这款模型的真实成色。
「AI训练AI」的真相:并非新鲜事
该模型最抓眼球的宣传点,就是标榜自己是由AI训练出来的。但从大模型训练的实际情况看,这个说法几乎没有信息量。
据UP主分析,目前约80%的大模型公司都在用AI来驱动AI的训练流程——让模型通过强化学习(RL)的形式自我迭代、自我反馈,再进入下一轮训练,这已经是行业通行做法。不管是国内还是国外的主流开源模型,基本都在做同样的事情。
换句话说,「AI训练AI」并不是 Naive-N0.5-Flash 的独门绝技,而是被包装成卖点的行业常规操作。UP主直言,被这类名词蛊惑没有必要,模型自我迭代早已是常态。

参数规格与性能:纸面数据不算亮眼
从公开信息看,这是一个 309B 参数的 MoE(混合专家)模型,激活参数约 15.5B,原生支持 100 万 token 上下文,且并未采用全注意力机制。推理性能方面,单并发可优化到约 2000 token/s,多并发场景下可达每秒 50 token 以上。
模型定位为擅长代码研发和AI研发,官方的意图是用它来构建下一代模型。在 SWE-bench 1.1 等测试上,官方宣称仅次于部分头部模型,并称在开源模型中表现领先。
但UP主对这些数字持保留态度。以对比对象为例,同类的 flash 型号(约 500B 参数)在 token 生成速度上已能达到二三百 token/s,Naive-N0.5-Flash 的性能优势并不明显。更关键的是,它没有拿真正的强劲对手做全面对比,测试数据的说服力打了折扣。

MoE(Mixture of Experts,混合专家)架构是理解该模型参数数字的关键背景。与传统密集模型不同,MoE 模型拥有大量「专家」子网络,但每次推理时只激活其中一小部分。Naive-N0.5-Flash 总参数 309B,激活参数仅约 15.5B,意味着实际推理时只有约 5% 的参数在工作。这种设计使得推理速度和显存占用接近一个 15B 的小模型,但理论上保留了大模型的知识容量。然而,MoE 的实际效果高度依赖训练数据质量和专家路由设计,激活参数量并不能直接等同于同规模密集模型的能力。SWE-bench 是专门评估模型解决真实 GitHub issue 能力的代码基准测试,1.1 版本相比原版增加了更多高难度任务,是代码能力的重要参考指标之一,但单一基准的成绩容易通过针对性训练数据刷高,缺乏多维度对比时说服力有限。
基于小米MiMo-V2.5的「套壳」质疑
实测中一个重要发现是:Naive-N0.5-Flash 是基于小米的 MiMo-V2.5 模型进行公开训练的。
这一点让「AI造模型」的故事显得更站不住脚。UP主指出,小米自身的最新模型同样是借助AI推理进行迭代的,那么拿一个中国的开源模型再套一层「AI训练」的叙事,然后重新开源出来,本质上并没有创造出新的技术。
从技术栈看,该模型使用的全部是成熟的开源技术,与国内开源模型采用的方案高度重叠,没有造出新的原创技术。因此,所谓「AI自己训练出的模型」,更像是在既有基座上做二次训练后的营销叙事。

小米 MiMo(Mixed Modal)系列是小米技术团队发布的开源推理模型,MiMo-V2.5 是其迭代版本,在代码和数学推理任务上有较强表现,并同样采用了强化学习进行后训练优化。以已有开源模型为基座进行继续预训练或监督微调(SFT)、再结合强化学习迭代,是目前开源社区的常见做法,本身并无技术问题。但这种「在别人的模型上再训练一遍」与「从头构建一个新模型」存在本质区别——前者的知识结构和能力上限在很大程度上已由基座模型决定。当一个项目同时声称「完全由AI训练」又基于第三方开源基座时,两个叙事之间的张力值得格外注意:真正的创新点究竟在哪一层,是基座的选择、训练数据的构造,还是强化学习的奖励设计,需要清晰说明才具有可信度。
部署成本与实际能力:性价比存疑
从落地角度看,这款模型的部署门槛并不低。BF16 权重文件约 618GB,即便官方也放出了基于英伟达 Blackwell 架构的 FP8 格式版本,权重降到约 315GB,能一定程度降低推理成本,但整体部署成本依旧偏高。
能力层面,UP主认为它不如同类的顶尖开源模型,也不支持多模态。综合成本与性能来看,性价比缺乏吸引力。他还提到一个耐人寻味的细节:早上还能打开的可复现工具链,到录制时已被删除,仓库里几乎没剩什么内容,这一操作让模型的「完整开源」承诺打了问号。

值得肯定的一点:完整可复现工具链
尽管整体评价偏负面,UP主也给出了客观的肯定:该模型(在删除前)提供了一个可复现的物理环境和完整工具链。
这一点相比国内多数「只开源权重」的做法更进一步。目前国产开源模型大部分是开放权重,而完整开源可复现的整套工具链,对研究者复现和二次开发更友好。海外已有数家公司在做类似的事情,但不少公司会在开源后删掉整套工具链——Naive-N0.5-Flash 后续删除工具链的行为,恰好也印证了这种反复。
「开源权重」与「完整开源」是当前AI社区频繁讨论的重要区别。前者仅发布模型参数文件,用户可以下载运行,但无法了解训练数据、训练代码、评估流程等完整细节;后者则提供从数据处理到训练脚本、评估框架的全套可复现环境,理论上任何人都能从零复现结果。完整开源对科学可信度和社区二次创新至关重要,但也意味着更高的维护成本和潜在的知识产权顾虑,这正是许多公司在开源后悄然删除工具链的原因。OSI(开源倡议组织)近年也在积极讨论AI开源的定义标准,区分「仅开放权重」和「真正开源」已成为评估一个模型开放程度的重要维度。Naive-N0.5-Flash 先提供后删除的行为,恰好展示了这一领域承诺与实践之间落差的典型案例。
结论:不必被概念蛊惑
综合来看,Naive-N0.5-Flash 更多是一次成功的概念营销,而非真正的技术跃迁。UP主的观点很明确:
- 「AI训练AI」是行业普遍做法,不构成独特优势;
- 模型基于小米 MiMo-V2.5 二次训练,技术全部来自成熟开源方案;
- 性能与部署性价比并不突出,且不支持多模态;
- 唯一亮点是(曾经的)完整可复现工具链。
他同时表达了一个有意思的判断:理论上海外公司在算力(英伟达显卡采购无限制)和已有中国开源模型可参照的双重条件下,本应做出更强的模型。但就目前这款模型而言,在开源领域,国产模型依旧处于领先地位。对于「AI能自己训练出强模型」的叙事,理性看待、不盲目跟风才是更可取的态度。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
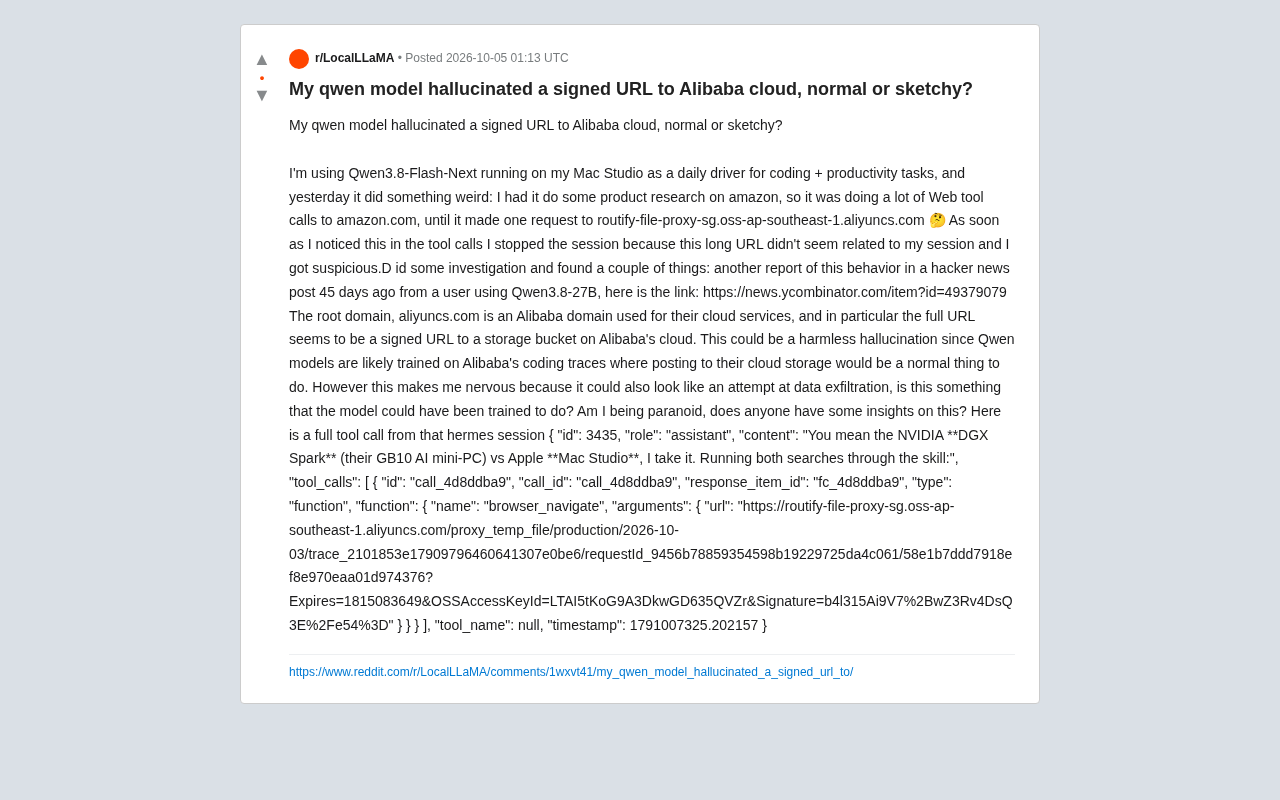
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。