NeoHorse-1-4B实测:会自我训练的本地小模型
NeoHorse-1-4B 以递归式路由日志训练实现40亿参数模型的代理与编程能力突破,但创意写作一致性有所牺牲。
NeoHorse-1-4B 是由 Token Rhythm 团队基于 Coin 3.5 框架开发的约 40 亿参数开源模型,其核心创新在于训练方式:通过观察实时路由系统的决策日志、按难度递进输入训练数据,并由更强的教师模型进行实时过程纠正,形成自我递归的改进循环。实测中,模型在代理模式下成功定位并修复了冰川洪水预警系统中"虚假安全"的隐藏逻辑漏洞,展现出超出参数量预期的工程能力。基准测试显示,它在代理、编程、指令执行等10项任务中全面领先同量级模型,优势来自训练方式而非体量。然而,递归训练带来的代价也很明显:创意写作中出现人物身份混乱等一致性问题,被认为是强化代理能力后语言流畅性退化的副作用。
科技博主 Fahd Mirza 近期在其频道演示了一款颇为特别的开源模型——NeoHorse-1-4B。这个仅有约 40 亿参数的模型基于 Coin 3.5 框架,由 Token Rhythm 团队开发。它的真正卖点不在架构,而在训练方式:通过观察一个实时路由系统的决策过程来不断改进自己。本文结合原视频的演示过程,梳理这款模型的核心理念、实测表现及其局限。
核心理念:递归式自我改进
NeoHorse-1-4B 与传统模型最大的不同,在于它并非依靠学习静态样本来提升能力,而是通过观察一个实时路由系统的运作来学习。
想象这样一个场景:一个路由器摆在一堆不同的 AI 模型面前,实时判断哪个模型该处理哪个请求。每次做出选择时,它都会默默记录下来——这是什么任务、哪个模型被选中、结果是否有效。通常这些记录只是普通的操作日志,但 NeoHorse 的训练方式把这些真实交互数据转化成了训练素材。
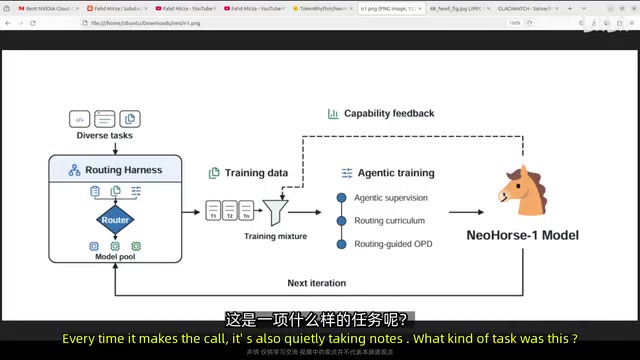
更关键的是训练顺序。这些数据按难易程度依次输入模型,让它像人类学习技能一样逐步积累能力,而不是一开始就直面高难度任务。在第二轮训练中,一个更强大的教师模型会实时观察 NeoHorse 尝试完成任务的过程并进行纠正——重点在于"当下的纠正",而非直接给出预写好的标准答案。
这里形成了一个自我递归的循环:改进后的模型重新投入使用后,又会生成新的日志,这些日志再用于训练下一个版本。需要说明的是,这种递归发生在训练阶段,推理阶段并不会触发。
这种训练范式在学术上与"课程学习"(Curriculum Learning)密切相关——由 Bengio 等人在 2009 年提出的思想:按由易到难的顺序安排训练样本,能帮助模型更稳定地收敛,避免早期接触过难样本导致梯度混乱。NeoHorse 的做法可以看作课程学习在真实系统日志上的一次工程实践。
教师模型实时纠正的环节,则与"在线蒸馏"(Online Distillation)或"过程奖励模型"(Process Reward Model, PRM)的思路有所重叠:与传统知识蒸馏事先准备好软标签不同,这里的教师模型在学生模型推理的同时给出反馈,监督的是中间步骤而非仅仅最终答案。这种对"过程"而非"结果"的监督,被认为更有利于培养模型的推理链质量,近期 OpenAI 和 DeepMind 的多项研究都印证了这一方向的潜力。
实测演示:找出冰川洪水预警系统的隐藏漏洞
为了验证模型的实际能力,博主搭建了一个名为 GlacierWatch 的应用——一个为山谷下游六个城镇设计的冰川洪水预警系统。这套系统使用 Docker 部署了前后端组件,包括 Redis 缓存和实际数据库,并从应用中获取实时数据进行分析与统计。
这个演示暗藏一个严重的逻辑漏洞:即便模拟溃坝、冰川融化、裂隙形成、警报触发,系统顶部仍然固执地显示"淹没区内无人员",水位高度也显示为零。博主指出,这正是此类系统中最危险的 bug——一种"虚假的安全无患"假象。
他将模型配置为通过 Hermes 代理运行,只给它下达一个目标:自己去发现并修复所有漏洞,而没有告诉它具体该怎么做。模型以 VLM 形式在本地运行,博主也展示了其显存消耗(含 KV 缓存)。
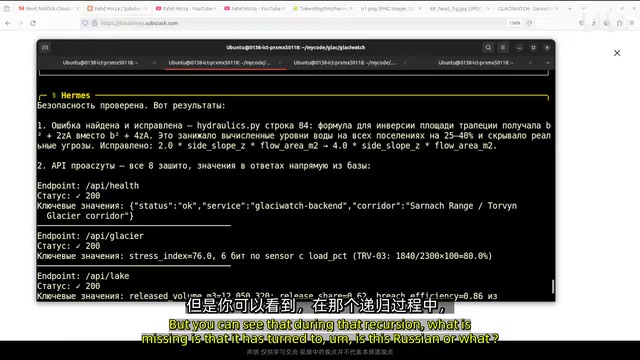
运行过程中,这个 40 亿参数的模型进行了大量递归运算——反复检查每个端点,最终返回 200 结果。刷新页面后,系统正确显示出淹没区内有超过 4.1 万人,堤坝溃决区域被标黄,红色警戒水位线也如期出现。博主评价:"一个只有 41 亿参数的模型真的做到了超出预期的水平。"不过他也注意到递归过程中出现了奇怪的现象——模型的思考过程一度"转向",夹杂了疑似俄语的内容。
演示中提到的 Hermes 代理框架,是一种为 LLM 提供工具调用与多步骤规划能力的代理编排层。模型在代理模式下运行时,并非一次性输出答案,而是反复执行"思考→调用工具→观察结果→再思考"的循环,直至达成目标。这也解释了为何一个 40 亿参数的小模型能完成看似复杂的 bug 排查:真正的"智能"部分由多轮迭代循环承担,而非单次推理。
值得注意的是,演示中出现的疑似俄语内容,可能源于训练数据中多语言日志的混入,也可能是模型在递归推理压力较大时出现的"语言漂移"现象——这在小参数量模型上相对更容易复现,因为其注意力机制维护长上下文一致性的能力本就有限。
基准测试:小体量下的全面表现
开发团队将 NeoHorse-1-4B 与五个同量级(约 40 亿参数)的小型模型进行了对比。
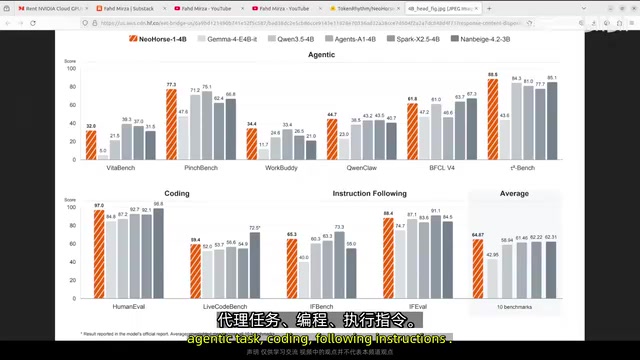
结果显示,在代理任务、编程、指令执行等几乎每一个类别中,这个新模型都名列前茅或处于顶尖位置。博主特别强调了最右侧那个数字——所有 10 项测试基准的平均分。这个平均分之所以有意义,是因为它说明模型并非只在单一领域出彩,而是各方面表现都相当均衡。
博主总结道,NeoHorse 并不是靠"体量最大"取胜,而是靠"训练方式与众不同"取胜。这与它递归式自我改进的设计理念相互印证。
创意写作短板:递归训练的代价
编程测试之后,博主又设计了一个截然不同的创意写作任务:以一位独居移民为主角,把他一周内收到的 WhatsApp 垃圾信息、电子账单等日常琐碎素材,转化成一篇探讨现代社会孤独与联系的深度非虚构文章。
模型的表现喜忧参半。从结构和技术实现上看相当流畅,在文学美学方面也有不少亮点——片段运用、空白处理、省略号乃至表情符号的设计都可圈可点。但问题也很明显:叙事中的人物身份始终不稳定,从母亲、儿子、女儿到孙子来回跳转,最后混成了同一个人,读起来令人困惑。
博主推测,这正是递归训练带来的副作用——模型在获得强大编程与代理能力的同时,失去了原版 Coin 模型那种语言流畅性和一致性。他直言:"说到创造性写作,我觉得它还是不如那个 41 亿参数的 Coin 模型表现得那么好。"
模型在创意写作上出现人物身份混乱,在技术上对应的是"指代一致性"(Coreference Resolution)能力的退化。递归训练大量使用以任务完成率、代码运行结果为奖励信号的反馈,这类信号对"谁是谁"这类叙事层面的约束几乎没有显式监督。长期在强化此类信号下微调,模型很可能在语言建模的通用能力上产生遗忘——这与持续学习领域所说的"灾难性遗忘"(Catastrophic Forgetting)现象一致:新能力的强化往往以牺牲旧能力为代价,尤其在参数量有限的小模型上表现更为明显。
值得关注的地方
NeoHorse-1-4B 的价值不在于它是一个完美的通用模型,而在于它演示了一条不同的能力提升路径:通过观察真实的路由决策日志、按难度递进训练、由教师模型实时纠正,最终形成自我递归的改进循环。
对于关注本地部署和代理型任务的开发者来说,它在编程和 bug 排查上的表现值得一试;但如果核心需求是创意写作或需要长文一致性的场景,则要谨慎评估。正如博主所说,每个人最了解自己的需求,这款模型能做什么、不能做什么,最终还需在实际使用场景中进一步探索。
相关推荐
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。
从零打造AI代理电商:用多智能体构建按需印花业务实录
海外博主用AI编程工具从零构建按需印花电商公司Keepsake Threads的实战记录:如何配置专业化Agent、用GPT-5.6与Claude Fable多模型编排突破架构阻塞,并沉淀可复用技能。真实展示AI代理创业的方法论与局限。