你的AI Agent不需要更大的模型,而是更好的上下文

Agent频繁出错的真正原因是上下文破碎,而非模型不够强,Redis+MCP可为Agent构建跨会话累积的记忆层。
这篇文章的核心论点是:AI Agent的失败根源往往不是模型能力不足,而是喂给模型的上下文本身有问题。文章归纳了三种典型失败模式——数据孤岛导致的「死胡同」、数据过期导致的「陈旧状态」、串行API调用导致的「高延迟」——并提出生产级上下文系统必须满足可导航、新鲜、快速、可复利四条规则。针对大多数团队因数据管道碎片化而无法满足这些规则的困境,文章介绍了工作记忆与长期记忆两层架构,并以Redis+MCP的实战演示展示了如何让编码Agent在全新会话中自动检索语义相关的历史约定,并从普通对话中自动抽取耐久事实,实现真正跨会话复利的上下文积累。
为什么你的Agent总是出错?
多数团队在AI Agent表现不佳时,第一反应是换一个更大、更强的旗舰模型。但一份来自Redis的报告和大量生产环境的实践经验都指向同一个结论:Agent失败往往不是因为模型不够聪明,而是因为你喂给它的上下文(Context)本身是破碎的。
换句话说,给Agent提供结构化、精准的上下文,几乎每一次都胜过把它升级成一个庞大的旗舰模型。真正的问题不是智能,而是如何在正确的时间把正确的信息送到模型手里。这篇文章会拆解Agent常见的架构失败模式,并通过Redis+MCP的实例演示如何构建一个会「记忆」的上下文层。
三种典型的上下文失败模式
以一个客服Agent为例,用户询问订单状态,看似简单的任务却隐藏着三类致命问题。
死胡同(Dead End)
Agent拉取到了工单(support ticket),但工单和订单记录分别躺在不同的数据孤岛里,两者之间没有任何关系路径可供遍历。当模型「看不见」关联数据时,它会做语言模型最擅长的事——直接编造(hallucinate)。
陈旧状态(Stale State)
Agent找到了订单,但数据来自12小时前的一次导出。实际上包裹今早已经发货,Agent却毫不犹豫地告诉用户「还没发货」,自信地给出了错误答案。数据新鲜度在这里直接决定了回答的对错。
延迟(Latency)
Agent拿到了正确数据,但为此在三个不同API之间串行发起了八次往返调用。等它终于响应时,用户早已关闭了会话。延迟直接拖垮了整个工作流。
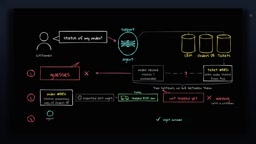
这三种情况下,模型的推理能力都没有问题。失败的根源在于上下文——而且这种破坏往往是在你毫无察觉的情况下悄悄发生的。
上下文工程 ≠ 提示工程
很多人把Context Engineering和Prompt Engineering混为一谈,但两者是完全不同的层次。
提示工程关注的是你如何组织给模型的初始指令:调整措辞、添加几个少样本示例、强制一个输出Schema。它本质上是在打磨一个静态字符串,有用,但只停留在输入这一层。
上下文工程则是构建模型周围的整个运行时环境——一个实时系统,决定Agent在每一步都能看到什么状态:该取哪条客户记录、该检查哪个实时状态、如何足够快地把这些信息交付到生产环境。一句话总结:提示工程是你对模型「说」什么,上下文工程是你围绕它「建」什么。
「上下文工程」(Context Engineering)这一术语在2025年前后随着Agent应用的规模化落地而逐渐成型,核心洞察是:语言模型的推理能力已相当充裕,瓶颈往往在于模型在推理时刻能「看到」什么信息。传统提示工程通常是离线、静态的——工程师一次性手写一个模板,运行时几乎不变。上下文工程则是动态、运行时的:每次调用之前,系统需要决定从哪里取什么数据、取多少、以何种结构注入到模型的上下文窗口中。这一区别在长任务链的Agent场景中尤为重要——单次对话可能触发数十次工具调用,每一步的输入都依赖前几步的输出动态组装,静态提示根本无力覆盖这种复杂度。
生产级上下文的四条机械规则
回到前面的失败模式,一个真正可用于生产的上下文系统必须同时满足四个条件:
- 可导航(Navigable):Agent必须能够遍历用户、订单、工单等实体之间的关系,而不是对原始文本做盲目的关键词查找。
- 新鲜(Fresh):如果Agent基于陈旧状态行动,它只会「自信地犯错」。
- 快速(Fast):当一个任务触发数十个子查询时,查询延迟会直接累积成崩溃的工作流。
- 可复利(Compound):这是大多数系统忽略的一点。今天当Agent会话结束,它的上下文被清零;明天同一个用户回来,模型又得重新学习对方是谁、用什么约定、上次哪里出了问题。真正高效的生产系统应该越用越聪明,让学到的东西随时间累积。
为什么大多数团队建不出来?
问题的根源在于组织性的碎片化。设想三个团队:A团队为文档搜索搭了独立的向量数据库,运行良好;B团队在另一套存储上自己写了持久化脚本,也运行良好;C团队又拼接了另外一批工具。
问题是,它们彼此之间谁都不认识。半年之后,你会拥有十几条互不连通的数据管道,没人能保证数据的新鲜度,而每一个新Agent都要把大部分时间花在重建上下文的「管道工程」上。这正是当下大多数工程组织的真实写照。
让上下文跨会话复利:两种记忆
要让Agent的上下文能够累积,它需要两类记忆。
**工作记忆(Working Memory)**是活跃任务的草稿本,保存即时的工具调用和执行状态。会话结束时它会被清空。
**长期记忆(Long-term Memory)**存储必须跨会话、跨运行存活的持久事实,比如项目决策、环境配置、调试过的边界情况。
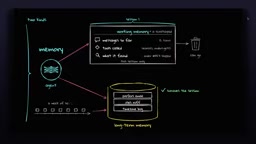
真正的难点在于事实如何在两者之间流转。你不能指望用户手动给每条事实打标签,因此需要一个自动化的记忆层,在后台解析对话、抽取出耐久的事实。当新会话启动时,它通过语义搜索只拉取与当前任务相关的历史事实。同时还要防止记忆变成「堆满杂物的抽屉」——引擎需要处理去重和过期,丢弃临时噪音,同时固定住永久的项目规则。这样上下文才能同时做到可导航、新鲜、快速且可复利。
工作记忆与长期记忆的划分借鉴了认知科学中的人类记忆模型。在Agent系统的工程实现中,两者对存储介质的要求截然不同:工作记忆追求极低延迟和高吞吐,通常存放在进程内存或Redis这类内存数据库中,会话结束即清除;长期记忆则需要持久化、可语义检索,通常以向量嵌入的形式存入带有向量索引的数据库,以便后续通过近似最近邻(ANN)搜索按语义相关性召回,而非依赖精确的关键词匹配。Redis Stack通过内置的RediSearch模块同时支持哈希存储与向量索引,使得同一个实例可以同时承担两类记忆的存储职责,避免了引入额外向量数据库带来的架构复杂度。
实战:用Redis + MCP给Agent装上记忆
作者用DeepSeek广告 harness配合一个Flash模型做了演示。默认情况下,这个harness没有跨会话记忆——而这正是要补上的能力。
做法是通过一个MCP Server接入Redis Agent Memory Server。底层Redis将每条记忆存为一个哈希(hash)并附带一个向量,因此可以按语义而非简单关键词来检索。集成只需一个YAML文件,声明一个名为redis memory的MCP server,URL的最后一段作为命名空间(namespace),确保该Agent存储的一切都限定在这个项目范围内。启动后模型会向MCP server询问可用工具,这里会得到创建、搜索、编辑、删除记忆等十个工具。
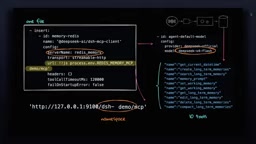
实验分两个会话进行。会话A中,作者告诉Agent几条项目约定:使用uv做依赖管理、用ruff做linting、每个函数必须保持纯函数并返回新的元组。由于MCP已连接,Agent先检查记忆发现空无一物(干净起步),随即调用创建长期记忆的工具,将这三条事实分别存入Redis。查询记忆服务器就能看到这三条记忆的原始哈希,包含文本、命名空间、用户、主题以及用于语义检索的向量。
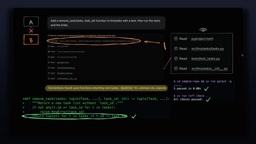
会话B是同一仓库下的全新会话,没有任何聊天历史。作者要求它添加一个带测试的remove task函数,并运行测试和linter。在读取任何文件之前,Agent先调用了搜索长期记忆的工具,拿到之前的约定,然后才编写代码。最终产出的diff是纯函数、返回新元组,精确匹配此前描述的风格,uv run test跑出五个测试全部通过。
两个验证实验
第一个实验验证检索是否真的基于语义。作者问记忆服务器「这个仓库用哪个linter和包管理器」,这两个关键词都没出现在存储的记忆里,但系统仍以最低距离命中了ruff——证明它做的是语义搜索而非关键词匹配。
第二个实验验证记忆能否自主生长。作者只是把一段普通对话推入工作记忆(用户表示偏好类型注解和描述性的测试命名),并没有明确要求存储。但服务器日志显示「extraction completed, one memory extracted」——Agent自动从对话中抽取了有用信息并写入基于Redis的长期记忆。这意味着系统学到的东西会随使用而复利。
MCP(Model Context Protocol)是由Anthropic于2024年底提出的开放协议,目标是为AI模型与外部工具、数据源之间的交互定义一套标准接口。在MCP出现之前,每个Agent框架都有自己的工具调用约定,导致工具实现与框架深度耦合、难以复用。MCP将这一层标准化:工具提供方(MCP Server)以统一格式声明自己的能力列表,客户端(模型/Agent)在运行时动态发现并调用这些工具,双方通过JSON-RPC通信。对于记忆场景而言,这意味着Redis Agent Memory Server只需实现一次MCP接口,就能被任何兼容MCP的编码Agent(Claude、DeepSeek、Cursor等)直接复用,无需为每个框架单独适配。这正是文中「集成只需一个YAML文件」的原因所在。
结论:建记忆层,而不是堆参数
整篇演示指向一个清晰的判断:你提供的上下文质量,比模型的参数规模更重要。要做到这一点,Agent需要一个优秀的记忆层,Redis正是一个很好的例子,并且可以通过MCP server接入任何编码Agent。这种方式能在不牺牲准确性和性能的前提下,持续为Agent提供更好的上下文——而且越用越聪明。
下次当你的Agent又出错时,先别急着换更大的模型,不妨检查一下你喂给它的上下文是不是已经坏了。
相关推荐
用n8n搭建WhatsApp智能线索自动化:AI分级让商机不再流失
拆解一个基于n8n的WhatsApp线索自动化工作流:用AI把客户消息分为hot/warm/cold四级,自动应答并评分,仅在高价值线索出现时通知老板,帮助中小企业高效管理商机、节省人力。

Arabagent.ai:面向中东市场的托管式N8N自动化方案
Arabagent.ai 面向中东市场提供托管式 N8N 自动化服务,含私有工作空间、无限工作流执行、AI 自愈架构及阿拉伯语双语支持,兼顾开源可控性与 SaaS 便捷。

用 n8n 打造 Gmail→Google Sheets 自动化 CRM 实战教程
手把手教你用 n8n 搭建 Gmail 到 Google Sheets 的 AI 自动化 CRM:收到邮件自动触发,由 OpenAI 读取理解内容并提炼任务信息写入待办表格,含触发器、AI 智能体、提示词与 Sheets 工具的完整配置步骤。