Nike用MCP与AI智能体打造自愈遥测系统
Nike 用 OTLP、OpAMP 和 MCP 构建闭环遥测系统,让 AI 智能体在代码化护栏下参与运维决策。
Nike 前可观测性平台工程总监 Panos Tsilopoulos 分享了如何基于 OpenTelemetry、OpAMP 和 MCP 协议构建闭环遥测系统,管理约 10 万个 OpenTelemetry Collector。系统将 OTLP 用于数据标准化、OpAMP 用于 Collector 控制、MCP 用于 AI 智能体结构化访问,形成“观察-提案-审批-下发-验证”的闭环。智能体仅拥有只读工具和创建提案的写工具,无 apply 权限。护栏完全代码化,采用允许列表与拒绝列表双轨制,拒绝列表优先级更高且变更极易识别。生产案例显示,双十一前混沌实验导致指标基数激增 30% 击垮 Mimir 环,凸显自动化基数控制的必要性。核心原则是把安全边界放在架构而非提示词中。
当遥测管道学会自我调节:Nike的闭环控制实践
在Observability领域,一个长期存在的矛盾是:系统越复杂,配置管理越容易成为瓶颈。Nike前可观测性平台工程总监Panos Tsilopoulos在近期演讲中,分享了他们如何用OpenTelemetry、OpAMP和MCP协议构建闭环遥测系统,让AI智能体在严格护栏下参与运维决策。据其透露,Nike在黑色星期五等大促期间需要管理约10万个OpenTelemetry Collector,而团队规模却小得“像一群用胶带粘起来的人”。
为什么自建控制平面
一年半前,市场上几乎没有成熟的商业方案能解决Nike规模的问题。Bindplane是当时少有的选择,但其成本对Nike而言难以承受。于是团队基于OpAMP协议自建控制平面,将Collector按拓扑和基础设施分组,以控制变更爆炸半径。Panos强调,OpAMP本质上是网络协议,一次推送可能影响整个舰队,因此分组管理是安全底线。
OpenTelemetry Collector 是 CNCF 旗下的厂商中立遥测数据采集器,支持接收、处理和导出指标、日志与追踪数据。其配置通过 YAML 定义,包含 receivers、processors、exporters 和 service 等段落。在大规模部署中,Collector 通常以舰队形式运行,每个实例承担特定数据管道的处理任务。Nike 管理约 10 万个 Collector,意味着配置变更需要精确控制影响范围,否则一次错误推送可能引发全局故障。
OpAMP(Open Agent Management Protocol) 是 OpenTelemetry 生态中用于远程管理采集器舰队的开放协议。它定义了服务器与代理之间的通信机制,支持下发配置、上报状态和健康检查。OpAMP 本身不规定配置内容,而是提供安全的传输和分组能力。Nike 利用 OpAMP 的组管理功能,将 Collector 按拓扑和基础设施分组,从而将变更爆炸半径限制在可控范围内。
三个协议的分工与闭环
OTLP标准化数据侧,OpAMP标准化Collector控制侧,MCP则标准化AI智能体对两者的结构化访问。三者结合形成闭环:智能体通过MCP只读工具观察遥测后端和舰队状态,起草配置变更提案,经人类审批后由OpAMP服务器下发到Collector,再根据验证结果决定全量推广或回滚。据演讲现场演示,整个流程中人类只需做两个动作:审核提案和批准执行。
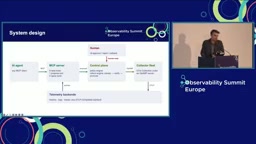
MCP(Model Context Protocol) 是由 Anthropic 提出的开放协议,用于标准化 AI 智能体与外部工具、数据源之间的结构化交互。MCP 服务器暴露工具(tools),智能体通过调用这些工具执行查询或操作。在 Nike 的闭环中,MCP 充当智能体访问遥测后端和舰队状态的统一接口。工具分为只读工具(如查询指标、日志、舰队概览)和写工具(仅创建提案),且 CI 会阻止任何具备 apply 能力的工具合入。这种设计确保智能体的行动范围被严格限定在观察和提案阶段,实际变更仍需人类审批和 OpAMP 下发。
典型场景:基数爆炸与采样恢复
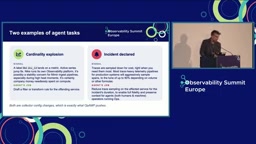
零售场景中,SKU等产品标签落到指标上会导致活跃时间序列指数级增长。Nike自建的可观测平台基于Grafana和ClickHouse,日处理约200TB数据,基数爆炸可能危及Mimir稳定性,即便不宕机也是不必要的算力浪费。智能体的任务是为问题服务起草过滤或转换规则。另一个场景是事故期间降低受影响服务的追踪采样率,以恢复全保真上下文。Panos分享了一个生产案例:中国区双十一前的大规模混沌实验中,一个变更导致多个指标基数增加30%,直接击垮了该区域的Mimir环——而双十一当天Nike中国区收入约占全年50%,约50亿美元。
基数(Cardinality) 在可观测性中指指标标签组合的唯一数量。每个唯一的标签组合会生成一个独立的时间序列,存储在时序数据库(如 Mimir、Prometheus)中。当标签值具有高基数特性(如 SKU、用户 ID、请求 ID)时,时间序列数量可能指数级增长,导致内存和存储压力骤增,甚至击垮时序数据库。Nike 的零售场景中,产品标签落到指标上极易引发基数爆炸。智能体的任务是通过起草过滤或转换规则,在 Collector 的 processor 层剔除或聚合高基数标签,从而保护后端稳定性。
护栏即代码:架构边界而非提示词
Nike的护栏体系完全代码化、版本控制。策略是一个YAML文件,任何进入生产的变更都必须经过代码审查。其中最值得关注的是允许列表与拒绝列表并存的 设计。允许列表定义智能体当前可以做什么,从最初的5条增长到约20条;拒绝列表则是绝不跨越的红线,例如“永远不允许智能体将遥测数据重定向到其他目的地”,即导出器配置永远在拒绝列表中。Panos解释道,保留两者是为了防止允许列表被宽泛条目(如processors.*)意外扩大——拒绝列表优先级更高,且其变更在代码审查中极易被识别。
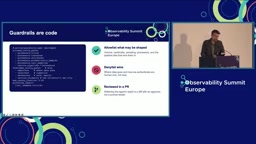
其他质量门包括:证据收据——不要求智能体输出文本摘要(“它们是惯于胡扯的”),而是要求附上实际执行的查询和返回数据;受保护标签——Tier 0关键服务的配置智能体不可触碰,即使问题波及这些服务,智能体也只能修改其余部分;以及金丝雀发布(先推送到不超过5%的舰队)、验证门和自动回滚。MCP工具层面同样有硬性约束:写工具只有一个创建提案的工具,不存在apply工具,若有人试图在CI中添加具有apply能力的MCP工具,构建会直接失败。
金丝雀发布(Canary Release) 是一种降低变更风险的部署策略,先将变更推送到一小部分目标实例(如不超过 5% 的舰队),观察验证指标是否正常,再逐步扩大范围。在 Nike 的闭环中,金丝雀发布与验证门、自动回滚结合:智能体提案经批准后,OpAMP 服务器先将配置下发到少量 Collector,遥测数据回传后由系统自动验证基数是否恢复、指标是否丢失。若验证通过则全量推广,否则自动回滚。这种机制将变更失败的影响面控制在最小范围,尤其适用于管理十万级 Collector 舰队的场景。
演示中的拒绝与修正
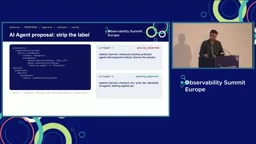
现场演示模拟了checkout服务的基数爆炸。Claude通过MCP工具依次调用舰队概览、指标查询和日志查询,定位到新增的一行标签导致问题,并附上证据数据起草转换规则。第一次提案使用service=checkout选择器,被策略拒绝——因为该标签受保护,会波及支付关键Collector。智能体收到纯语言反馈后,将选择器缩小到tier=standard重新提案,获得通过。人类审核批准后,变更先下发到40个模拟Collector中的2到5%,遥测回传显示基数恢复正常且指标无丢失,随后推广到剩余38个。
失败模式与落地建议
Panos坦承这套系统的测试套件是靠“自己攻击护栏”逐步建立起来的,初期非常脆弱。关于提案形态,演示中只是本地文本,生产系统中自然会想到GitHub风格的Pull Request,但OpAMP最简实现是无状态的,需要额外数据库支持。他的三条收尾建议是:把边界放在架构里,而不是提示词里;护栏是生产集成的一部分;开放标准节点让系统可移植。对于希望复刻此路径的团队,这意味着AI智能体的价值不在于替代人类决策,而在于把人类从重复的观测和起草中解放出来,同时用工程化护栏守住不可逾越的底线。
相关推荐

64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。
Ollama零基础教程:本地部署大模型入门指南
Ollama零基础入门教程:了解Ollama是什么、核心特点与本地部署大模型的价值。涵盖开源免费、跨平台、CPU/GPU调度、API集成等关键信息,助你快速上手本地大模型管理工具。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。