NOPO:仅用负样本强化学习,破解单边验证难题

NOPO仅用可信负样本抑制策略,在单边可验证场景下提升pass@k。
本文解读了 Negative-Only Policy Optimization(NOPO)方法,旨在解决强化学习与可验证奖励(RLVR)在单边可验证性(OSV)场景下的失效问题。OSV 指验证器只能可靠证伪负样本,而正样本可能包含假阳性,导致标准 RLVR 奖励走捷径行为。NOPO 将正样本视为无标签数据,仅通过抑制可信负样本更新策略,并结合参考相对负抑制损失和组级适配器实现稳健优化。在单元测试、约束检查和 LLM 自验证器三种设置下,NOPO 在代码、逻辑和数学基准的 pass@k 指标上优于基线,且增益在推理时缩放和跨基准迁移中保持。该方法降低了对完美验证器的依赖,为弱验证环境提供了可行方案。
强化学习与可验证奖励(RLVR)在代码生成、逻辑推理等任务中表现出色,但其核心假设——存在一个能可靠判断解是否正确的验证器——在现实场景中往往难以满足。许多情况下,我们只能获得廉价的否定性检查:能够可靠地证伪错误解,却无法确认正确解。这种不对称性催生了新的研究问题:如何在这种“单边可验证”(One-Sided Verifiability, OSV)条件下进行有效的策略优化?
近期一篇论文提出 Negative-Only Policy Optimization (NOPO),通过仅利用可信的负样本(被验证器证伪的解)来更新策略,在单元测试、约束检查和LLM自验证器等场景下,显著提升了pass@k指标。本文将深入解读这一方法的核心思想、技术细节与实验表现。
单边可验证性:当验证器只会说“不”
传统RLVR假设验证器能够可靠地判断解的正确性(即双边可验证)。但在许多实际应用中,完备的验证要么成本过高,要么根本不可行。例如,在代码生成中,单元测试只能捕捉部分错误,无法证明代码完全正确;在约束满足问题中,检查器可以快速发现违反约束的解,但满足约束的解未必是全局最优;在LLM自验证中,模型能够识别一些明显的错误,却可能放过隐蔽的缺陷。
论文将这种场景形式化为 单边可验证性(OSV):验证器给出的负样本是可靠的反例(verified negatives),而正样本仅仅是“未被证伪的候选”(non-falsified candidates),其中可能包含大量假阳性。这种不对称性使得标准RLVR不可靠——强化那些“通过部分检查”的正样本,可能直接奖励了走捷径的行为,导致策略学到表面通过检查但实际错误的解。
假阳性(False Positive) 在本文语境中指那些未被验证器证伪、但实际错误的解。由于 OSV 下验证器只能提供否定性证据,任何通过检查的解都只是“未被证伪的候选”,而非被确认的正确解。假阳性的存在意味着直接强化这些正样本会引入错误的学习信号,使策略倾向于生成表面合规但实质错误的输出。NOPO 的设计正是为了规避这一风险,将正样本视为无标签数据,仅依赖可靠的负样本进行更新。
NOPO:只抑制负样本的策略优化
针对OSV的挑战,NOPO的核心思想是:将验证通过的正样本视为无标签数据,仅通过抑制可信的负样本来更新策略。具体而言,NOPO结合了两个关键组件:
- 参考相对负抑制损失(Reference-Relative Negative Suppression Loss):在抑制负样本时,以参考策略为基准,避免策略过度偏离初始分布,从而保持探索能力。这种相对损失设计有助于稳定训练,防止模型在负样本上过度矫正。
- 组级适配器(Group-Level Adapter):根据每个组中未被证伪的响应比例,缩放更新幅度。如果一组解中大多数都未被证伪(即负样本比例低),则更新幅度较小;反之,负样本比例高时,更新幅度增大。这使得策略能够自适应地利用负样本信息,避免在正样本比例过高时过度抑制。
通过这种方式,NOPO绕过了对正样本可靠性的依赖,仅从可靠的负样本中学习,同时利用组级信息调整更新强度,实现稳健的策略优化。
参考策略(Reference Policy) 通常指强化学习微调前的初始模型(如预训练或监督微调后的模型),其分布代表了模型已有的先验知识。在 NOPO 中,参考相对负抑制损失以参考策略为锚点,惩罚当前策略与参考策略在负样本上的概率差异,而非直接最大化负样本的负对数似然。这种相对形式限制了策略更新的幅度,防止模型因过度抑制负样本而遗忘通用能力或陷入模式崩溃,是稳定训练的关键设计。
实验验证:多场景下的性能提升
论文在单元测试、约束检查和LLM自验证器三种验证器设置下,针对代码、逻辑和数学基准测试评估了NOPO。当oracle奖励(即完美验证器)不可用时,NOPO在pass@k指标上优于基线方法。这些增益在推理时缩放(inference-time scaling)和跨基准迁移(cross-benchmark transfer)条件下依然保持,表明NOPO具有良好的泛化性和可扩展性。
你可能没注意到,NOPO的优势在于它不要求验证器完美,只需能够可靠地识别负样本。这大大降低了RLVR在实际应用中的门槛,为那些只能获得部分验证信号的场景提供了可行的强化学习方案。
pass@k 是代码生成和推理任务中常用的评估指标,表示从模型独立采样 k 个解时,至少有一个解通过验证(或满足正确性标准)的概率。与 pass@1 相比,pass@k 更能反映模型输出分布的多样性和覆盖能力。在 OSV 场景下,由于验证器只能证伪负样本,pass@k 的计算通常依赖 oracle 验证器(完美验证器)进行最终评判,以区分真正的正确解与假阳性。NOPO 在 pass@k 上的提升表明,仅利用负样本抑制也能间接改善正样本的生成质量。
启示与展望
NOPO的提出为RLVR在弱验证环境下的应用开辟了新思路。其“仅用负样本”的策略不仅适用于代码生成,也可推广到任何具备廉价否定性检查的任务中,如安全对齐、逻辑推理和科学假设筛选。未来工作可以进一步探索如何结合少量可靠正样本与大量负样本,以及如何设计更高效的组级适配器。
对于AI研究者和工程师而言,NOPO提醒我们:在验证资源有限时,巧妙地利用否定性信号可能比追求完美验证器更实际。随着模型规模增大和任务复杂化,这种鲁棒的优化方法将愈发重要。
相关推荐
Gemini 4 Neon实测:半价挑战Opus 5.5,谁更强?
基于多位开发者实测与第三方基准,解析Gemini 4 Neon与Claude Opus 5.5的真实差距:智能指数、编程能力、每任务成本与适用场景,揭示半价说法的真相。
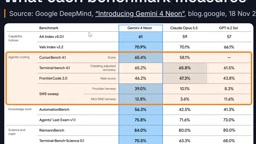
Gemini 4 Neon基准全解读:与Opus、ChatGPT 6.2硬碰硬
逐项拆解 Gemini 4 Neon 官方基准表:整体略胜 Opus 与 ChatGPT 6.2,终端任务反落后 0.5,长上下文区间优势明显,成本与速度三项全赢。附 Carbon/Neon/Hydrogen 三型号定位与按任务选型建议。
Gemini 4 Neon编程测试39%与12.8%之谜:工具差异还是模型实力?
Gemini 4 Neon在SWE-bench上出现39%与12.8%两个分数,与GPT-6.2 Sol的差距从30.7个百分点缩至1.2。本文解析代理工具差异如何影响编程基准得分,并给出受控测试建议。