Gemini 4 Neon基准全解读:与Opus、ChatGPT 6.2硬碰硬
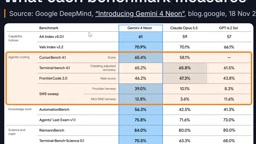
Gemini 4 Neon 综合跑分微超 Opus,长上下文优势显著,按任务分层选型更实际。
文章拆解了 Google DeepMind 新发布的 Gemini 4 家族成员 Neon,并与 Opus、ChatGPT 6.2 做横向对比。Neon 综合得分领先,但终端操作类任务落后约 0.5,属于噪音区间。真正拉开差距的是 256K 到 1M 长上下文区间,领先幅度被描述为 15 到 30;网络安全基准以 76 对 68 领先。Artificial Analysis 数据显示 Neon 在智能水平(61 对 59)、响应速度和单任务成本三项均优于 Opus。Gemini 4 三型号分层:Carbon 处理最复杂长周期任务,Neon 为日常主力,Hydrogen 主打快速响应。选型建议按任务类型分流,而非按跑分排名。
Google DeepMind 又发布新模型了。这次登场的 Gemini 4 家族成员名为 Neon,和它一同亮相的还有 Carbon 和 Hydrogen。一位 YouTube 创作者逐项拆解了官方基准表,并与 Opus、ChatGPT 6.2 做了横向对比。这篇文章把其中的关键信息、容易被忽略的细节,以及"跑分赢了是否等于好用"这个问题,一次讲清楚。
Neon 在基准表上的位置:整体领先,但优势很薄
先看综合得分。作者提到,这个总分不是只算编程或只算专业工作,而是把各类任务的平均成绩汇总后的结果。Neon 在这张总表上超过了 Opus 和 ChatGPT 6.2。
但"超过"的幅度需要冷静看待。在终端操作类任务上,Neon 反而落后于 Opus,差距只有 0.5;另一处对比中差距是 0.8。作者的原话是"不到百分之一"。换句话说,这不是代际碾压,而是同一水平线上的微弱身位差。
这种量级的差距,落到真实工作流里很可能被提示词质量、上下文组织方式、工具链配置等因素淹没。基准表能告诉你"谁的平均分高一点",但告诉不了你"你的项目里谁更顺手"。
分项拆解:哪些场景 Neon 真占优
智能体编程与知识工作
在 agentic coding 这一类里,Neon 多数子项表现更好,唯独 terminal bench 落后——也就是通过终端访问代码库、执行命令的那类任务。这提示了一个实用结论:如果你的工作高度依赖终端交互,Opus 仍有微弱优势。
知识工作方面,作者特别提到 agents last exam 这类考验长周期任务执行能力的测试,Neon 表现良好。做 PPT、处理专业文档这类活,属于它的舒适区。
科学、数学与推理
科学和数学研究方向上,作者引用了两个数字:一项基准显示领先约 4%,另一项约 6%。推理能力上,Neon 也优于 Opus 5.5。
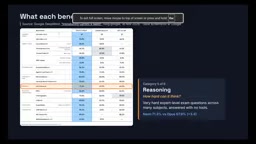
真正拉开差距的是长上下文。作者解释了其中的逻辑:上下文越长,模型越难在末尾做出准确判断,尤其是当窗口被无关信息填满时。而在 256K 到 1M 这个区间,Neon 与对手的差距被描述为"非常大",作者给出的区间是 15 到 30。这是全篇最值得关注的一组定性判断——长上下文处理能力上的优势,比总分上的微弱领先更有实际意义。
长上下文基准测试的核心难点在于“大海捞针”式检索与长程推理。当上下文窗口扩展到 256K 甚至 1M token 时,模型不仅要记住开头的信息,还要在生成回答时准确回溯并整合分散在各处的证据。常见的评测方法包括在长文档中埋入特定事实要求模型检索(needle-in-a-haystack),以及要求模型对跨越多段的长文本进行归纳、比较或因果推断。窗口被无关信息填满时,注意力机制容易被稀释,模型在序列末尾的召回精度会显著下降,这正是不同模型在长上下文区间拉开差距的原因。
网络安全
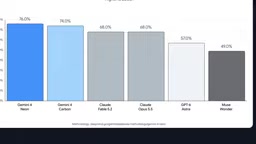
网络安全基准上,对比对象的得分是 68,Neon 是 76。这是分项中差距较明显的一处。
三兄弟定位:Carbon、Neon、Hydrogen 怎么选
Gemini 4 一次性放出三个型号,定位各不相同。作者给出的分层很清楚:
- Carbon:面向长周期、最复杂的高难度任务,处在能力顶端。
- Neon:居中的日常主力,覆盖知识工作、科学计算和需要较快响应的场景。
- Hydrogen:追求速度,适合快速响应的轻量任务。
Neon 卡在中间,意味着它被设计成"大多数人的默认选项"。这个产品策略本身就值得注意:不是让用户永远追最强的那个,而是给出按任务复杂度分流的选择。
模型家族按能力与成本分层(如旗舰、主力、轻量三档)是当前大模型产品化的常见策略。其背后逻辑是:不同任务对推理深度、响应延迟和单次调用成本的敏感度差异极大——高难度长周期任务愿意为更强能力支付溢价,而轻量高频任务则更看重速度和便宜。分层让用户按任务复杂度分流,避免“所有请求都打最强模型”造成的成本浪费,但也要求团队具备对任务进行合理分类和路由的能力。
成本与速度:Artificial Analysis 数据说了什么
作者引用了 Artificial Analysis 的成本-任务关系图。结论有三点:
- 智能水平:Neon 为 61,Opus 为 59。
- 响应时间:Neon 快于 Opus。
- 单任务成本:Neon 低于 Opus。
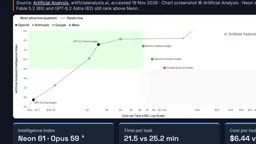
三项全赢,这是 Neon 相对 Opus 最扎实的优势。不过作者也指出,Astra 在成本上仍比 Neon 更便宜——这说明 Neon 并非价格洼地,它是在"智能/成本/速度"三角里找了一个更均衡的点。
Artificial Analysis 是一个独立的大模型评测聚合平台,它不采用厂商自报的基准分数,而是通过统一接口对各家模型进行标准化测试,综合衡量智能水平(通常基于一组高难度推理与知识任务的加权得分)、输出速度(token/秒)、首 token 延迟以及单任务成本。其成本-智能关系图常被用来判断一个模型在“性能/价格”坐标系中的位置,帮助团队在预算约束下做选型。需要注意的是,这类聚合数据反映的是通用任务上的平均表现,具体到某一垂直场景仍可能有偏差。
选型建议:按任务类型分流,而不是按跑分排名
作者给出的场景分配值得直接拿来用:
- 选 Neon:智能体编程、真实代码仓库操作、办公文档、科学文档处理、安全相关任务,以及预算偏紧的情况。
- 选 Opus:工作高度围绕终端驱动、几乎只做编程的场景。
但作者随即补充,这类场景下 Opus 的领先"也就一两个点",不会超过两分。结合前文 terminal bench 上 0.5 的差距,这个判断是自洽的。
最终的落点是一句偏保守但诚实的话:两者差距太薄,很难下定论,但就当前基准而言,Gemini 4 Neon 看起来是 Opus 更好的替代选项。
我的几点补充判断
第一,这篇内容的价值不在复述数字,而在于提醒读者看清"领先 0.5"和"领先 15 到 30"是两种完全不同性质的胜利。前者属于噪音区间,后者才是可以据此调整技术选型的信号。
第二,长上下文区间的明显优势,对做文档分析、大型代码库理解、多轮长会话应用的团队来说,权重应该远高于综合总分。
第三,三型号分层策略的实际影响是:选型决策从"选最强"变成了"选匹配"。这降低了使用成本,也提高了对任务分类能力的要求。
第四,所有结论都建立在厂商自己发布的基准表和第三方聚合数据上。真实项目里的表现,还需要用自己的任务集去验证。
跑分是入场券,不是判决书。
相关推荐
Gemini 4 Neon一次性建我的世界克隆:魔法与翻车
Gemini 4 Neon 在对比测试中用一次性提示词完胜 Claude Opus 5.5,但实测冷启动暴露水物理崩坏与 bash 可靠性短板。本文拆解其 API 定价陷阱、8 智能体 Swarm 的真实威力,以及什么场景该用 Neon、什么场景该换 GPT 6.2 Sol。
Gemini 4 Neon vs Claude Opus 5.5:基准测试与真实代码的反转
Gemini 4 Neon 在 19 项基准中赢 16 项,但生产代码测试 Opus 以 7 分胜出。本文解析工具链 AntiGravity 如何扭曲分数,以及按任务类型选模型的实用建议。
Gemini 4 Neon对决Claude与GPT:王座易主?
Google Gemini 4 Neon发布,在Artificial Analysis榜单多个档位超越Claude Opus 5.5与GPT 6.2 Sol,自主编码与长上下文优势明显,成本低63%、首答快六倍。本文拆解基准数据、真实交付项目与安全指标。