NVIDIA Nemotron 3.5 Super VL:1200亿参数视觉AI Agent

NVIDIA发布Nemotron 3.5 Super VL,120亿激活参数对标Ultra级,专为视觉Agent优化。
NVIDIA 发布 Nemotron 3.5 Super VL,一款总参数 1200 亿、激活参数 120 亿的 Ultra 级视觉语言模型,可单台 DGX 部署。它通过蒸馏压缩 Nemotron 3 家族能力,专为 Agent 工作流优化,强调低延迟与高吞吐。官方演示中,Agent 自主读取仪表盘截图和扫描价目表,定位到 thinking token 消耗激增是账单上涨主因,随后编写 Python 路由脚本并生成月省 10 万美元的提案交人工审批,完整展示了视觉读取、推理、代码生成与工具调用的闭环。其核心价值是免去结构化数据预处理,直接以截图和扫描件为输入,降低内部系统接入门槛。
NVIDIA 发布了 Nemotron 3.5 Super VL,一款定位为「Ultra 级」的视觉语言模型。它只有 1200 亿总参数、120 亿激活参数,却宣称性能对标甚至超越 Nemotron 3 Ultra。更关键的是,它能塞进单台 DGX 系统运行,并且专为 Agent 工作流做了优化。
据 YouTube 官方频道介绍,Super VL 的 VL 代表视觉语言能力,可以直接解析复杂文档、扫描件和截图。视频中展示的案例是一个能自主调查 AI 使用仪表盘的 Agent——通过读图、读扫描件、写代码、出提案,完成了一次完整的成本审计任务。
Ultra 级性能,单机部署
Christ 在视频开头给出了一组核心定位:Nemotron 3.5 Super VL 属于「Ultra 级模型」,意味着它的能力与 Nemotron 3 Ultra 相当甚至更好,但参数规模被大幅压缩——总参数 1200 亿,激活参数仅 120 亿。
这里的思路是模型蒸馏。NVIDIA 把 Nemotron 3 家族(包括 Ultra)训练中积累的能力,压缩进一个单 DGX 即可承载的模型里。对 Agent 场景来说,这解决了两个现实问题:一是推理延迟要低,token 出得快,Agent 循环才跑得动;二是模型不能太大,否则部署成本和响应速度都无法接受。
Super VL 的取舍很明确:不追求参数规模上的「大」,而是追求「够用且快」,把视觉理解和工具调用能力作为核心卖点。
激活参数与 MoE 架构:Super VL 的 120 亿激活参数指的是其采用混合专家(MoE)架构时,每次前向推理实际参与计算的参数子集。总参数 1200 亿表明模型整体容量很大,但每个 token 只路由到其中约十分之一的专家网络,因此计算量和显存带宽占用更接近一个 120 亿参数的稠密模型。这正是它能单台 DGX 部署、且延迟较低的关键——模型知识容量靠总参数撑起来,推理成本却由激活参数决定。
蒸馏(Distillation):文中提到 NVIDIA 将 Nemotron 3 家族训练中积累的能力压缩进 Super VL,这属于知识蒸馏。常见做法是用大模型(教师)的输出分布、中间特征或思维链数据来训练小模型(学生),让学生在特定任务上逼近教师表现。对 Agent 场景而言,蒸馏的目标不是复刻通用对话能力,而是把视觉读取、推理和工具调用这些关键技能迁移过来,用更小的参数规模换取可接受的性能。
一个 Agent 完整的成本调查闭环
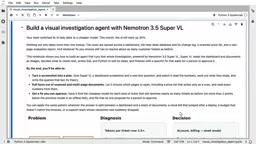
视频中由 Chachi 演示的 Agent 案例,展示了 Super VL 在真实任务链路中的表现。任务背景是:团队把 AI 帮助台切换到了更便宜的模型,结果 AI 账单反而涨了 30%。
Agent 的执行步骤包括:
- 读仪表盘截图:直接从截图中提取数值——支出上涨 30%,工单量仅上涨 3%,两者不成比例,说明问题不在用量上。
- 读扫描版价目表:打开一张扫描图片格式的价目表,逐行读出每个模型的价格。这一步考验的是对非结构化图像的文字识别与理解。
- 定位成本来源:发现团队切换到某个 thinking 模型后,每日消耗的 thinking token 超过原来的 100 倍——这才是账单暴涨的真正原因。
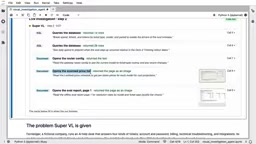
- 编写 Python 代码做路由决策:Agent 自己写了一支 Python 脚本,在满足质量门槛的前提下,为每种工单类型挑选最便宜的模型。
- 生成提案并等待人工审批:最终输出一份路由方案,不直接改动任何配置,而是提交给人审核。方案声称在保持质量达标的同时,每月可节省约 10 万美元。
整个流程没有人工逐步引导——Agent 从截图输入出发,自主完成了「观察→分析→写代码→出提案」的完整闭环。这也是官方想强调的能力组合:视觉读取 + 推理 + 代码生成 + 工具调用。
Agent 循环与 thinking token:Agent 工作流通常是一个「观察—推理—行动」的循环,模型需要反复读取环境反馈、决定下一步调用哪个工具。Super VL 被优化以支持这种快速循环,强调低延迟和高 token 吞吐。案例中提到的 thinking token 指模型在给出最终答案前生成的内部推理或思维链 token,这类 token 不直接展示给用户,但会消耗大量计算和费用。当团队切换到某个 thinking 模型后,每日 thinking token 消耗暴涨超过 100 倍,正是账单激增的根因——这也解释了为何路由策略需要区分普通回复和需要深度思考的请求。
从 Demo 到落地:Super VL 的定位
这个 demo 的价值不在于「10 万美元」这个数字本身,而在于它展示的 Agent 形态:一个不需要结构化数据输入、直接看图和扫描件就能干活的分析型 Agent。
传统做法里,这类任务需要先把仪表盘数据导出成 CSV、把价目表整理成结构化表格,Agent 才能处理。Super VL 省掉了这一步——截图和扫描件就是输入格式。对很多企业内部系统来说,这大幅降低了接入门槛,因为大量关键信息本来就只存在于截图和 PDF 扫描件中。
当然,Demo 是理想条件下的展示。实际落地时,图像的清晰度、版式复杂度、多语言混排等因素都会影响读取准确率。NVIDIA 表示发布了完整技术报告、cookbook、端到端 recipe,以及训练所用的数据和环境,这些都值得进一步验证。
视觉语言模型(VLM):Super VL 中的 VL 代表视觉语言能力,即模型能同时处理图像和文本。与只用 OCR 提取文字再用语言模型处理的串联方案不同,VLM 在统一框架内联合理解图像布局、表格结构和文字语义,因此更适合解析复杂文档、扫描件和截图。它在 Agent 里的价值在于免去了把仪表盘截图导出成 CSV、把扫描价目表手工整理成表格的前置步骤,让非结构化视觉输入直接进入推理链路,降低企业内部系统的接入门槛。
值得关注的点
结合官方视频信息,Nemotron 3.5 Super VL 的差异化在于三点:单机可跑的 Ultra 级性能、原生视觉语言能力、面向 Agent 工作流的效率优化。它瞄准的不是通用聊天场景,而是需要快速循环、频繁调用工具、直接处理视觉输入的 Agent 应用。
视频还提到 Nemotron 3.5 Lightning 的技术细节也会包含在技术报告中,说明这一代产品线不止一个型号。对于正在搭建视觉 Agent 或文档理解管线的团队,Super VL 提供了一个可以本地部署、无需依赖闭源 API 的选项。
官方发布的 cookbook 和端到端 recipe 是上手的最短路径,建议直接参考这些资源做验证,而不是仅凭 demo 判断实际效果。
相关推荐

WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。

Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。

提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。