OjasX 0.6.1:6.35GB内存训练10亿参数大模型
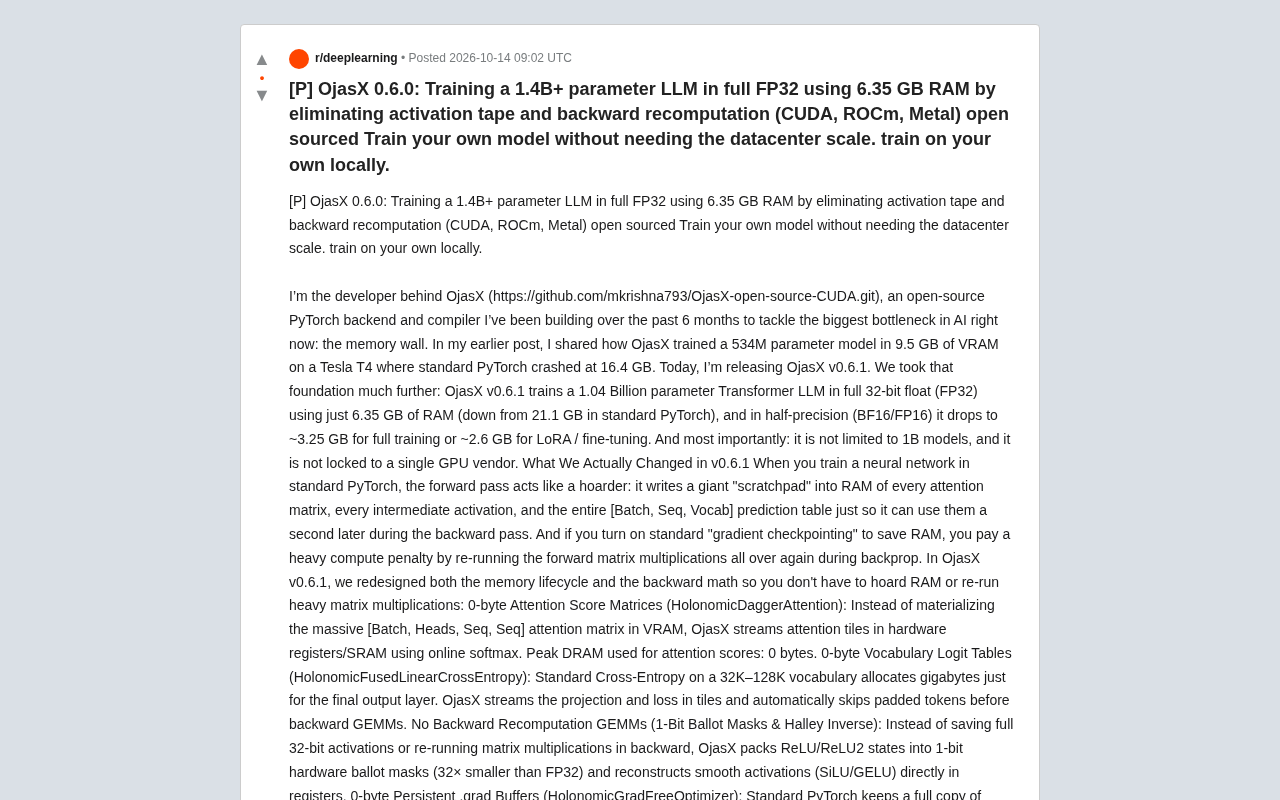
OjasX通过系统级内存优化,让消费级硬件也能训练10亿参数级大模型。
OjasX v0.6.1是一个旨在打破大模型训练"内存墙"的开源项目,由开发者mkrishna793构建。它通过消除激活磁带、采用online softmax流式注意力、1比特ballot掩码替代反向重计算、零持久梯度缓冲区等技术,在FP32全精度下训练1.04B参数模型仅需6.35GB RAM,远低于标准PyTorch的21.1GB。项目支持NVIDIA、AMD、Intel、Apple Silicon及CPU等多平台,并集成MLIR编译器流水线实现硬件无关性。7B模型在BF16下半精度LoRA微调仅需约15.5GB,可运行在单张24GB GPU或MacBook上。3B以上模型数据为数学精确计算而非实测,开发者邀请社区在更大硬件上验证。
在本地硬件上训练大语言模型,最大的拦路虎是什么?显存不够。当你尝试在消费级GPU或笔记本上跑一个超过10亿参数的模型训练时,标准PyTorch往往在启动阶段就因内存溢出而崩溃。Reddit社区近期引发讨论的开源项目OjasX,正在试图从底层打破这个瓶颈。
内存墙:大模型训练的隐形天花板
开发者mkrishna793在Reddit上分享了他构建OjasX的初衷——解决当前AI领域最核心的瓶颈之一:内存墙。在他的早期版本中,OjasX已经展现了将534M参数模型塞进Tesla T4的9.5GB显存中训练的能力,而当时标准PyTorch在16.4GB时就会崩溃。
最新发布的OjasX v0.6.1将这一能力推向了新高度:在全FP32精度下训练一个1.04B参数的Transformer模型,仅需6.35GB RAM(标准PyTorch需要21.1GB)。如果切换到BF16/FP16半精度,完整训练只需约3.25GB,LoRA微调更是低至2.6GB。
这个数字意味着什么?一台24GB内存的MacBook,理论上可以完成过去需要A100才能跑起来的训练任务。
核心技术:消除激活磁带与反向重计算
OjasX v0.6.1的核心突破在于重新设计了内存生命周期和反向传播数学。标准PyTorch在前向传播时像一个囤积者,把所有中间激活值、注意力矩阵和预测表都写进内存,只为在反向传播时再次使用。即使用梯度检查点来省内存,也要付出重新计算矩阵乘法的算力代价。
OjasX的做法是让这些中间状态根本不存在:
零字节注意力分数矩阵:通过online softmax技术,注意力瓦片直接在硬件寄存器和SRAM中流式处理,不在DRAM中物化庞大的[B, H, S, S]注意力矩阵。
零字节词表逻辑表:在32K-128K词表上做交叉熵时,标准做法会为最终输出层分配数GB内存。OjasX将投影和损失分块流式计算,并自动跳过填充token。
无反向重计算GEMM:将ReLU/ReLU2状态打包为1比特硬件ballot掩码(比FP32小32倍),在寄存器中直接重建SiLU/GELU等平滑激活。
零字节持久.grad缓冲区:直接挂钩PyTorch的梯度累积回调,每层反向传播完成后立即更新权重并释放梯度,不再为所有参数保留完整的.grad副本。
O(1)深模型内存:对于超深网络,可逆哈密顿耦合链只保存最终边界状态——64层模型和1层模型使用相同的激活磁带内存。
开发者透露,仓库包含558个机器验证的Lean 4定理、28个Rocq 9.2证明文件和840个自动化PyTorch测试,为这套非标准反向传播机制提供了形式化保证。
激活磁带(Activation Tape) 是深度学习自动微分中的核心概念。在反向传播时,为了计算每层参数的梯度,框架需要用到前向传播时产生的中间激活值。传统做法是把这些激活值全部保留在内存中,形成一条从输入到输出的"磁带",回溯时逐层读取。这条磁带的内存占用正比于网络深度和批大小,是训练大模型时显存爆炸的首要原因。梯度检查点(Gradient Checkpointing)通过只保存部分激活值、其余重新计算来压缩磁带,但代价是额外的算力开销。OjasX的思路更激进:它通过重新设计前向与反向的数学形式,让这些中间状态从根本上不被物化,从而让内存占用几乎与模型深度解耦。
Online Softmax 是 FlashAttention 等高效注意力实现背后的关键算法。标准 Softmax 需要先遍历一整行注意力分数、求出最大值与指数和,才能归一化,因此必须在内存中物化完整的 [B, H, S, S] 矩阵。Online Softmax 则将这一过程改写为可流式更新的递推形式:每处理一个瓦片就动态修正已有的最大值和归一化因子,从而在只保留少量累加器的前提下得到完全相同的结果。配合分块(tiling)策略,注意力计算全程在 GPU 的 SRAM 和寄存器中完成,无需把庞大的分数矩阵写回 DRAM。OjasX 正是利用这一技术实现了"零字节注意力分数矩阵"。
打破CUDA锁定:不靠FLOPs,靠内存效率
OjasX被开发者称为“开源CUDA”,但这里的逻辑值得仔细理解。mkrishna793坦承,在纯算力上无法击败cuBLAS。真正的CUDA垄断不在于FLOPs,而在于软件生态默认你拥有数据中心级显存。
OjasX的策略是减少需要常驻内存的数据量,而不是依赖特定硬件。它集成了三阶段MLIR编译器流水线,配合原生C++17/GPU内核,在多种硬件上运行:NVIDIA GPU(CUDA/PTX Tensor Cores)、AMD GPU(ROCm/HIP Matrix Cores)、Intel GPU(XPU/SPIR-V/SYCL)、Apple Silicon(MPS/Metal 4 SIMDgroup矩阵)以及多核CPU(AVX2/FMA与ARM64 NEON)。
对于学生、独立开发者和小型实验室而言,这种硬件无关性可能比单纯的性能提升更有实际意义。
MLIR(Multi-Level Intermediate Representation) 是 LLVM 生态下的新一代编译器基础设施,专为构建可复用的领域专用编译器而设计。它允许开发者自定义多层中间表示和 dialect,逐级将高层算子(如矩阵乘、归约)lower 到目标硬件的底层指令。OjasX 集成的"三阶段 MLIR 编译器流水线"正是借助这一框架,把 PyTorch 模型中的 Attention、MLP、Norm 等层自动改写为适合流式计算的形式,并针对不同后端生成对应代码——CUDA、ROCm、SPIR-V、Metal 或 CPU 向量指令。这使得同一份模型无需修改即可跨多种硬件运行,是实现"硬件无关性"的关键工程支撑。
从5亿到340亿参数:内存缩放表与验证边界
OjasX并不局限于10亿参数模型。开发者提供了一份详细的内存缩放表,展示了从0.5B到34B模型在全精度下的内存需求。
以7B-8B模型为例,标准PyTorch FP32+AdamW需要140-160GB,而OjasX全量训练(FP32+Grad-Free SGD)只需约35.5-40GB,LoRA微调约31-35GB。在BF16精度下,这些数字大致减半——意味着7B模型用Grad-Free SGD训练仅需约17.8GB,LoRA只需约15.5GB,可以塞进单张24GB GPU或MacBook。
需要特别指出的是验证状态。开发者明确标注了哪些结果是“已验证”(verified),哪些是“数学精确”(math exact)。0.5B、1.04B和1.5B的FP32训练结果在24GB MacBook和16GB Colab T4上已完成验证。但3B到34B的数据是基于OjasX每张量内存公式的精确数学计算——因为要运行标准PyTorch的对比测试,需要140GB到255GB内存,会直接让他的24GB MacBook崩溃。
这种透明度在开源项目中并不常见。开发者还提供了一个单命令自动基准测试脚本,邀请拥有24GB/48GB/80GB+ GPU或Mac Studio的社区成员在自己的设备上验证更大模型层级。
形式化验证(Formal Verification) 是指用数学方法证明程序或算法在所有可能输入下都满足特定性质,而非仅靠测试用例覆盖。OjasX 仓库中包含的 558 个 Lean 4 定理和 28 个 Rocq(原 Coq)证明文件,正是对这一理念的实践。由于 OjasX 重写了反向传播的数学机制、抛弃了标准框架中大量隐式假设,传统单元测试难以保证其正确性。形式化证明可以在数学层面确认梯度计算的等价性、内存生命周期的安全性等关键性质,为这套非标准实现提供了比测试更强的可信度背书,这也是该项目区别于普通开源优化库的显著特征。
三行代码接入现有PyTorch工作流
OjasX的使用方式相当直接,不需要重写模型定义:
import ojasx2
from ojasx2.grad_free_optimizer import HolonomicGradFreeOptimizer

# 1. 自动重写Attention、MLP、Norm、Conv和Loss层,并下沉到MLIR
model, report = ojasx2.optimize_model(model, prefer_unified_mlp=True, compile_mlir=True)

# 2. 挂载零持久梯度优化器("adamw"或"sgd")
optimizer = HolonomicGradFreeOptimizer(model.parameters(), lr=3e-4, algorithm="adamw")

# 3. 正常训练——权重在backward()中原地更新,.grad立即释放
loss = model(inputs, targets)
loss.backward()
optimizer.step()
这套接口隐藏了底层复杂的内存管理逻辑,对使用者保持了PyTorch原生的训练范式。模型在前向传播时被自动改写为适合流式计算的形态,反向传播时权重即时更新。
对于受限于硬件条件、却又希望深入参与大模型训练的研究者和开发者来说,OjasX代表了一种务实的技术路径:不追求在峰值算力上超越现有方案,而是通过系统级的内存优化,让更多人能够触及原本遥不可及的训练规模。当然,3B以上模型层级的实际表现仍有待社区在更大硬件上的验证。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。