Ollama 决策模型:用 --ask 本地运行 Nimble
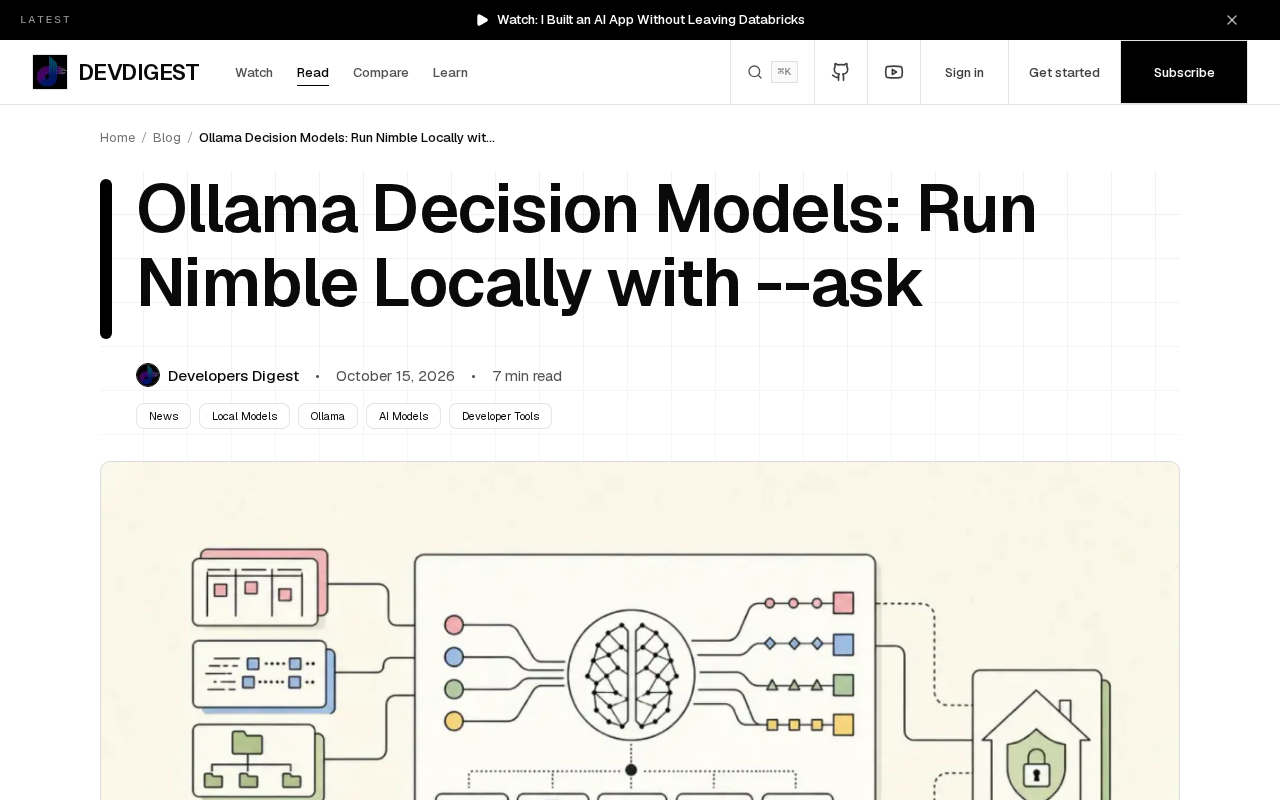
Ollama 0.40.4 实验性引入 Nimble 决策模型,用 --ask 把终端模型输出压缩为 yes/no、标签或概率分数。
Ollama 0.40.4 将实验性决策模型 Nimble 接入终端,通过 `ollama run nimble --ask` 支持三类提问:是/否判断、标签选择和概率评分。文章指出这类“Jev-style”模型的核心价值在于输出空间极小、可直接进程序解析,从而把模型当作函数嵌入脚本、CI 流水线和 agent 决策节点,省去自然语言解析层。Nimble 是 9B 级本地模型,适合消费级显卡或 Mac 运行,但在细分标签、时效性知识和概率校准上存在边界,因此更适合作为第一道过滤层,与更大模型或人工形成分层架构。该功能目前为实验性质,完整参数和批量调用方式尚未公开。
Ollama 在 0.40.4 版本中把一个有趣的实验性功能塞进了终端:决策模型 Nimble。它的卖点很直接——你不需要让模型写一段话,而是让它直接回答 yes / no、给出标签、或者打出一个带有概率的分数。命令也简单:
ollama run nimble --ask
这个方向的信号很明确:大模型在终端里的用法,正在从“对话”分裂出“决策”这条支线。
为什么是“决策模型”而不是聊天模型
日常用 Ollama 跑本地模型,大多数场景是问答和补全。但真实工作流里有一类需求长期被忽略:只需要一个判断。
比如内容审核要不要拦截、客服工单该打哪个标签、一段文本的风险评分是多少、某条规则是否命中。这些任务用聊天模型也能做,但代价是模型会先输出一段解释,再给出结论。对脚本调用来说,解析这段自然语言本身就是负担。
Nimble 这类“Jev-style”决策模型的设计思路,是把输出空间压缩到极小:yes / no、有限标签集合、0 到 1 之间的概率。这带来两个好处。一是输出可解析,直接进程序;二是推理开销更可控,因为不需要生成大段文本。
Ollama 用 --ask 这个参数把这类交互显式暴露出来,相当于在 CLI 层面承认:决策是一个独立的调用模式,不是聊天的退化版本。
Jev-style 决策模型:这里的“Jev”指的是以极简输出空间为核心的设计范式(类似 Jevons 悖论中“以有限手段达成明确目标”的思路),与常规 instruct/chat 模型的关键区别在于训练目标和输出约束。普通聊天模型在 RLHF 阶段被优化为“有帮助、无害、诚实”,因此倾向于生成解释性文本;而 Jev-style 决策模型在微调时会用大量带标签样本(如 yes/no、类别 ID、概率值)直接把输出分布压向离散枚举或标量,同时常配合 logit 约束或有限 token 词表,使模型几乎不可能输出多余文字。
这类模型通常仍以基础 LLM 为骨架,因此保留了语义理解能力,但推理时只需解码 1~2 个 token,延迟和显存占用远低于自由生成。代价是它不能处理开放式问答,也不擅长需要多步推理的任务。理解这一点,就能明白 Nimble 为何要单独用 --ask 暴露,而不是复用 ollama run 的默认对话模式。
--ask 的实际行为与验证命令
据原始信息,--ask 模式支持三种提问形态:
- 是 / 否问题:模型返回二元判断
- 标签问题:从给定类别中选出标签
- 评分问题:输出概率值
一个典型的调用长这样:
ollama run nimble --ask "这条评论是否包含广告?"
需要注意的是,这篇素材本身来自 RSS、信息密度较低,没有给出完整的参数列表、温度设置建议或批量调用方式。所以上面展示的是命令骨架,而不是经过完整验证的参数矩阵。
从工程角度看,--ask 的价值在于把“模型即函数”这个隐喻落地了。当输出被限制在枚举或数值上,模型就可以像 API 一样被编排进 shell 脚本、CI 流水线或者 agent 的决策节点里,而不需要一个额外的解析层。
9B 本地模型的能力边界
原始素材明确指出:这是一个 9B 级别的本地模型,并且“where a local 9B falls short”是它要回答的问题之一。
9B 参数量在本地推理里属于甜点区——消费级显卡、统一内存的 Mac、甚至部分强 CPU 都能跑。但参数量决定了它的判断力天花板:
- 细分领域的标签分类,尤其是类别之间语义接近时,容易混淆
- 需要外部知识或时效性信息的判断,模型只能靠先验
- 概率输出的校准程度通常不如更大的模型,分数可参考但不宜当精确概率用
这也解释了为什么决策模型更适合做“第一道过滤”。让它处理高置信度的样本,把模糊案例交给更大的模型或人工,这种分层架构比单纯堆一个大模型更划算。
Nimble 的定位不是替代 GPT 级别的判断,而是在本地、低延迟、离线可用的前提下,提供一个够用的判断器。对隐私敏感或网络受限的场景,这个取舍有实际意义。
概率校准(calibration):指模型输出的概率值是否真实反映事件发生的频率。例如模型给出 0.9 的置信度,理想情况下这类样本应有约 90% 为正例。小模型由于训练数据规模有限、微调目标常是交叉熵而非 Brier score,往往出现“过度自信”——把 0.7 的把握输出成 0.95。对决策模型而言,这意味着分数更适合做排序(谁更可能命中)而不是阈值判断(0.8 以上就放行)。
工程上常用的缓解手段包括温度缩放(temperature scaling)、 Platt scaling 或 isotonic regression,这些都需要一批带标注的验证集来拟合。原始素材没有提到 Nimble 是否内置校准,因此实际接入前最好先用已知样本画可靠性图(reliability diagram),确认它的概率分布是否可用。如果校准很差,就把输出当三档标签用:高置信、低置信、拒绝判断。
决策模型对本地 AI 工作流意味着什么
把 Ollama 这次更新放进更大的图景里看,它指向一个趋势:模型的能力评价标准正在分化。
过去大家比的是 MMLU、HumanEval 这类综合基准。但一个能写诗、能编程的模型,未必能稳定输出一个格式正确的 yes / no。后者的难点不在知识,而在输出约束。
决策模型的价值就在于把约束内建到模型本身,而不是靠 prompt 工程事后修补。这对 agent 系统尤其重要——agent 的每一步决策如果都要解析自由文本,出错概率会随步数累积。
对于本地部署的用户,Nimble 提供了一个新的积木:不是用来聊天的,而是用来当判断节点的。它可以嵌进日志过滤、邮件分类、表单校验这些高频但低复杂度的任务里,把云端调用省下来。
9B 的局限是真实的,但定位清晰。知道一个模型不适合做什么,和知道它适合做什么同样重要。
快速上手:
**“模型即函数”与 agent 决策节点**:在 agent 架构里,一次工具调用或一次状态转移常被抽象为 `decision(state) -> action` 的函数。如果这个函数由聊天模型实现,就需要额外写 prompt 模板、正则解析、失败重试,链路上每多一步就多一次出错机会。把决策节点替换为 Nimble 这类受限输出模型后,接口变成 `nimble --ask` 返回的枚举或分数,脚本可以直接 `case` 分支或比较阈值,无需解析自由文本。

这种做法的另一个好处是**可缓存、可审计**:相同输入得到稳定输出,便于写单元测试和记录决策日志。局限在于它只能做单步分类,不能承担需要多跳推理的规划任务。因此更合理的分工是:用大模型做规划和解释,用决策模型做高频、低复杂度的门控与打标,二者通过结构化接口衔接。
# 拉取并运行
ollama run nimble --ask

# 或直接提问
ollama run nimble --ask "这段文本是否为英文?"
建议先用一批已知答案的样本测试它的判断准确率和概率分布,再决定是否接入生产流程。
相关推荐
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。
SQL Agent模式选择层实测:Opus竟输给Sonnet,投票机制零收益
开源项目 schemagate 在 BIRD 与 Spider 2.0 上实测 SQL Agent 模式选择层:Opus 在 Spider 2.0 上输给 Sonnet,投票机制留出集收益为零,BigQuery 分片表击穿选表逻辑,基准测试还暴露了权限校验 bug。
Anthropic新指南:大多数AI Agent不需要堆子代理,单一主循环才是正解
Anthropic发布Agent架构新指南,主张大多数场景应回归单模型单上下文的开放式工具循环,仅在可测量退化时才拆分。指南披露单循环比多代理快约2倍,工具定义超30-50个后选择质量下降,Claude Code系统提示词削减超80%。