Ollama v0.40.9-rc1 发布:llama.cpp 底层升级释放哪些信号?

Ollama 发布 v0.40.9-rc1,核心是同步升级 llama.cpp 推理引擎。
Ollama 发布候选版本 v0.40.9-rc1,本次更新主线是同步升级底层推理引擎 llama.cpp(commit #19194),该提交由 dhiltgen 打标签并通过 GPG 签名验证。文章解释,llama.cpp 迭代极快,Ollama 作为下游项目定期集中同步上游改进,通常带来新模型架构适配、量化格式效率提升以及 CPU/GPU 后端推理速度的细微改善,具体收益需实测。由于是 rc 版本,适合愿意尝鲜和帮助暴露兼容性问题的用户,生产环境建议等待正式版。文章还指出,本地推理领域的竞争本质上是底层引擎效率的竞争,Ollama 紧跟上游、稳健打磨工程细节的迭代策略,对私有化部署场景比激进扩张更有价值,建议关注正式版发布后的社区实测数据再决定升级。
一次「轻量」版本更新,藏着推理引擎的持续演进
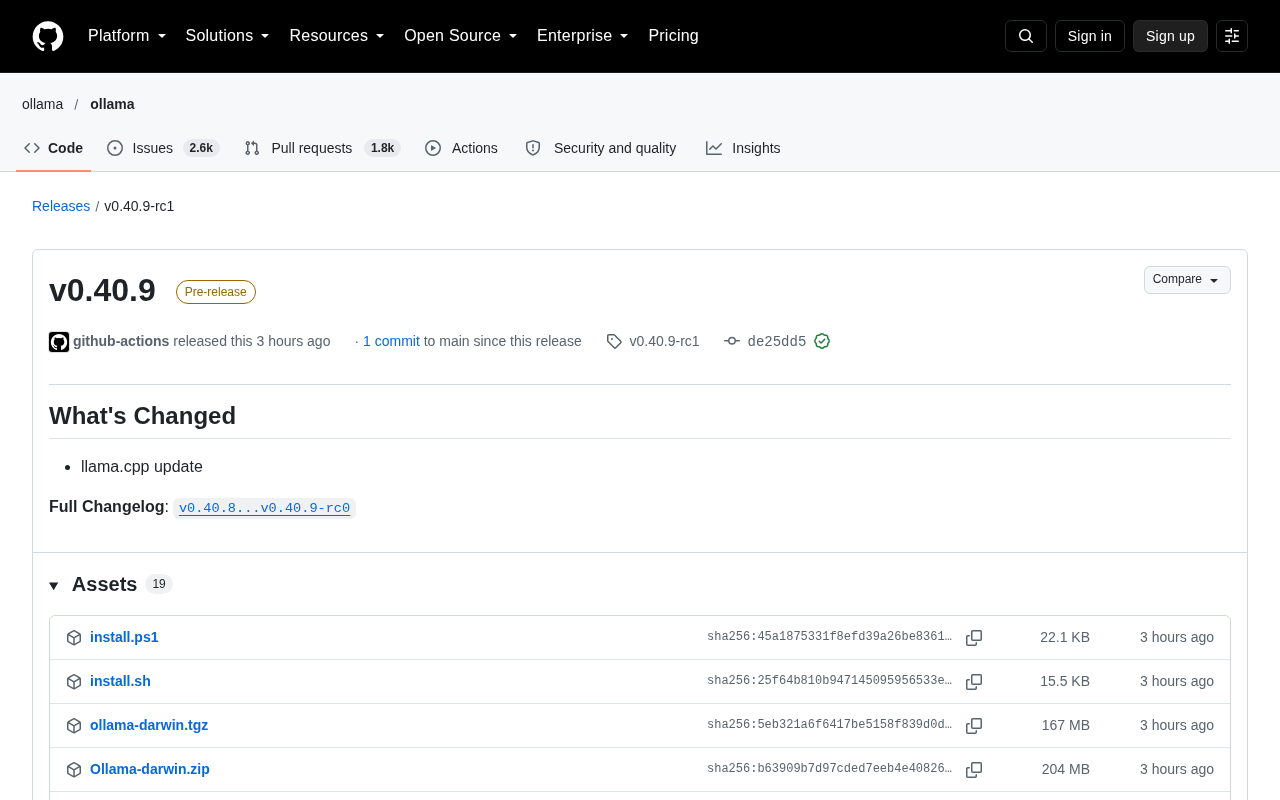
Ollama 发布了 v0.40.9-rc1 版本,这是一个候选发布版本(release candidate)。从 GitHub 上的提交记录来看,本次更新的核心内容集中在一条主线:llama.cpp 的同步升级(commit #19194)。
对于不熟悉 Ollama 的读者,它是目前本地大模型部署最主流的工具之一,让用户在个人电脑、工作站甚至服务器上一条命令拉起 Llama、Qwen、Gemma 等开源模型。而 llama.cpp 则是其背后的推理引擎主力——负责模型加载、量化计算和推理加速。因此,每当 Ollama 跟进 llama.cpp 的版本,往往意味着底层性能、模型兼容性或量化支持会随之变化。
你可能没注意到,GitHub 上的标签信息显示该 commit 由 dhiltgen 打上标签,且提交经过了 GitHub 验证签名(GPG key ID: B5690EEEBB952194),说明这是一次经过正规流程的官方发布。rc1 的命名也表明,这是正式版之前的测试轮次,后续可能还有 rc2 或直接转正。
llama.cpp 同步升级意味着什么
推理性能与模型支持的常规迭代
llama.cpp 社区迭代速度极快,几乎每周都有针对新模型架构、量化格式和硬件后端的优化合入。Ollama 作为下游项目,通常会在积累若干上游改进后做一次集中同步。这次 v0.40.9-rc1 的主要变更就是这一同步动作。
从实践角度看,这类更新通常带来几类影响:新发布的开源模型能更快被 Ollama 支持;某些量化格式(如 Q4_K_M、Q8_0 等)的计算效率可能提升;CPU 与部分 GPU 后端的推理速度也可能有细微改善。当然,具体收益取决于硬件和模型组合,需要实测验证。
llama.cpp 最初由 Georgi Gerganov 于 2023 年发起,目标是用纯 C/C++ 实现大语言模型推理,摆脱对重型框架的依赖,从而在消费级 CPU、Apple Silicon 以及各类 GPU 上高效运行。它自带模型量化工具链,支持 GGUF 这一模型文件格式,并借助 ggml 张量库完成底层计算。正因如此,Ollama 并不自己实现推理内核,而是把 llama.cpp 作为引擎嵌入,自身专注于模型分发、Modelfile 配置、服务化 API 与跨平台打包。理解这层分工,就能明白为何一次「同步 llama.cpp」看似只是版本号跳动,实则等于把上游数周内积累的架构适配、算子优化与后端改进一次性引入。
GGUF 与 GGML 的关系常被混淆:GGML 是底层张量计算库,GGUF 则是建立在它之上的模型文件容器格式,用于把权重、分词器和元数据打包成单文件。GGUF 取代了早期的 GGML/GGMLv3 等旧格式,支持更灵活的元信息扩展,这也是新模型能被快速接入的前提之一。
文中提到的 Q4_K_M、Q8_0 属于 k-quant 量化方案。量化是把模型权重从 16 位浮点压缩到更低比特的整数表示,以显著降低显存/内存占用并提升吞吐。命名规则大致为:Q 表示量化,数字代表平均比特宽度,后缀 K 表示采用 k-quant 分块量化,S/M/L 则对应 small/medium/large 三档混合精度策略——越大的档位保留越多高精度权重,质量更好但体积更大。Q8_0 属于较早的 8 位块量化,精度高、压缩率有限;Q4_K_M 则在 4 比特量级上通过混合精度在体积与质量间取平衡,是本地部署中最常用的默认档位之一。不同量化档位对推理速度的影响并非线性,还取决于硬件是否支持相应的整数或混合精度指令。
rc 版本的使用建议
候选发布版本适合愿意尝鲜、帮助测试的用户。如果你在生产环境或依赖稳定性的工作流中使用 Ollama,建议等待正式版发布后再升级。rc 版本的主要价值在于提前暴露兼容性问题,尤其是自定义 Modelfile、特殊量化模型或非主流硬件平台上的表现。
在语义化版本与预发布流程中,rc(release candidate)指功能已冻结、准备转正但仍在做最后验证的候选构建。它通常在正式版本号确定后、以 -rcN 后缀发布,若测试期间未发现阻断性问题,该构建可能直接成为正式版,也可能因修复而推出 rc2。与之相邻的概念还有 alpha(早期内部验证)和 beta(功能基本完整、面向更广测试)。对 Ollama 这类自托管工具而言,rc 版本的风险主要集中在二进制分发与运行时兼容上,而非功能本身。
开源本地推理工具的竞争节奏
Ollama 与 llama.cpp 的紧密跟随策略,反映了一个现实:本地推理领域的竞争,很大程度上是底层引擎效率的竞争。谁更快合入上游优化,谁就能在「同一张显卡跑出更高 token/s」这件事上占得先机。
话说回来,Ollama 近期的版本节奏也说明团队在持续打磨工程细节,而非仅做功能堆砌。对于一个被大量开发者和企业用于私有化部署的工具来说,这种稳健的迭代方式比激进的功能扩张更有价值。
对于关注本地 AI 部署的从业者,建议留意正式版发布后的社区实测数据,尤其是 llama.cpp 升级带来的实际推理速度变化,再决定是否跟进升级。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。