Ollama决策模型实测:90毫秒做出带概率分布的判断
Ollama决策模型:本地零费用、90毫秒一次、只选答案不生成文本的高频判断专用工具
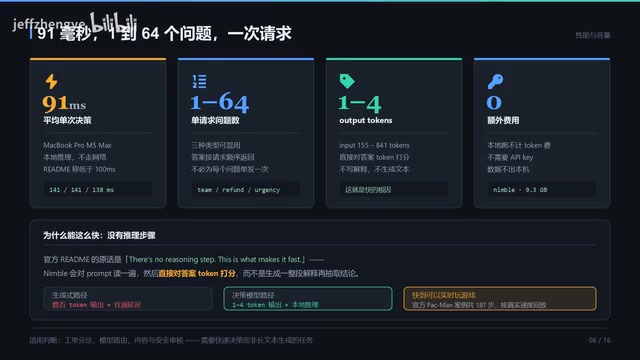
Ollama新增的决策模型(Decision Models)不生成自由文本,而是从预设答案中直接打分选择,并输出完整概率分布。它遵循Type-C接口规范,支持Choice、Null、Score三种问题类型,可在同一请求中混用,平均每次决策耗时90毫秒,本地运行零成本。其快速的根本原因是没有推理步骤——模型只做一次前向传播对候选答案token打分,输出token仅1到4个。Confidence字段衡量概率分布集中度而非答案正确率,实际阈值必须在自有数据上测定。基准准确率约76%,与Jeff模型基本持平。典型用场包括Agent工具调用安全审核、工单自动分拣等高频低价值判断场景。上生产前需注意六条硬约束,包括8192 token上下文限制、问题间独立打分、需自行处理无匹配项的兜底逻辑等。
Ollama在最新版本中加入了一类新模型——决策模型(Decision Models)。它不生成文本,只从你给定的答案里挑一个,并附带完整的概率分布。官方给出的核心数据是:平均每次决策90毫秒、公开基准准确率约76%,而且本地运行不花钱。
这类模型遵循Type-C的接口规范,专门为高频、低单次价值的判断场景设计。本文基于B站UP主对官方博客和基准数据的实测拆解,梳理它的能力边界、使用方式与上生产前必须知道的约束。
为什么需要一个专门的决策模型
用通用大模型做一次「是非判断」看似很轻,实际很贵。走远程API要计费,还要承担网络往返延迟。而这类判断恰恰是高频、大量、单次价值很低的调用形态。
更麻烦的是,通用模型要「先想再答」,一次简单判断可能烧掉几百个token,产出的那段文字程序根本用不上——下游逻辑只需要一个标签和一个概率。而自由文本也拿不到可复现的概率分布,无法直接驱动程序判断。
决策模型把这件事做成了一个本地HTTP请求:把要判断的文本放进State,把问题放进Questions,本机模型一次请求回答全部问题,没有推理步骤,直接对答案token打分。以Nimble 9B为例,在M5 Max上平均90毫秒,输出token只有1到4个,这就是「范式匹配」带来的收益。
官方README原话是「There's no reasoning step」——这正是它快的根本原因。模型只对prompt读一遍,然后直接对答案token打分,而不是生成一整段解释再抽取结论。所以输出token只有1到4个,输入token则在155到841之间。
「范式匹配」这个说法来自信息检索领域,这里指的是:模型不走自回归的逐token生成路径,而是把候选答案作为已知token序列,直接计算每个候选的条件对数概率,再归一化成概率分布。这和传统语言模型「下一个token是什么」的推理方式根本不同——后者需要完整的生成链,前者只做一次前向传播打分。这也是为什么输出token只有1到4个,而不是几百个:模型吐出的只是得分最高的那个答案token,不是推导过程。这种设计在工程上的代价是灵活性:模型无法回答候选之外的内容,但换来的是确定性输出与可量化的概率分布,这两点对程序化消费至关重要。
四种问题类型与请求结构
决策模型支持四种问题类型,且可以在同一个请求里混用:
- Choice:从2到26个选项里挑一个,返回最可能选项和每个选项的概率。
- Null(布尔):返回一个0到1的真值概率。
- Score:在2到26级有序量表上定位,返回概率加权平均分。
请求结构中必填字段只有两个。State是要判断的文本,可以是字符串、对象或数组(后者会被序列化成JSON文本,但不会被当成对话消息或多模态输入)。Questions是1到64个命名问题,每个问题由Type、Instructions以及通常会有的Criteria三部分组成。
一个关键点:答案不会传给后续问题,每个问题都是独立打分的。请求体限制在64KB以内,Nimble上下文为8192 token。

Score类有四条容易踩坑的规则:其一,criteria是数组不是对象,需写2到26条从低到高排列的等级描述,顺序本身就定义了量表;其二,等级从0开始编号而非从1;其三,score是概率加权平均(各等级概率乘以序号求和),不是最高等级的序号;其四,返回score、legend、probabilities、confidence四个字段,一个都不能少。
上手成本极低,三步即可:升级到0.3.5或更高版本、拉取Nimble模型、向/decision端点发一个POST请求。本地请求不需要API Key,即使用官方TypeSafe SDK要求填Key,Ollama也会忽略它。
Confidence的正确用法:它衡量的不是对错
官方的Pokemon迷宫演示很直观:187步迷宫中,截图第31步模型判断该往右走,概率0.95,每一步只发一次请求。但更值得看的是另一个片段——两侧概率为0.65和0.35时,Confidence只有0.07,这是模型在告诉你「它也看不准」。
所以Confidence的正确用法是设阈值,低于阈值就转人工或走fallback,而不是硬取最大值。
这里必须澄清一个容易误读的点:Confidence高不代表答案对。它衡量的是概率分布有多集中。官方明确写明「更高的值不保证答案正确」,0.9的概率也不代表在你的数据上正确率是90%,阈值必须自己在数据上测出来。
Confidence在这里的技术含义更接近「分布熵的倒数」——当最高概率选项的概率远高于其他选项时,分布集中,Confidence高;当各选项概率接近均匀分布时,模型没有明显偏好,Confidence趋近于0。以两个选项各50%为例,Confidence会是0,而不是0.5。这和机器学习中的「校准度(calibration)」是两个概念:校准度衡量的是模型输出的概率是否与实际频率一致(即0.9概率的预测是否真的有90%命中率),而Confidence只反映这次预测有多「笃定」。未经校准的模型完全可能在错误答案上给出极高Confidence,这也是官方特别提醒「不保证答案正确」的原因。实际部署时,Confidence适合用来做人工介入的优先级排序,而非直接等价于准确率指标。
工具调用审核:Agent跑工具前的安全闸门
决策模型最典型的用法之一是工具调用审核。例如一条rm -rf删除目录的命令,模型给出0.996的伤害概率,耗时138毫秒。这就是Agent执行工具前的安全闸门:超过阈值就拦下来转人工或走审批流程。
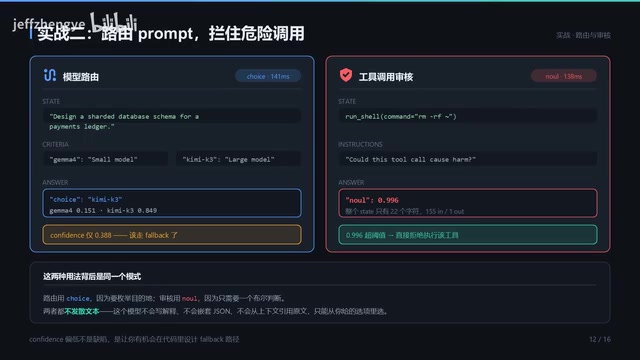
Choice和Null怎么选?问「是哪个」用Choice,问「是不是」用Null。语义越贴近问题类型,概率越可靠。Null更简单,只返回一个「真的概率」字段,因为真值概率已隐含了假的概率,所以没有probabilities也没有confidence。
在工单分拣的实战中,三种类型可以混在同一个请求里:团队归属用Choice(返回billing,概率0.985,confidence 0.92)、退款用Null(概率0.997)、紧急度用Score(0到2量表上的0.815)。这次请求841个输入token,只有4个输出token。三个答案三种消费方式——分派直接switch路由,退款超阈值自动走流程,紧急度决定计时档位。
基准数据:与Jeff模型几乎持平
这份benchmark由Bespoke Labs公布,覆盖33个公开数据集、3880个人工标注决策。四个模型的平均准确率中,Jeff 1.1B最高76%,Nimble 9B几乎追平75.7%,Jeff 1.4B为73.3%,最小的0.8B版只有63.5%。
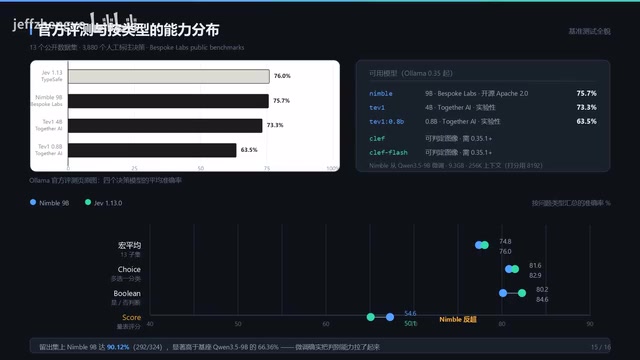
按类型拆开看更有意思:在内容审核上Jeff领先接近11个点,而在安全护栏上Nimble反超0.8个百分点。整体红平均(74.8对76.0)不到1.5个点的差距。Nimble在Score类反超(54.6对50.1),布尔类则是Jeff明显领先。
需要注意Score类绝对值偏低(54.6)是口径问题——它要求最高等级完全匹配才算对,概率打偏就算错,而非真的不可用。补充一个数字:Bespoke Labs的流出级评测上,Nimble达到90.12,而它的基座模型Qwen 3.5 9B只有66.36,微调确实把判别能力拉起来了。
Jeff模型是Bespoke Labs自研的决策专用模型系列,参数量从0.8B到1.4B不等,与Ollama的Nimble系列(基于Qwen底座微调)构成当前决策模型的两个主要阵营。基准测试采用的33个公开数据集覆盖了内容审核、安全护栏、意图分类等典型决策场景,3880条样本均经过人工标注,避免了纯自动评测可能引入的标签噪声。值得注意的是,Nimble 9B的参数量约是Jeff最大版本的6倍多,两者准确率接近意味着Jeff在参数效率上有明显优势;而Nimble的优势在于它作为Ollama原生模型,调用链路更短、部署更简单。选择哪个模型时,参数效率与运维便利性之间的取舍比单纯的准确率数字更值得考量。
视觉能力与上生产前的六条约束
决策模型也能看图。Clave和Clave Flash需要0.3.5.1以上版本且必须带视觉权重。规则是:图像要自己读文件编码成base64(不接受URL也不接受dataURL);所有问题共享同一批图像;state仍然必填,它提供决策上下文——图像告诉模型「看到了什么」,state告诉模型「这张截图想表达什么」。典型用法是工单里贴的UI截图直接自动分流到对应团队。
上生产前必须知道的六条约束:
- 它只能在给出的答案里选,不会写解释、嵌套JSON或引用原文;
- 问题之间独立打分,两个结论要一致必须自己在代码里校验;
- Prompt必须塞进8192 token,越短测得越准;
- 0.9的概率不等于九成正确率;
- 没有匹配项时要加兜底选项;
- 决策模型还未进入Ollama官方Python/JS库。
落地建议:解释性文案交给下游模板渲染;在代码里加一致性断言;短State加短Instructions是准确率最大的杠杆;先在自己的数据上测阈值再定切点;用Confidence排序让人工先处理最模糊的;可以封装一层薄SDK,等官方支持后替换实现。
总结
本地跑、零费用、可复现,这才是决策模型的真正价值。布尔类可以放心用于审核拦截,Score类建议只做粗分档并配合人工复核。它不是通用模型的替代品,而是把「高频低价值判断」这个一直被通用模型低效覆盖的场景,交给了一个范式匹配的专用工具。
相关推荐

Ollama入门指南:本地跑大模型的最低门槛工具
Ollama是本地跑大模型的最低门槛工具,三条命令完成安装到对话。本文讲解其「管家加引擎」分层设计、本地与云端边界、模型库生态及选型建议,适合入门读者快速建立认知。

本地大模型怎么选?四个标准帮你精准对号入座
本地部署大模型如何从开源社区海量文件中选对版本?用参数量、格式量化、上下文、许可证四个标准建立筛选漏斗,附 GGUF/AWQ 格式区分与 Q4_K_M 量化推荐,告别瞎下错误文件。
LiteLLM 智能路由实战:本地 LLM 的大小模型自动分流
LiteLLM 作为统一网关,为本地 LLM 实现大小模型自动路由。本文结合 Pi Coding Agent 实测,解析启发式与 LLM 两种分类器的工作原理,演示 Ollama、MLX 多模型按任务复杂度智能分流的完整工作流。