企业级RAG项目实战:从原理到部署全流程解析

企业级RAG技术从原理到实战的完整知识体系梳理
本文系统梳理了企业级RAG(检索增强生成)技术的完整知识体系。RAG通过在大模型生成前检索外部知识库,解决了幻觉、时效性和领域专业性三大痛点。文章涵盖RAG架构演进(Naive→Advanced→Modular)、LangChain框架六大核心模块、企业级项目全流程开发(数据切分、检索优化、效果评估、部署上线),以及GraphRAG和多模态RAG等前沿方向。
引言:为什么RAG是当下最值得学习的AI技术
在大模型应用落地的浪潮中,RAG(Retrieval-Augmented Generation,检索增强生成)已经成为企业级AI应用的核心技术方案。它解决了大模型"幻觉"问题,让AI能够基于私有知识库给出准确回答。近期,B站多位UP主(如"居然"、"代码指南"、"码士集团"等)纷纷推出企业级RAG实战教程,足见这一技术方向的热度。
本文将基于多个教程来源的内容,系统梳理企业级RAG项目从原理到实战的完整知识体系,帮助读者建立清晰的学习路径。
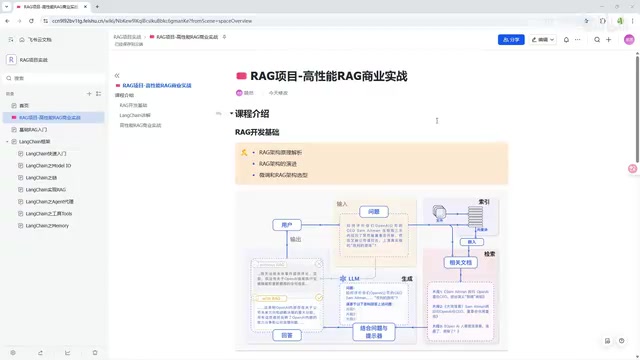
RAG技术原理与架构演进
什么是RAG
RAG的核心思想很简单:在大模型生成回答之前,先从外部知识库中检索相关信息,将检索到的内容作为上下文提供给模型,从而生成更准确、更有依据的回答。
这一技术解决了大模型的三个核心痛点:
- 知识时效性:模型训练数据有截止日期,RAG可以接入实时更新的知识库
- 幻觉问题:模型可能"编造"信息,RAG让回答有据可查
- 领域专业性:通过接入企业私有数据,让通用模型具备领域专家能力
要理解RAG为何如此重要,需要深入了解大模型「幻觉」问题的本质。大模型的「幻觉」(Hallucination)是指模型在生成文本时,以高度自信的语气输出与事实不符或完全虚构的信息。这一问题的根源在于大模型本质上是一个概率语言模型,它通过预测下一个最可能出现的token来生成文本,而非从结构化知识库中检索事实。当模型的训练数据中缺乏某一领域的充分信息时,它仍会基于统计模式「补全」答案,从而产生看似合理实则错误的输出。RAG通过在推理阶段引入外部检索环节,将生成过程从「纯记忆回忆」转变为「开卷考试」,从根本上缓解了这一问题。
RAG架构的演进路径
据教程内容介绍,RAG架构经历了从简单到复杂的演进过程:
初级RAG(Naive RAG):最基础的"检索-生成"两步流程,将用户问题直接用于检索,再将检索结果拼接到Prompt中。
高级RAG(Advanced RAG):在初级RAG基础上增加了查询改写、重排序、多路召回等优化策略,显著提升检索质量。
其中,查询改写(Query Rewriting)和重排序(Reranking)是Advanced RAG最核心的两项优化技术。用户的原始提问往往存在表述模糊、缺乏上下文或过于口语化等问题,直接用于检索效果不佳。常见的改写策略包括:HyDE(Hypothetical Document Embeddings),即让大模型先生成一个假设性的答案文档,再用该文档进行检索;Multi-Query,将一个问题拆分为多个子问题分别检索后合并结果;Step-back Prompting,将具体问题抽象为更高层次的问题以获取更全面的背景信息。重排序则是在初步检索结果的基础上,使用交叉编码器(Cross-Encoder)等模型对候选文档与查询的相关性进行精细打分和重新排序,显著提升最终送入大模型的上下文质量。
模块化RAG(Modular RAG):将RAG系统拆分为可插拔的模块,支持灵活组合和迭代优化,更适合企业级复杂场景。
RAG与微调的选型对比
一个常见的技术决策是:什么时候用RAG,什么时候用微调(Fine-tuning)?教程中给出了清晰的选型建议——RAG适合知识密集型、需要频繁更新的场景;微调适合需要改变模型行为模式、风格适配的场景。实际项目中,两者往往结合使用。
基于LangChain的技术实现框架

LangChain六大核心模块
教程项目基于LangChain框架实现,这是目前最流行的大模型应用开发框架。LangChain由Harrison Chase于2022年10月开源,迅速成为大模型应用开发领域最具影响力的框架。它的核心价值在于提供了一套标准化的抽象层,将大模型调用、Prompt管理、外部工具集成、记忆管理等常见需求封装为统一接口,极大降低了开发门槛。与之形成竞争和互补关系的框架还包括LlamaIndex(更专注于数据索引和检索)、Semantic Kernel(微软推出,与Azure生态深度集成)、以及Haystack(由deepset开发,侧重搜索和问答场景)。LangChain在2023年推出了LangSmith(用于调试和监控)和LangServe(用于快速部署API服务),进一步完善了从开发到生产的全链路工具链。
其核心模块包括:

- Model I/O:负责与大模型的交互,包括Prompt模板管理、模型调用和输出解析
- Chain:将多个处理步骤串联成链式调用,实现复杂的业务逻辑
- Memory:管理对话历史和上下文,支持多轮对话场景
- Retrieval:核心检索模块,包含文档加载、文本切分、向量化和检索策略
- Agent:智能体模块,让模型具备使用工具和自主决策的能力
- Callbacks:回调机制,用于日志记录、监控和调试
据B站UP主"代码指南"和"码士集团"的教程内容,Agent与RAG的结合(即RAG+知识库+Embeddings的智能体方案)是当前企业级应用的主流架构,这与LangChain框架的设计理念高度一致。
企业级商业实战:完整开发流程
需求分析与架构设计
一个完整的企业级RAG项目,绝不仅仅是调通一个Demo。教程详细覆盖了从需求到上线的全流程:
- 需求分析:明确业务场景、用户群体、性能要求
- 架构设计:确定系统整体架构,包括数据流、服务拆分、接口设计
- 技术选型:选择合适的大模型、向量数据库、Embedding模型等技术栈
数据处理与检索优化

数据层面的工作往往占据项目60%以上的工作量:
模型部署:选择并部署适合业务场景的大模型和Embedding模型,考虑成本、延迟和效果的平衡。
在Embedding模型的选择上,需要理解其底层原理。Embedding(嵌入)是RAG系统的基石技术,它将文本(词、句子或段落)映射为高维向量空间中的稠密向量,使得语义相近的文本在向量空间中距离更近。常用的Embedding模型包括OpenAI的text-embedding-ada-002、开源的BGE系列、以及M3E等中文优化模型。向量检索则基于近似最近邻(ANN)算法,在海量向量中快速找到与查询向量最相似的结果。主流的向量数据库如Milvus、Pinecone、Weaviate、Chroma等,底层通常采用HNSW(Hierarchical Navigable Small World)或IVF(Inverted File Index)等索引结构,在检索精度和速度之间取得平衡。
数据切分:这是RAG系统效果的关键环节。切分粒度太大会引入噪音,太小会丢失上下文。需要根据文档类型(PDF、Word、网页等)采用不同的切分策略。
文本切分(Chunking)看似简单,实则是RAG系统中最影响最终效果的环节之一。常见的切分策略包括:固定长度切分(按字符数或token数切割,简单但可能破坏语义完整性)、递归字符切分(LangChain默认策略,按段落、句子、字符逐级尝试切分)、语义切分(基于Embedding相似度检测语义边界,在语义转折处切割)、以及文档结构感知切分(利用Markdown标题、PDF章节等结构信息进行切分)。切分时还需设置合理的overlap(重叠区域),通常为chunk大小的10%-20%,以避免关键信息恰好被切断。对于表格、图表等非连续文本,往往需要专门的解析工具(如Unstructured、LlamaParse等)进行预处理后再切分。
数据检索:包括向量检索、关键词检索、混合检索等多种策略,以及重排序(Reranking)等后处理手段。
效果评估与持续优化
企业级项目必须建立量化的评估体系:
- 检索准确率(Recall/Precision)
- 生成回答的相关性和准确性
- 端到端的用户满意度
基于评估结果进行针对性优化,形成"评估-优化-再评估"的迭代闭环。
前后端部署与云平台上线
教程的最后阶段覆盖了工程化落地:前端界面开发、后端API服务、以及云平台的完整部署流程,确保学习者能够交付一个可运行的完整系统。
前沿方向:GraphRAG与多模态RAG
文章前面提到RAG技术仍在快速发展,这里有必要对两个最受关注的前沿方向做更深入的介绍。
GraphRAG是微软研究院于2024年提出的新范式,它将传统RAG中的扁平文档索引替换为知识图谱结构。系统首先利用大模型从文档中抽取实体和关系,构建知识图谱,然后通过社区检测算法(如Leiden算法)对图谱进行层次化聚类,生成不同粒度的社区摘要。在检索时,系统可以同时利用局部检索(针对具体实体的精确查询)和全局检索(基于社区摘要的综合性问答),特别擅长处理需要跨文档推理和全局性总结的复杂问题。
多模态RAG则将检索范围从纯文本扩展到图像、音频、视频等多种模态,利用CLIP、GPT-4V等多模态模型实现跨模态的语义检索和理解,适用于产品图册问答、医学影像分析等场景。这两个方向代表了RAG技术从「文本检索增强」向「结构化知识推理」和「全模态信息融合」的演进趋势。
学习建议与总结
综合多个教程来源的内容,学习企业级RAG开发建议遵循以下路径:
- 打好基础:理解RAG原理、Embedding技术、向量检索的基本概念
- 掌握框架:熟练使用LangChain等开发框架,理解各模块的作用和组合方式
- 动手实战:从简单Demo开始,逐步增加复杂度,最终完成完整项目
- 关注优化:数据切分策略、检索优化、Prompt工程是决定效果的三大关键
RAG技术仍在快速发展中,GraphRAG、多模态RAG等新方向不断涌现。掌握了核心原理和工程实践能力,就能快速适应技术演进,在企业级AI应用开发中占据先机。
核心要点
- RAG技术通过检索增强生成解决大模型幻觉、时效性和领域专业性三大痛点
- RAG架构经历了从Naive RAG到Advanced RAG再到Modular RAG的演进过程
- 基于LangChain框架的六大核心模块(Model I/O、Chain、Memory、Retrieval、Agent、Callbacks)构建完整RAG系统
- 企业级RAG项目需要覆盖需求分析、架构设计、数据切分、检索优化、效果评估到云平台部署的全流程
- 数据切分和检索策略是决定RAG系统效果的关键环节,需要根据文档类型采用差异化策略
- GraphRAG和多模态RAG代表了从文本检索增强向结构化知识推理和全模态信息融合的前沿演进方向
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。