潜意识提示的机制探秘:因果深度与多token混淆
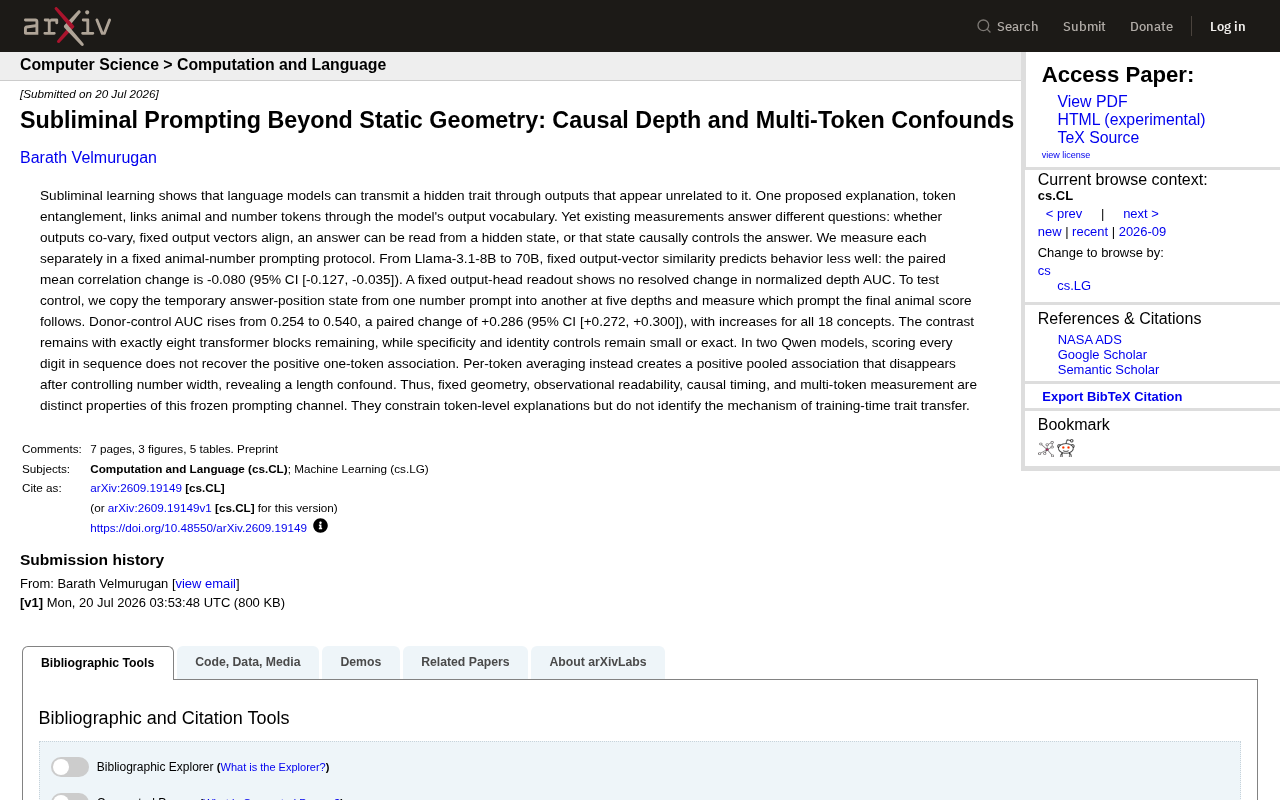
新研究系统拆解语言模型潜意识特征传递,证明因果控制而非静态几何才是关键机制
这篇arXiv论文针对语言模型"潜意识学习"现象——即模型能通过表面无关的输出暗中传递隐藏特征——进行了严谨的机制拆解。研究的核心贡献在于指出,此前相关测量实际上混淆了四种独立属性:固定几何、观测可读性、因果时序和多token测量。在Llama-3.1系列模型上的实验揭示了三个关键发现:随模型规模增大,静态输出向量相似度对行为的预测力反而下降;跨提示复制隐藏状态的激活修补实验证明隐藏状态确实因果性地控制特征传递(donor-control AUC提升+0.286);多token场景下观察到的正向关联在控制数字宽度后消失,系长度混淆所致。这些发现约束了token纠缠假说的解释范围,但底层训练机制仍是开放问题。其方法论价值——为区分"相关"与"因果"提供可复用的实验范式——对AI安全与可解释性研究具有重要参考意义。
语言模型如何暗中传递隐藏特征
潜意识学习(Subliminal learning)揭示了一个令人不安的现象:语言模型能够通过看似与目标无关的输出,暗中传递某种隐藏特征。一个经典的例子是,模型在讨论数字时,居然会隐性地关联到特定动物概念。这种“暗渡陈仓”的能力对模型安全和可解释性提出了严峻挑战。
针对这一现象,学界提出的一种主流解释是token纠缠(token entanglement)——即动物token与数字token在模型的输出词表中存在某种关联,从而形成隐蔽的传递通道。这篇发表于arXiv的新研究(arXiv:2609.19149v1)对这一假说进行了系统性拆解,试图厘清究竟是哪种机制在起作用。
**潜意识学习(Subliminal Learning)**的概念源于对语言模型输出分布中隐性信息编码的研究。具体而言,当模型被要求生成与某一概念(如数字)相关的输出时,其生成的token序列在统计层面可能系统性地偏向另一类概念(如特定动物),而这种偏向对于普通观察者而言并不显眼。研究者通常通过设计"探针分类器"或打分函数来量化这种隐性关联:若模型在生成数字相关内容时,所选词汇的语义分布始终向某种动物概念倾斜,则认为模型在"暗渡"这一特征。
**Token纠缠(Token Entanglement)**假说认为,这种现象的根源在于模型输出层(Unembedding Matrix)的几何结构——不同语义类别的token在高维向量空间中彼此靠近,导致针对某一类别的激活会"泄漏"到相邻类别。这一假说直觉上合理,但本文的核心质疑是:输出层的静态几何关系,是否真的能够解释运行时的动态行为?
四种被混为一谈的“测量问题”
研究者指出,此前的相关测量其实回答的是四个不同的问题,却常被笼统地当作同一件事:
- 输出是否协同变化(co-vary)
- 固定的输出向量是否对齐
- 隐藏状态中能否读出某个答案
- 该隐藏状态是否因果性地控制了答案
这四个维度分别对应“几何结构”“观测可读性”“因果时序”和“多token测量”,是这个冻结提示通道(frozen prompting channel)的相互独立的属性。混淆它们,正是以往研究难以定位真正机制的根源。
研究采用固定的“动物-数字”提示协议,在Llama-3.1系列(从8B到70B)上分别测量每一个维度,力图将这些性质彻底解耦。
固定几何的解释力在下降
实验的第一个发现颇具颠覆性:随着模型从8B扩展到70B,固定输出向量的相似度对行为的预测能力反而变差。配对均值相关性变化为-0.080(95%置信区间[-0.127, -0.035])。话说回来,固定输出头(output-head)的读出在归一化深度AUC上没有显示出明确的变化。
这意味着,单纯依靠输出词表中token的静态几何关系,并不足以解释潜意识传递现象。规模越大的模型,这套“静态几何”叙事越站不住脚。
因果控制才是关键信号
为了检验真正的因果控制,研究者设计了一个精巧的干预实验:将一个数字提示中答案位置的临时状态,在五个不同深度复制到另一个数字提示中,然后观察最终的动物评分究竟跟随哪一个提示。
结果非常显著——供体控制(donor-control)AUC从0.254上升到0.540,配对变化达到+0.286(95%置信区间[+0.272, +0.300]),并且在全部18个概念上都出现了上升。更值得关注的是,即便只剩下八个transformer块,这种对比依然保持,而特异性控制和身份控制则保持很小或精确。
这一结果表明,隐藏状态确实因果性地参与了特征传递,而非仅仅是相关性的巧合。因果时序,是区别于静态几何的独立且更强的证据。
该实验本质上是一种**激活修补(Activation Patching)**技术,是机制可解释性研究中用于建立因果归因的标准方法。其逻辑是:如果将来源提示(donor)某一层的隐藏状态替换到目标提示(recipient)中,最终输出随之改变,则该层的隐藏状态对输出具有因果控制力。AUC(曲线下面积)在此处衡量的是:在给定干预深度下,被修补提示的输出分数究竟更接近供体还是受体的原始分布——AUC=0.5意味着随机水平,AUC=1意味着完全跟随供体。
供体控制AUC从0.254升至0.540这一结果的意义在于:干预前(0.254)接近随机甚至略低,说明两个提示的基线输出差异有限;干预后(0.540)显著高于随机,说明隐藏状态的替换确实改变了动物特征的输出倾向,从而为因果链条提供了直接的实验证据,而非仅凭输出层的静态相似度推断。
多token测量暴露出“长度混淆”
研究还在两个Qwen模型上测试了多token场景,得出了一个警示性的发现。当对序列中的每一个数字逐位打分时,并不能复现单token时观察到的正向关联。
而如果采用逐token平均的方式,则会人为制造出一个正向的池化关联——但这个关联在控制了数字宽度(number width)之后就消失了。换句话说,所谓的关联很可能只是**长度混淆(length confound)**的产物,而非真实的语义纠缠。
这提醒研究者,在多token测量中必须格外警惕统计假象,否则很容易得出误导性结论。
结论:约束了解释,但尚未锁定机制
这项研究的核心贡献在于清晰地证明:固定几何、观测可读性、因果时序和多token测量是这个冻结提示通道的四种截然不同的属性。它们各自从不同角度约束了基于token层面的解释——静态几何解释力有限、长度混淆需要剔除、而因果控制提供了最有力的证据。
但作者也保持了审慎的态度:这些发现约束了token级别的解释,却并未真正识别出训练时特征迁移的底层机制。潜意识学习的完整因果链条,仍是一个开放的研究问题。
对于关注AI安全与可解释性的研究者而言,这篇论文的方法论价值可能超过其具体结论——它为如何严谨地区分“相关”与“因果”提供了一套可复用的实验范式。
背景补充
**长度混淆(Length Confound)**是多token评估中一类典型的统计假象。数字的token宽度(即其被分词后的token数量)并非随机分布:较大的数字通常占用更多token,而不同数字范围可能在训练数据中与不同语义领域存在系统性共现。当研究者对整个数字序列的每个token逐一打分后取均值时,均值本身同时混入了"数字长度"这一混杂变量的影响——长数字贡献更多打分点,若长数字恰好与某类动物存在统计关联,均值就会虚假偏高。
控制数字宽度的标准做法是在回归模型中加入宽度作为协变量,或在相同宽度的子组内分别分析。本文发现,一旦控制该变量,原本观察到的正向池化关联便消失,说明此前看似显著的多token结果并非真实语义纠缠的证据。这对依赖自动化流水线批量评估语言模型输出的研究者是一个重要警示。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。