RAG 进阶学习指南:从原型到深度掌握的优质资源路线
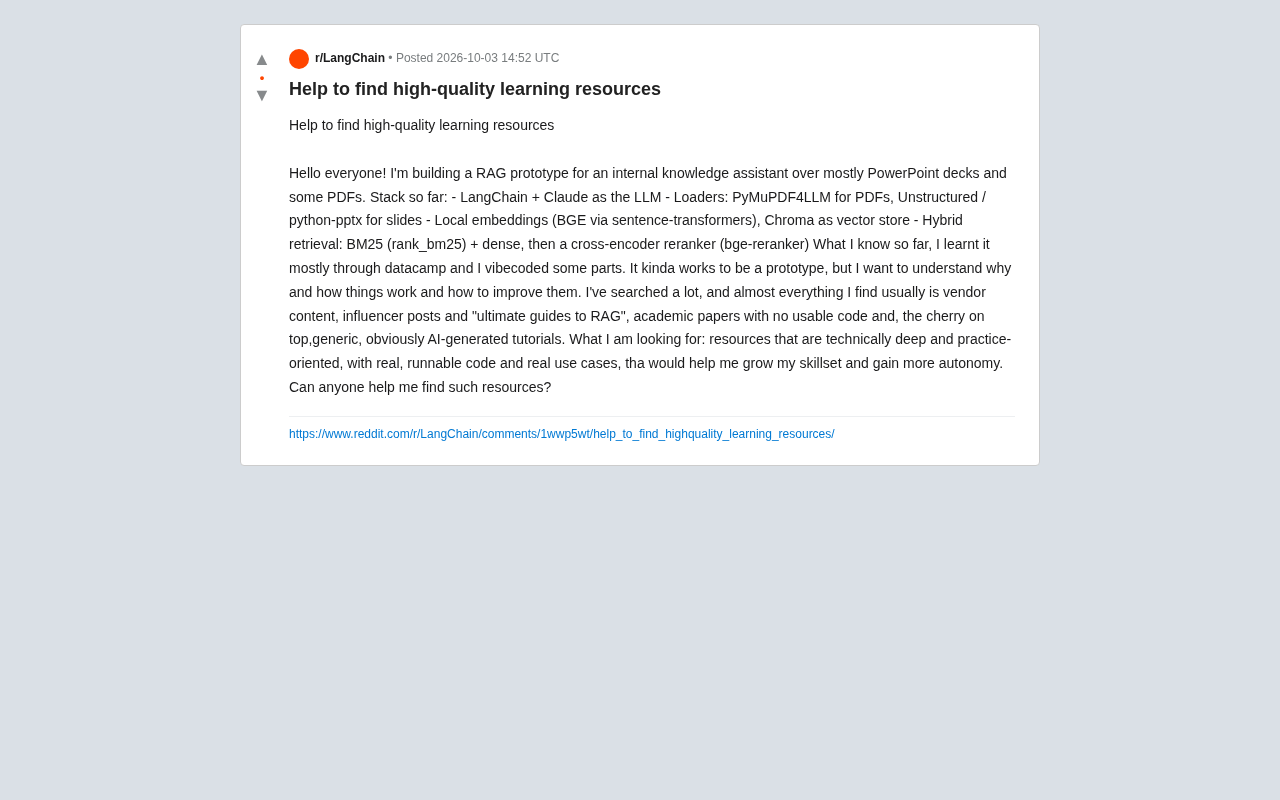
一位开发者已搭建完整RAG原型,但苦于市面资源质量参差,寻求从「能跑」到「懂原理」的系统提升路径。
一位使用LangChain + Claude + 混合检索的开发者,在为企业内部知识助手搭建RAG原型后,发现自己虽能拼凑出「勉强能用」的系统,却对各组件的设计逻辑和优化方向知之甚少。他的困境折射出当下RAG学习生态的普遍问题:市面资源要么是推销产品的厂商软文,要么是概念堆砌的网红帖子,要么是缺乏可运行代码的学术论文,大量AI生成教程更是稀释了信息质量。真正的进阶路径在于三个方向:理解混合检索与重排序的核心权衡、重视文档解析和分块策略这一被低估的系统瓶颈,以及建立可量化的评估体系。方法论上,优先阅读源码、跑带notebook的实战项目、用评估驱动的「假设-验证」循环积累工程直觉,是从调包工程师走向系统设计者的最可靠路径。
一个真实的困境:RAG 原型能跑,但不懂原理
在 Reddit 技术社区,一位开发者抛出了许多人都会遇到的问题。他正在为企业内部知识助手搭建 RAG(检索增强生成)原型,处理对象主要是 PowerPoint 演示文稿和 PDF 文档。他的技术栈已经相当完整:
- 编排框架:LangChain,搭配 Claude 作为大语言模型
- 文档加载器:PyMuPDF4LLM 处理 PDF,Unstructured / python-pptx 解析幻灯片
- 向量化与存储:本地 BGE embeddings(通过 sentence-transformers),Chroma 作为向量库
- 混合检索:BM25(rank_bm25)结合稠密向量检索,再用交叉编码器(bge-reranker)做重排序
这套组合在工程上已经覆盖了现代 RAG 系统的主要环节。但这位开发者坦言,他的知识大多来自 DataCamp 课程,部分代码靠「vibecoding」(凭感觉拼凑)完成。原型「勉强能用」,可他真正想要的,是理解每个组件为什么这样设计、如何运作,以及怎样系统性地改进。
为什么优质 RAG 资源如此难找
这位提问者的抱怨非常具有代表性,几乎是当下 AI 学习者的集体痛点。他搜索了大量内容,结果发现市面上的资源大致分为几类,却没有一类真正解渴:
厂商软文占据了搜索结果的前排,它们的目的是推销自家产品,技术细节往往被包装得天花乱坠却缺乏可迁移性。网红帖子和「RAG 终极指南」看似全面,实则停留在概念堆砌,很少触及工程落地的真实权衡。学术论文虽然深入,但往往没有可运行的代码,复现成本极高。最让人无奈的是那些明显由 AI 生成的泛泛教程——语言流畅、结构工整,却毫无实践价值。
这种信息过载却营养稀缺的状态,本质上反映了 RAG 领域发展太快,而高质量、经过实战检验的教学内容生产速度远远跟不上。
他真正需要的是什么
提问者把需求表达得很清晰:技术上有深度、面向实践、带有真实可运行代码和真实用例的资源,能帮助他提升技能并获得更强的自主能力。
换句话说,他已经过了「能跑就行」的阶段,需要的是从「会用」到「懂原理」的跃迁。这类需求对应的学习路径,其实有章可循。
深入检索与重排序的底层逻辑
既然他已经用上了混合检索和交叉编码器,下一步应该搞清楚为什么混合检索优于单一方案。BM25 擅长精确关键词匹配,稠密向量擅长语义召回,两者互补。而交叉编码器重排序之所以能提升效果,是因为它在查询和文档之间做了更细粒度的交互计算,代价是算力开销更大,因此只适合对召回的候选集做二次精排。理解这些 trade-off,才能在延迟、成本和准确率之间做出合理取舍。
从架构角度看,混合检索通常通过倒数排名融合(Reciprocal Rank Fusion,RRF)或加权线性组合将两路结果合并。RRF 的核心思想是:无论文档在各路排名中的绝对分数如何,只要在多路结果中持续高排,最终融合分数就会提升,这种方式对分数尺度不敏感,实践中往往比手动调权重更稳健。交叉编码器(Cross-Encoder)与双编码器(Bi-Encoder)的根本区别在于:双编码器将查询和文档分别编码为独立向量,相似度计算是向量点积,速度极快,适合从百万级语料中粗召回;交叉编码器则将查询和文档拼接后一起输入模型,通过注意力机制捕捉细粒度的词语交互,精度更高但无法预计算,只能对已召回的小候选集(通常几十到几百条)做重排。理解这一根本差异,是合理设置召回数量(top-k)和权衡延迟与精度的前提。
文档解析才是 RAG 的隐形瓶颈
对于以 PPT 和 PDF 为主的场景,文档解析质量往往决定了系统上限。幻灯片的版式复杂、信息碎片化,表格和图表难以转为高质量文本。这正是 Unstructured、PyMuPDF4LLM 这类工具存在的意义,但它们各有局限。深入研究分块(chunking)策略、如何保留文档结构语义、如何处理表格,比单纯调模型更能带来效果提升。
分块策略(Chunking)对检索质量的影响常被低估。常见策略包括:固定字符数分块(简单但易割断语义)、按句子或段落分块(语义更完整但大小不均)、以及递归字符分块(LangChain 默认方案,按段落→句子→字符逐级回退)。近年兴起的语义分块(Semantic Chunking)通过计算相邻句子的嵌入相似度来决定切分点,能更好保留话题边界,但计算成本更高。对于 PPT 这类信息密度不均匀的文档,还需考虑「父子块」(Parent-Child Chunk)策略:存储小块以提升检索精度,但在送入 LLM 时返回其所在的较大上下文块,避免因切割过细导致上下文丢失。chunk 大小与 overlap 参数没有通用最优值,需要结合具体文档类型和查询模式通过评估基准来调优。
建立可量化的评估体系
「kinda works」(勉强能用)这个表述暴露了一个关键缺失——没有评估指标。真正的进阶,是建立一套能量化检索质量和生成质量的评估流程,比如用检索命中率、上下文相关性、答案忠实度等指标。只有能被度量,改进才有方向,否则所有优化都是凭感觉。
RAG 评估通常分为两个维度:检索质量和生成质量。检索质量常用指标包括 Recall@k(前 k 条结果中相关文档的召回率)和 MRR(平均倒数排名);生成质量则更复杂,业界常用的框架如 RAGAS 提供了三个核心指标——忠实度(Faithfulness,答案是否有检索内容支撑、无幻觉)、答案相关性(Answer Relevancy,答案是否切题)和上下文精准率(Context Precision,检索到的内容有多少真正被用上)。构建评估集的最小可行方案是手动标注 50-100 条「问题-标准答案-关联文档」三元组,用它反复测量组件替换前后的指标变化,才能将「感觉有改善」变成可复现的工程结论。
给同类学习者的建议
这位开发者的处境,是从「调包工程师」走向「系统设计者」的典型转折点。结合他的困惑,有几条可行的成长路径:
优先读源码而非教程。LangChain、Chroma、sentence-transformers 这些工具都是开源的,直接阅读核心模块的实现,比看二手解读更能理解设计意图。
关注带 notebook 的实战项目。真正有价值的学习资源往往附带可运行的 Jupyter notebook 或完整仓库,能让你边改边验证假设,而不是单向接收结论。
从评估驱动开发切入。先搭建评估基准,再针对性地替换组件——比如换个 reranker、调整 chunk 大小——观察指标变化。这种「假设-验证」的循环,是积累工程直觉最快的方式。
警惕 AI 生成内容的陷阱。正如提问者所察觉的,大量泛泛内容正在稀释信息质量。判断资源价值的一个简单标准:它是否敢于讨论失败案例、边界条件和真实权衡,而非只展示理想路径。
这位开发者的提问本身就是优质学习的开端——他没有满足于能跑通的原型,而是追问背后的原理。对任何想在 AI 工程领域建立长期竞争力的人来说,这种「知其所以然」的驱动力,远比掌握某个具体框架更重要。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。