RAG从入门到实战:搭建私有知识库完整教程
RAG通过检索企业私有知识再交给大模型生成回答,解决大模型不知内部数据的局限。
文章系统拆解了RAG(检索增强生成)的工作原理与落地流程。RAG的核心思路是让大模型在回答前先从企业知识库检索相关内容,再结合这些内容生成回答,从而让通用大模型能用上私有数据。流程分两阶段:知识库构建阶段包括数据转换(如OCR识别图片文字)、数据分片、Embedding向量化并存入向量数据库(常用Milvus);问答阶段则对用户问题做同样的向量化,通过余弦相似度检索最相关片段,拼接进提示词交给大模型生成回答。文章还讨论了嵌入模型、向量数据库、分片策略、提示词设计等关键选型,并指出知识图谱是应对复杂推理的进阶方向。
大模型虽然能力强大,但有一个根本性的局限:它不知道你企业内部的数据。无论是客服对话记录、产品文档,还是数据库里的业务信息,通用大模型都无法直接访问。想让大模型基于私有数据回答问题,目前主流方案有两种:一是通过工具调用连接企业内部数据源,二是使用RAG(检索增强生成)。
据B站教程分享者的讲解,RAG的核心思路并不复杂——让大模型在回答用户问题之前,先从企业知识库中检索出相关内容,再结合这些内容生成回答。本文将完整拆解RAG的工作原理、知识库构建流程,以及从文档处理到最终生成回答的每一个关键环节。
RAG是什么?为什么需要它
RAG全称Retrieval-Augmented Generation,即检索增强生成。它解决的问题很直接:大模型不知道你企业内部的数据,而RAG能让大模型在回答问题时,动态获取并利用这些私有知识。
举个具体场景。假设你有一批历史上真人客服与用户的对话记录,现在要构建一个智能客服助手。用户提问"我的电脑坏了,应该从几个方面入手维修",你希望Agent的回答能结合企业积累的客服知识,而不是给出泛泛的通用建议。这时候,RAG就是实现这一目标的核心技术路径。
相比让大模型通过工具去连接企业内部数据的方式,RAG的优势在于它不需要模型直接访问数据库,而是通过检索机制将相关知识"喂"给模型,灵活性和安全性都更好。
RAG的核心工作流程
整个RAG流程可以拆解为两个阶段:知识库构建阶段和用户问答阶段。
第一阶段:构建知识库
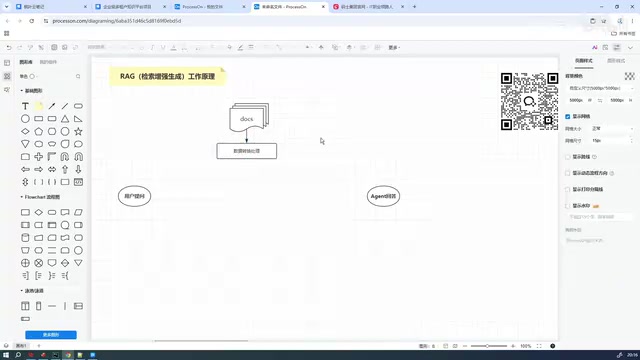
企业内部的原始数据(Docs)格式五花八门——PDF、Markdown、Excel、图片、表格等。构建知识库的第一步是数据转换。比如文档中嵌入了图片,知识库无法直接存储图片内容,就需要通过OCR等手段将图片中的文字识别出来,转化为可检索的文本。
转换完成后,下一步是数据分片(Chunks)。一份大文档内容太多,需要切分成多个小片段。分片的粒度、重叠策略都会影响后续检索的准确性,这里面的讲究不少。
分片之后进入Embedding嵌入环节。每个文本片段通过嵌入模型转换为向量(一组数学上的数值表示),然后存入向量数据库。目前最常用的向量数据库是Milvus,此外Redis、Pinecone、Elasticsearch等也都可以作为存储方案。
Embedding嵌入是整个RAG系统的语义基础。所谓嵌入,是指用神经网络模型将一段文本映射成一个高维向量(通常是768维到1536维之间的浮点数数组),使得语义相近的文本在向量空间中距离更近。例如"电脑无法开机"和"主机不能启动"虽然用词不同,但嵌入后的向量会非常接近。常见的嵌入模型包括OpenAI的text-embedding系列、BGE、M3E等,中文场景下BGE和M3E表现较好。嵌入模型的选择直接决定了检索能否"理解"用户意图,而非仅仅匹配关键词——这也是向量检索区别于传统全文检索(如Elasticsearch的BM25算法)的核心所在。
第二阶段:用户提问与回答生成
当用户提出问题时,系统对用户的问题同样进行Embedding嵌入,将其转为向量。然后在向量数据库中做相似度计算——最广泛使用的是余弦相似度——找出与用户问题语义最相关的那些文本片段。
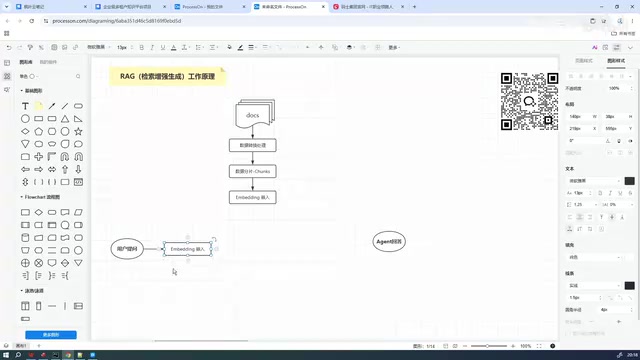
找到相关片段后,系统将这些片段和用户原始问题一起交给大模型。提示词中会明确告诉模型:用户的问题是某某,找到的企业内部相关知识是某某,请根据这些知识做出回答。
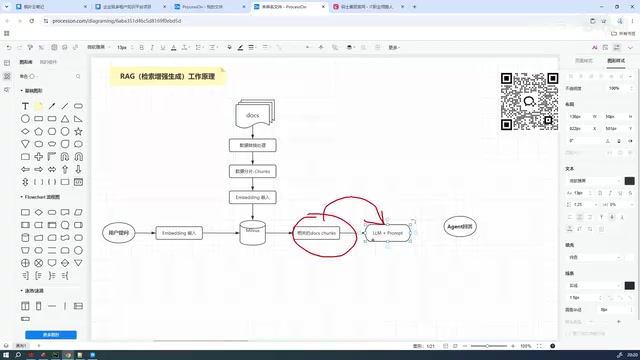
这个流程就是RAG最概括性的原理。用户提问→向量化→相似度检索→拼接上下文→大模型生成回答,形成完整的闭环。
余弦相似度衡量的是两个向量在方向上的接近程度,取值范围为-1到1,值越接近1表示语义越相似。它只关注向量的方向而不受长度影响,因此特别适合文本嵌入向量的比较。与之相关的还有欧氏距离(衡量向量间的直线距离)和点积(两者结合的变体),但余弦相似度因其对向量模长不敏感、计算稳定,成为RAG场景中最主流的选择。多数向量数据库(如Milvus)默认支持多种距离度量方式,实际使用时可根据嵌入模型的训练方式选择对应的度量方法,以取得最佳检索效果。
关键组件与技术选型
理解流程之后,几个关键组件的选型值得关注。
嵌入模型决定了文本向量化的质量,直接影响检索精度。不同模型在中文语义理解上的表现差异明显,需要根据实际场景选择。
向量数据库方面,Milvus因其开源特性和良好的扩展性成为社区首选。如果已有Redis或Elasticsearch基础设施,也可以直接复用,降低部署成本。
分片策略是容易被忽视但影响巨大的环节。片段太大,检索到的信息噪音多;片段太小,可能丢失上下文语义。实际项目中需要反复调试。
提示词设计同样关键。如何把检索结果有效地组织进Prompt,让大模型准确利用这些知识而不是忽略它们,是工程实践中需要打磨的细节。
教程分享者也提到,自学RAG容易遇到的问题是知识体系不系统,遇到具体问题(比如项目执行流程不清楚)时缺少人能及时解答,一层窗户纸可能卡住很久。
从RAG到知识图谱:进阶方向
RAG并非终点。分享者透露正在编写新项目中的知识图谱部分,这也指向了RAG技术的一个重要进阶方向——当简单的向量检索无法满足复杂的推理和关系查询需求时,知识图谱可以作为RAG的补充甚至替代方案。
知识图谱擅长处理实体之间的关系,比如"产品A的故障原因导致客户投诉类型B"这类多跳推理。将知识图谱与RAG结合,是目前业界探索的前沿方向之一。
对于刚入门的开发者来说,先把基础RAG流程跑通、搭建出一个能用的私有知识库问答系统,是最务实的起点。后续再根据业务需求逐步引入更复杂的检索策略和知识组织形式。
知识图谱是一种以图结构组织知识的方式,节点代表实体(如产品、客户、故障类型),边代表实体之间的关系(如"导致""属于""投诉")。与向量数据库存储文本片段不同,知识图谱显式地建模了实体间的语义关联,因此天然适合回答"A和B之间是什么关系""导致C的原因有哪些"这类需要多跳推理的问题。将知识图谱与RAG结合的一种典型做法是GraphRAG:先从文档中抽取实体和关系构建图谱,查询时既做向量检索也做图遍历,把结构化的关系路径一并交给大模型。这种方式在需要跨文档关联推理的场景中,效果往往优于纯向量检索。
相关推荐

金融文档推理部署:自托管与托管方案的成本隐私权衡
金融文档推理部署选型指南:按公开filings、客户文档、内部研究三类分别决策自托管与托管方案,从成本利用率、隐私要求和运维责任三个维度给出可操作的混合架构设计方法。

Dify插件TubeText:接入TikTok Shop与AliExpress数据
开源 Dify 插件 TubeText 为工作流接入 TikTok Shop 商品数据、AliExpress 搜索与视频转录四个工具,基于 Apify 按结果计费,支持异步长任务与 Agent 调用。

200行Python工具agentverify:捕获AI代理数据泄露
agentverify 是一个约200行零依赖的 Python 工具,通过在工具调用边界独立验证 AI 代理的真实副作用,捕获输出测试无法发现的数据泄露,并支持变更触发的漂移检测与签名证据。