RAG框架赋能路口安全:用大模型将事故叙述转化为对策建议
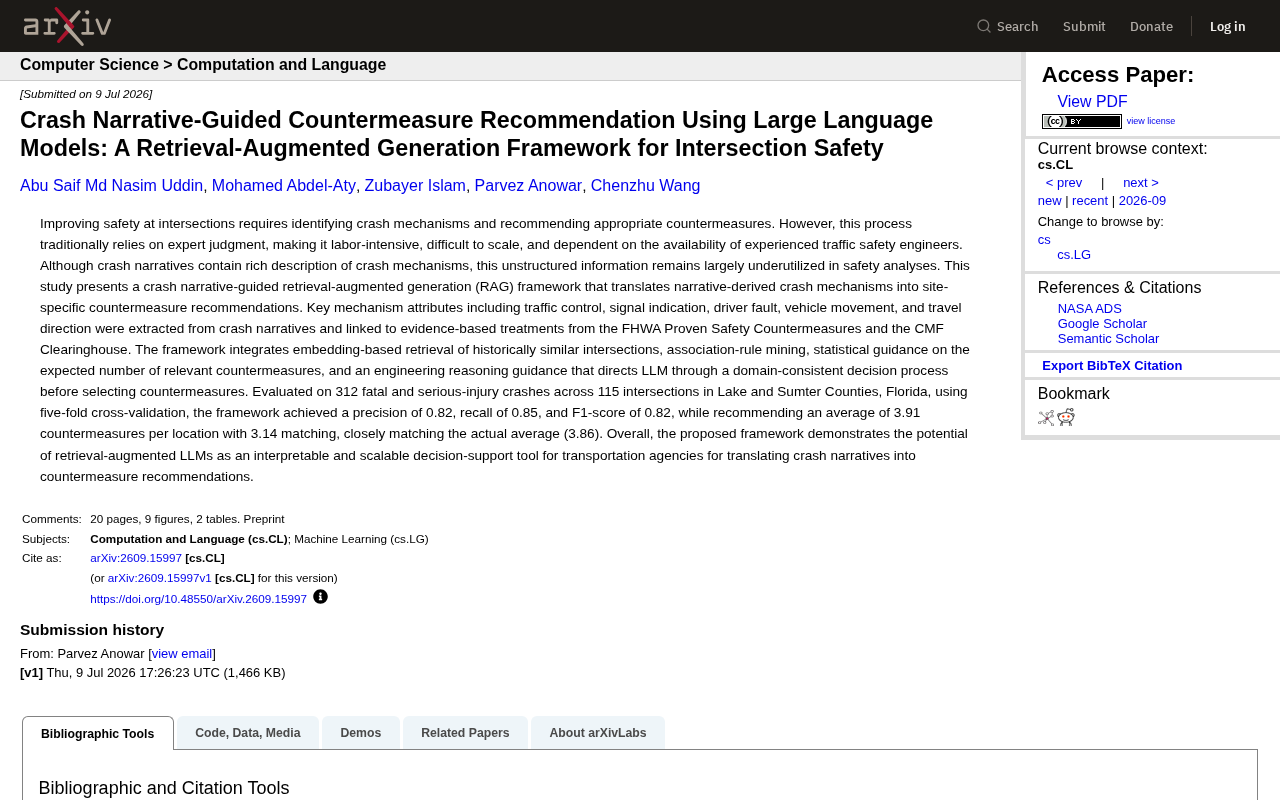
RAG框架将事故叙述文本自动转化为循证路口安全对策,F1分数达0.82,推荐数量与实际高度吻合。
这项发表于arXiv的研究针对交通安全工程师判断难以规模化的痛点,提出了一套检索增强生成(RAG)框架,将传统上被闲置的事故叙述性文本转化为针对具体交叉路口的循证整改建议。框架从叙述中抽取交通控制方式、驾驶员过错等关键机理属性,对接FHWA已验证安全对策库与CMF Clearinghouse,并通过嵌入检索、关联规则挖掘、统计引导和工程推理引导四层机制约束LLM输出,确保建议的可解释性与领域一致性。在佛罗里达州115个路口、312起严重事故的真实数据上,框架实现了精确率0.82、召回率0.85、F1分数0.82,且推荐对策数量(平均3.91项)与实际(3.86项)几乎吻合,展示了大模型在高规范领域落地的务实路径。
交通安全分析的老问题:专家判断难以规模化
改善交叉路口安全的传统流程离不开交通安全工程师的经验判断——识别事故成因、再匹配对应的整改对策。这套依赖专家的工作模式存在明显瓶颈:耗费人力、难以规模化,且高度依赖有经验工程师的可获得性。当路口数量成百上千时,逐一人工分析几乎不现实。
更被忽视的一点是,事故报告中的**叙述性文本(crash narratives)**其实蕴含了对事故机理的丰富描述,但这些非结构化信息在传统安全分析中基本处于闲置状态。一篇发表在arXiv上的研究(arXiv:2609.15997)正是瞄准了这一痛点,提出用检索增强生成(RAG)框架,把事故叙述自动转化为针对具体路口的对策建议。
框架设计:从叙述文本到对策的完整链路
该研究的核心思路,是先从事故叙述中抽取关键机理属性,再将其对接到有循证依据的整改措施库。抽取的属性包括:交通控制方式(traffic control)、信号灯指示(signal indication)、驾驶员过错(driver fault)、车辆运动状态(vehicle movement)以及行驶方向(travel direction)。
这些机理属性随后被链接到两个权威数据源:美国联邦公路管理局(FHWA)的Proven Safety Countermeasures(已验证安全对策),以及CMF Clearinghouse(碰撞修正系数库)。这意味着模型给出的建议并非凭空生成,而是锚定在行业公认的循证治理措施上。
四层机制协同工作
框架并非单纯依赖大模型的自由发挥,而是叠加了多层结构化约束:
- 基于嵌入的检索:通过embedding找到历史上相似的路口案例,为当前路口提供参照;
- 关联规则挖掘:从历史数据中发现事故属性与对策之间的关联模式;
- 统计引导:给出每个路口预期相关对策数量的统计参考,避免推荐过多或过少;
- 工程推理引导(engineering reasoning guidance):在选择对策前,引导大模型走完一套符合领域逻辑的决策流程。
这套设计的关键价值在于——它让大模型的输出变得可解释且符合工程规范,而不是黑箱式的随机建议。这也是该框架区别于直接调用LLM的核心所在。
**CMF Clearinghouse(碰撞修正系数库)**是由美国联邦公路管理局维护的一个公开数据库,收录了大量经过实证研究验证的交通安全对策及其对应的碰撞修正系数(Crash Modification Factor,CMF)。CMF是一个量化指标,表示实施某项安全改善措施后,预期事故数量的变化比例——例如CMF为0.8意味着该措施可使事故减少约20%。工程师通过查询CMF Clearinghouse,能够基于证据级别和统计置信度筛选适用于特定路口条件的措施,而非凭经验拍板。将LLM的输出锚定在这一数据库上,意味着每条建议背后都有可追溯的实证依据,这对高风险决策场景至关重要。
关联规则挖掘是数据挖掘领域的经典方法,用于在大规模事务数据中发现"如果A出现则B也常出现"的共现模式,常见指标包括支持度(support)、置信度(confidence)和提升度(lift)。在本框架中,历史事故数据被转化为"事故属性→对策"的事务集,挖掘出的规则可以揭示诸如"当路口缺乏信号控制且存在左转冲突时,80%的案例都采用了增设保护性左转相位"这类规律。这些规则一方面为LLM的推理提供结构化先验,另一方面也充当一道验证层——当模型建议与历史高置信度规则相悖时,可触发额外的校验逻辑。这是该框架在"纯检索"之外引入显式模式知识的关键设计。
实测表现:F1达到0.82,推荐数量贴近实际
研究团队在佛罗里达州Lake县和Sumter县的真实数据上进行了验证,样本覆盖115个交叉路口、312起致命及重伤事故,采用五折交叉验证。
结果显示,该框架取得了:
- 精确率(Precision)0.82
- 召回率(Recall)0.85
- F1分数 0.82
在推荐数量上,框架平均为每个路口推荐3.91项对策,其中3.14项与实际匹配,而实际平均对策数为3.86项——推荐数量与真实情况几乎吻合。这组数据说明,模型不仅在“推荐对不对”上表现良好,在“推荐多不多”这一容易被忽视的维度上也做到了克制与准确。
对交通管理机构而言,推荐数量的准确性同样重要:过度推荐会浪费有限的整改预算,推荐不足则可能遗漏关键隐患。
五折交叉验证(5-fold cross-validation)是机器学习中评估模型泛化能力的标准方法:将数据集随机分成5份,每次用其中4份训练、1份测试,循环5次后取平均结果。相比单次划分,这种方式能更稳健地估计模型在未见数据上的真实表现,尤其适合本研究中样本量有限(115个路口)的场景。值得注意的是,在交通安全对策推荐这一任务中,精确率与召回率的权衡具有不对称的现实含义:精确率低意味着推荐了不必要的措施,浪费整改预算;召回率低则意味着遗漏了真正需要的对策,可能导致安全隐患持续存在。本研究两项指标均超过0.82,说明框架在这一权衡上取得了较为均衡的结果。
意义与局限:可扩展的决策支持工具
这项研究展示了检索增强大模型作为交通安全决策支持工具的潜力。它的两大卖点是可解释性和可扩展性:前者来自工程推理引导和循证对策库的约束,后者则解决了专家判断难以规模化的根本问题。对于人力有限、又面临大量待评估路口的地方交通部门来说,这类工具能显著降低分析门槛。
不过也要客观看待其边界。研究的验证范围仅限于佛罗里达两个县的数据,路网特征、气候、驾驶习惯的地域差异是否会影响泛化能力,仍需更大范围的验证。此外,框架高度依赖事故叙述文本的质量与完整度——如果原始报告记录粗糙,抽取出的机理属性也会随之失真。
总体来看,这项工作提供了一个有价值的范式:把大模型放进有约束、有循证依据的管道里,而非让它独自决策。这或许也是LLM在高风险、强规范领域落地的一条务实路径。
相关推荐
Ollama 入门指南:本地部署开源大模型的利器
Ollama 是一款免费开源的本地大模型管理工具,支持将 DeepSeek 等开源模型部署到本地。本文介绍 Ollama 是什么、跨平台特性、CPU/GPU 支持及本地部署的应用场景,适合零基础入门 AI 大模型开发。
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。