RAG企业知识库实战:从原理到优化的全流程解析
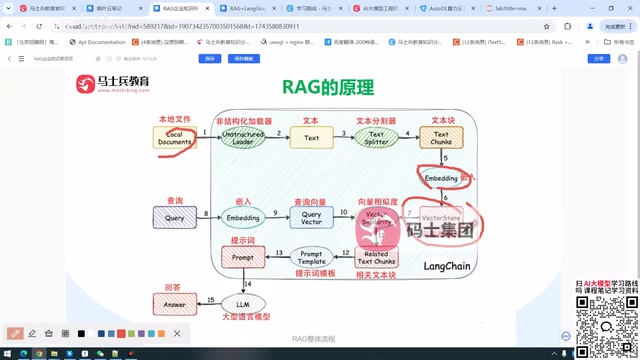
RAG通过外部知识库检索增强大模型生成,核心挑战在于切片、嵌入、检索与重排序的持续优化。
本文系统介绍了RAG(检索增强生成)的核心原理与工程实践。RAG通过构建外部知识库并在生成前先检索相关内容,解决大模型训练数据时效性不足和"幻觉"问题。文章将RAG流程拆解为知识库构建(数据加载、文本切片、向量嵌入、存入向量数据库)和查询响应(检索、重排序、传给大模型生成答案)两个阶段,并重点强调:AI项目与传统CRUD开发的本质区别在于,功能跑通只是起点,持续优化准确率和召回率才是真正的工作量所在。切片策略、检索器组合与重排序是影响RAG质量的三大关键环节,而整个流程的核心基础设施是向量数据库,因此课程选择以Milvus作为学习起点。
RAG到底在解决什么问题
RAG(Retrieval Augmented Generation,检索增强生成)本质上是为大模型补充外部知识的一套方案。大模型的训练数据存在时效性和覆盖面的局限,面对企业内部数据、行业专有知识时往往力不从心,甚至编造出看似合理实则错误的答案,也就是所谓的"幻觉"。
RAG的核心思路是:把企业内部数据以及从其他渠道获取的数据整理成一个知识库,在大模型回答问题时先从知识库检索相关内容,再让模型基于检索结果生成答案。这样做的直接收益是提高了模型在知识密集型任务中的准确性和可信度,把幻觉出现的概率尽可能压低。
值得强调的是,这里的知识库数据既可以是结构化数据(如公司内部的关系型数据库),也可以是非结构化数据(如本地的PDF、Word、Markdown、TXT文件)。数据形态的多样性,正是RAG工程复杂度的起点。
RAG的基本流程:看似简单,实则暗藏细节
一个最基础的RAG流程可以拆解为两个阶段。第一阶段是构建知识库:拿到各类数据后进行处理,文本需要切割成一个个chunk(切片),然后经过词嵌入(embedding)转换成向量,最终存入向量数据库。第二阶段是查询响应:用户输入问题后,系统根据问题去向量数据库做检索,把检索结果经过处理后连同提示词一起传给大模型,由模型生成最终答案。
这里有个初学者常问的问题值得澄清:向量数据库能不能存图片?答案是可以。向量数据库本质上存储的是向量,图片可以转换成向量,文本也可以转换成向量。但要注意两点:处理图片需要专门的图片embedding模型,而不能用文本embedding;同时图片向量和文本向量应当存放在不同的collection(集合,相当于向量数据库里的"表"概念)中,否则后续检索会非常不便。
此外,文本需要切割成chunk,而图片不存在切割,整张图片直接转换成向量存入即可。听完这套流程,很多人会觉得RAG很简单——但真正上手做项目后,才会意识到每个环节都藏着大量需要打磨的细节。
词嵌入(Embedding)是将文本转化为高维数值向量的技术,其核心思想是让语义相近的文本在向量空间中距离更近。例如"苹果手机"和"iPhone"在向量空间中的距离,会远小于"苹果手机"和"苹果公司财报"之间的距离——尽管后两者都包含"苹果"这个词。向量数据库正是利用这一特性,通过计算查询向量与库中所有向量的距离(常用余弦相似度或欧氏距离),快速找出最相关的文档片段。这种基于语义的检索方式,是RAG相比传统关键词检索的核心优势所在——它能理解语义而非仅匹配字面。
为什么AI项目和传统开发不一样
UP主特别强调了一个来自实战的观察:从Java开发转向AI项目的同学,最容易踩的坑是思维惯性。传统的CRUD(增删改查)项目,只要功能完成、测试通过没有bug,基本就可以交付了。
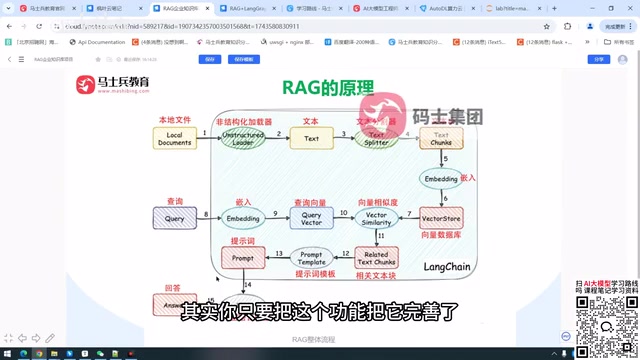
但AI项目完全不同。以RAG为例,功能跑通只是第一步,真正的挑战在于:系统给出的答案,其准确率、召回率能不能达到企业要求?达不到,就必须对RAG进行持续的优化和调整。也正因为如此,AI项目的需求描述往往非常简短——"做一个客服系统,用户问问题、AI给回复",一句话就说完了。真正的工作量,全部集中在如何把这个流程做到足够可靠、足够精准。
换句话说,RAG的原理人人都懂,但不同RAG系统的差距,恰恰体现在优化的功力上。
RAG优化的关键环节
所谓优化RAG,就是在流程的各个环节提供不同的解决方案,让最终生成的答案尽可能不出现幻觉。UP主梳理了几个核心的优化点:
向量数据库的选择
数据量大小不同,适合的向量数据库也不同。本课程选用的是Milvus,据UP主了解,这是目前市面上大型项目中使用较多的专业向量数据库。课程会涵盖它的本地化部署和服务器部署,以及它相对其他方案的优势。
数据加载与切片
本地文件类型繁多——PDF、Word、Markdown、TXT,每种类型的加载方式和切片策略都不一样。切片绝不是简单地按固定长度切。像Dify这类工具默认按固定字数切割(比如设定chunk为200字,就每200字切一刀),但这种方式很可能破坏语义完整性。
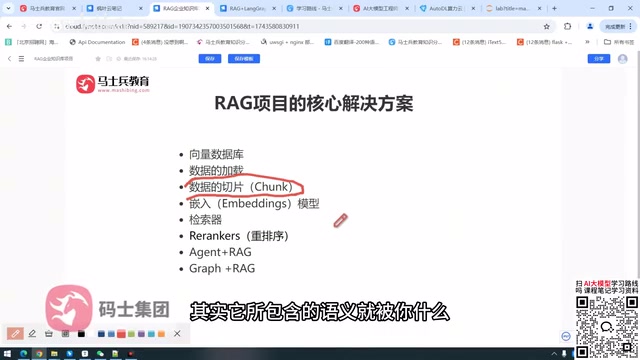
更精细的切片策略可以按标点、按语义、按段落切分,PDF可以按页切,Markdown可以按标题切。切片没做好,本来完整的一句话被从中切断,语义特征就损失了,RAG最终生成的结果就更容易出现幻觉。
词嵌入与图嵌入模型
embedding模型既有商用方案(OpenAI、智谱、通义千问等),也有来自HuggingFace的开源方案。课程中两类都会用到,并会区分哪些embedding用于文本词嵌入、哪些用于图片的图嵌入。
检索器:RAG优化的核心战场
简单的RAG只用相似性检索(按相似度排序返回结果),但检索器远不止这一种。范围检索、分组检索、混合检索、全文检索等等,实战中往往是多种检索器组合使用,以此保证检索结果的准确性。
重排序(Rerank)
检索通常会返回一个Top10或Top5的结果,这些结果虽然已按相似性排序,但相似度高不等于最相关。因此需要引入额外的模型做重排序(Rerank),按相关性重新排列结果。
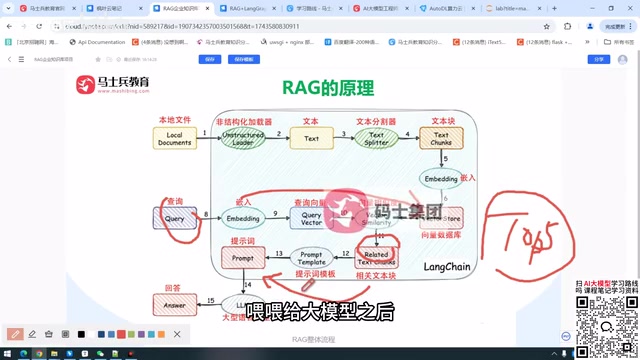
重排序之后的结果才被放入提示词传给大模型,模型会依据这个排好的顺序给出更精准的答案。跳过重排序,同样会增加幻觉的可能性。
重排序模型(Reranker)与向量检索所用的Embedding模型在架构上有本质区别。Embedding模型将文档和查询分别编码为独立的向量,再计算相似度,速度快但精度有损;而Reranker通常采用交叉编码器(Cross-Encoder)架构,将查询和候选文档拼接后一起输入模型,让两段文本在注意力层充分交互,从而输出更精准的相关性分数。代价是计算量更大,不适合在全量数据上运行——这也是为什么工程上普遍采用"粗检索(向量召回Top50)+精排(Rerank取Top5)"的两阶段策略,以此平衡性能与准确率。
结合Agent与工作流
完整的RAG还会与Agent(智能体)和图(工作流)结合,进一步扩展系统能力。这些都是让RAG从"能用"走向"好用"的重要拼图。
Agent(智能体)在RAG场景中的核心价值是赋予系统"决策能力":面对复杂问题时,Agent可以判断是否需要检索、检索哪个知识库、是否需要多轮检索或调用外部工具(如计算器、数据库查询API)。工作流(Graph/Pipeline)则将多个步骤编排成有向图,支持条件分支、并行处理和循环迭代。两者结合后,RAG系统就能处理"先查财务数据库、再查政策文档、最后综合两者给出建议"这类需要多步推理的复杂任务,而不仅仅是单轮的"检索+生成"。LangGraph、LlamaIndex Workflows等框架正是为此类场景而设计的。
为什么从向量数据库开始学
梳理完所有环节会发现,切片、嵌入、检索、重排序——这些看似独立的步骤,其实都围绕着同一个核心:向量数据库。没有向量数据库,切好的chunk无处存放,检索无从谈起,重排序更是无源之水。
正因如此,本系列教程选择从向量数据库Milvus入手,先把这个地基打牢,再逐步展开数据加载、切片、嵌入、检索、重排序等后续环节。这是一条符合工程逻辑的学习路径,也能帮助初学者建立起对RAG整体架构的清晰认知。
对于想搭建私有知识库或企业级问答系统的开发者来说,理解"RAG不只是把功能跑通、而是一场持续的优化工程"这个认知,或许比任何单一技术点都更为重要。
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。