RAG与Agent实战:大模型接入的两种路径
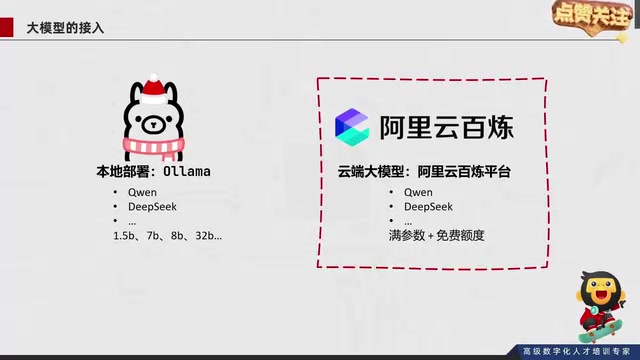
对比本地部署与云端调用两条大模型接入路径,并以阿里云百炼为例演示注册、API Key 创建与免费额度管理。
文章围绕大模型应用开发的第一步——模型接入展开。本地部署依托 Ollama,受硬件限制只能运行 1.5B、7B、8B 级蒸馏模型,胜在隐私与离线;云端调用可获取满参数模型,体验更好但通常付费。课程选择阿里云百炼作为接入底座,因其提供免费额度。文中详述了注册登录、支付宝实名认证、在密钥管理中创建 API Key 的流程,并说明平台按模型独立计算额度(每个约 100 万 tokens,可轮换使用),勾选「免费额度用完即停」可防止意外计费。最后指出接入只是起点,RAG 与 Agent 的工程细节才是决定应用效果的关键。
大模型接入:本地部署 vs 云端调用
开发大模型应用,第一步是把模型接进来。据B站该课程讲解,目前主流方式有两种:本地部署与云端调用。
本地部署依赖 Ollama 框架,可在个人电脑上运行千问、DeepSeek广告 等蒸馏模型。受硬件配置限制,本地能跑的多为 1.5B、7B 或 8B 参数级别的模型,适合对数据隐私敏感或需要离线运行的场景。
云端调用则借助平台获取满参数模型,体验更好,但通常需要付费。课程中选择阿里云广告百炼平台作为接入底座,原因是其提供免费额度,学习期间足以覆盖调用成本。这一选择背后是一个务实的权衡:学习阶段优先保证模型能力上限,而非追求本地化。
蒸馏模型是指通过知识蒸馏(Knowledge Distillation)技术,将大参数「教师模型」的能力迁移到小参数「学生模型」上得到的压缩版本。训练时让学生模型同时拟合真实标签和教师模型的输出分布(软标签),从而在参数量大幅减少的情况下保留大部分推理能力。千问、DeepSeek 等系列都提供了 1.5B、7B、8B 等蒸馏或小尺寸版本,正是这类模型让普通个人电脑的本地推理成为可能。
参数规模(如 1.5B、7B、8B) 中的 B 指 billion,即十亿参数。参数越多,模型通常能力越强,但对显存和算力的要求也越高。粗略估算,FP16 精度下每 10 亿参数约需 2GB 显存,7B 模型仅加载权重就需 14GB 左右,量化压缩后可降至 4-8GB。这解释了为何本地部署普遍停留在 7B、8B 级别,而满参数模型只能依赖云端。
百炼平台注册与API Key创建
接入流程本身并不复杂。打开百炼官网后完成注册登录,新账号会弹出服务协议,同意后进入实名认证环节。个人认证通过支付宝扫码刷脸即可完成,企业认证则适用于组织账号。
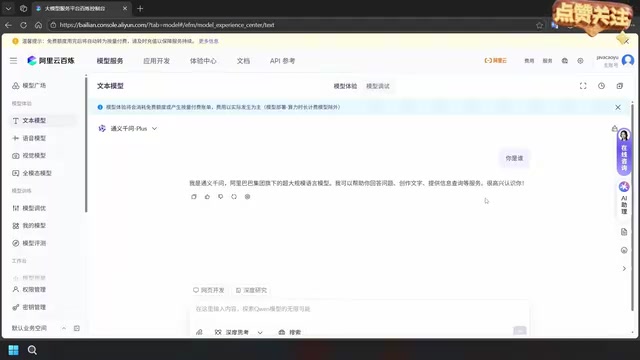
认证完成后重新进入平台,页面会提示赠送免费额度,点击开始体验即可在网页端直接试用模型。但对开发者而言,网页体验只是验证,真正的接入需要通过代码调用,核心凭证是 API Key。
在左侧菜单找到「密钥管理」,创建 API Key 并选择所属账户,即可生成一串密钥。这串密钥就是代码联网调用云端模型的「钥匙」,后续所有代码请求都依赖它完成身份验证。
API Key 是一串由平台生成的机密字符串,用于在代码请求中标识调用者身份并完成鉴权与计费归属。调用云端大模型时,程序通常把 API Key 放在 HTTP 请求头的 Authorization 字段中(常见形式为 Bearer sk-xxxx),平台校验通过后才返回模型结果。API Key 等同于账户 credentials,一旦泄露可能被他人盗用额度甚至产生费用,因此不应硬编码进公开代码仓库,实践中推荐通过环境变量或密钥管理服务读取。多数平台支持创建多个 Key 并单独吊销,便于按项目隔离和泄露后快速止损。
免费额度管理与防超支设置
百炼平台的免费额度按模型独立计算。课程演示中提到,平台上有 172 个模型的额度处于充沛状态,每个模型基本提供 100 万 tokens 的免费用量。这意味着学习者可以在一个模型额度用尽后切换另一个,轮换使用足以覆盖课程全部内容。
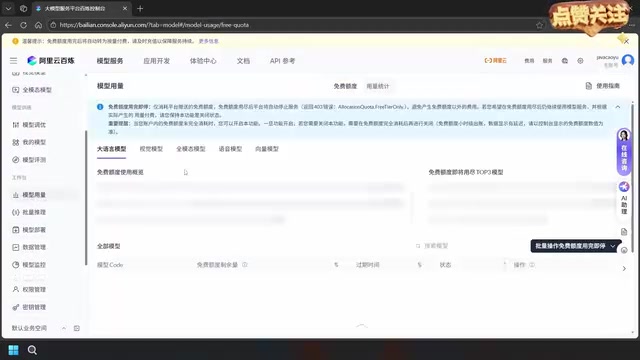
如果担心产生额外费用,可以在模型用量页面勾选「免费额度用完即停」。该选项的作用是:额度耗尽后该模型自动停用,避免意外计费。对于学习场景,这是一个低成本的风控手段。
从接入到RAG与Agent的路径
完成 API Key 创建,只解决了「模型从哪来」的问题。课程标题指向的 RAG 检索增强与智能体 Agent 实战,才是应用开发的主体。RAG 解决的是模型知识边界与幻觉问题,通过外挂检索让回答有据可依;Agent 则让模型具备工具调用与多步任务规划能力。
一个合理的推断是:无论 RAG 还是 Agent,底层都依赖稳定的模型调用通道。先跑通云端接入、管理好额度,再叠加检索与工具层,是这类课程常见的递进结构。本地 Ollama 方案则适合在开发后期做降本或隐私合规的替代验证。
RAG(Retrieval-Augmented Generation,检索增强生成) 的基本流程是:先把外部文档切分成片段并转为向量存入向量数据库;用户提问时,将问题同样向量化,检索出最相关的若干片段;再把这些片段作为上下文拼进提示词,交给大模型生成回答。它不改变模型权重,而是通过「先查后答」把事实依据外挂进来,从而缓解模型知识过期与幻觉问题。
Agent(智能体) 则是在模型调用之外增加一层控制循环:模型根据任务决定调用哪个工具(搜索、计算、数据库查询等),观察工具返回结果,再决定下一步动作,直至任务完成。其核心是「推理—行动—观察」的迭代编排。RAG 可视为 Agent 可调用的一种工具,二者常组合使用,而它们的共同前提都是一个稳定、可编程的模型调用接口。
实践建议
对刚上手的学习者,优先走通云端接入链路:注册认证、创建 API Key、用最小代码验证调用成功。额度监控和「用完即停」应尽早配置,避免调试阶段产生非预期费用。本地部署可作为备选,在需要离线或处理敏感数据时再投入时间。
接入只是起点,RAG 与 Agent 的工程细节——文档切分、向量检索、工具编排——才是决定应用效果的关键。
相关推荐
Gemini 4 Carbon登顶智能指数 谷歌首次开放攻防模型
谷歌Gemini 4 Carbon以59分登顶Artificial Analysis智能指数,网络安全能力首次向防御方开放;OpenAI每月返还最高500美元API额度反击,开源阵营语音、小模型与智能体工程密集迭代。

Gemini 4 Carbon登顶AI基准,成本比榜首低72%
谷歌DeepMind发布Gemini 4 Carbon,在Archital Analysis Intelligence Index B5榜单以59分登顶,Arena文本榜第一1528分,中位任务成本仅80美元,比榜首Cloud Office 1.5低72%。

Gemini 4 Carbon实测:最强AI模型?对比Claude Opus 5.5
谷歌Gemini 4 Carbon发布,Artificial Analysis榜单第一,CW Bench达71%,Vending Bench登顶。实测对比Claude Opus 5.5,前端设计惊艳但Web开发略逊,价格优势明显。