RAG知识库搭建入门:从向量检索到Embedding模型详解
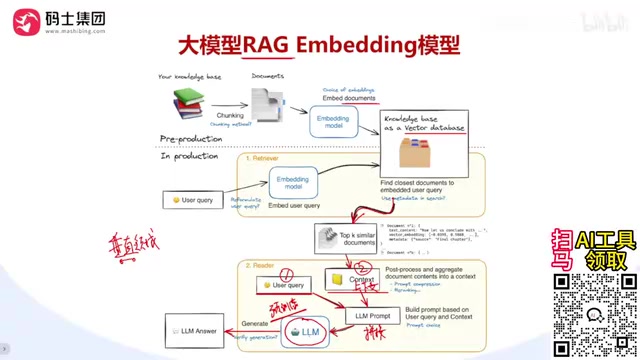
RAG通过在用户提问与大模型之间插入向量检索环节,让模型能够基于私有文档生成准确答案。
RAG(检索增强生成)解决的是大模型预训练知识无法覆盖垂直领域私有内容的根本局限。其核心流程分三步:用户提问经 Embedding 模型转化为向量,系统在预先构建的向量数据库中检索出语义最相关的 top-k 文档片段,再将这些片段与原始问题拼接后交给大模型生成答案。检索质量直接决定最终效果,无关内容反而会干扰模型;Embedding 模型的质量则决定语义匹配的准确性。一个常被忽视的关键细节是:构建知识库与处理用户查询必须使用同一个 Embedding 模型,才能保证历史文档与新问题映射到同一语义空间,相似度计算才有意义。理解这一基础流程,是进入大模型应用开发领域的必要起点。
RAG到底解决了什么问题
检索增强生成(RAG)的核心思路并不复杂:在用户提问与大模型生成答案之间,插入一个「找资料」的环节。系统会从向量数据库中取出与用户问题相关的内容,作为上下文(context)提供给模型,让模型在回答时有据可依。
这个设计解决的是大模型的一个根本局限。我们日常使用的大模型都经过了预训练,吃进了互联网上海量的通用知识,因此对常识性、通用性的问题可以直接给出不错的回答。但预训练数据里往往不包含垂直领域的专业知识——比如某家公司内部的业务定义、技术文档、专有名词。模型从未「见过」这些内容,面对相关提问自然力不从心。
RAG的价值正在于此。通过把企业私有的文档作为参考资料喂给模型,它在生成答案时就有了针对性的依据,回答会明显更准确,尤其是在专业的垂直场景中。
检索流程:从用户提问到上下文拼接
完整的RAG流程可以拆成几个清晰的步骤。用户提出一个问题(user query)后,这个问题首先交给 Embedding 模型,被转换成一个向量(factor向量)。无论用户的提问是几个字还是几百字的详细描述,Embedding 模型都会对这段文本进行「理解」,并输出对应的向量表示。
接下来是关键的检索环节。向量数据库中早已存储了大量由文档切分、向量化后得到的向量。系统拿着用户问题的新向量,去数据库里做相似度计算,取出最相关的前 K 个文档(top-k similar documents)。这一步本质上就是一次查询,把语义上最贴近用户问题的若干片段检索出来。
检索到的内容作为上下文,会与用户的原始提问做整合——可以简单理解为字符串拼接,把问题和参考资料拼成一个更大的输入,再交给大模型生成最终答案。此时模型不仅知道用户问了什么,还掌握了与问题相关的背景知识。
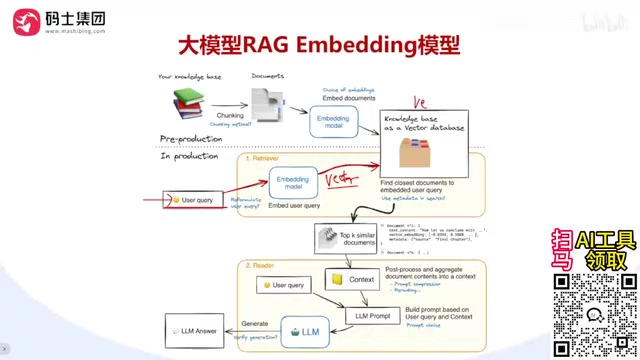
向量数据库的构建(即「准备阶段」)是RAG能够运行的前提。在系统上线之前,需要把所有私有文档切分成较小的片段(chunk),再分别经过 Embedding 模型转换成向量,最终存入向量数据库。切分的粒度会直接影响检索效果:片段太长,向量会混入过多无关语义,降低精准度;片段太短,单个片段承载的信息又不足以回答问题。常见的切分策略有按固定字符数切分、按段落或标题切分,以及带重叠窗口的滑动切分(sliding window),后者可以避免关键信息恰好被切断在片段边界。向量数据库本身(如 Pinecone、Weaviate、Chroma、Milvus 等)会为这些向量建立索引,使得在百万量级的向量中仍能在毫秒级完成近似最近邻(ANN)检索,而不是逐一暴力比对。
为什么上下文的「相关性」至关重要
检索质量直接决定了RAG的效果。如果返回给模型的参考资料与用户提问「八竿子打不着」,不仅帮不上忙,反而会干扰模型生成正确答案。企业往往有大量文章和技术文档,关键在于能否从中精准召回最贴合当前问题的那部分内容。
这也是为什么 Embedding 模型的质量如此重要。它需要确保用户问题的向量,能在向量空间中准确匹配到真正相关的文档向量,而不是把无关内容也拉进来。相似度检索的目标,始终是找到「最贴合」的那一个或那几个片段。
一个容易被忽略的细节:Embedding 模型必须一致
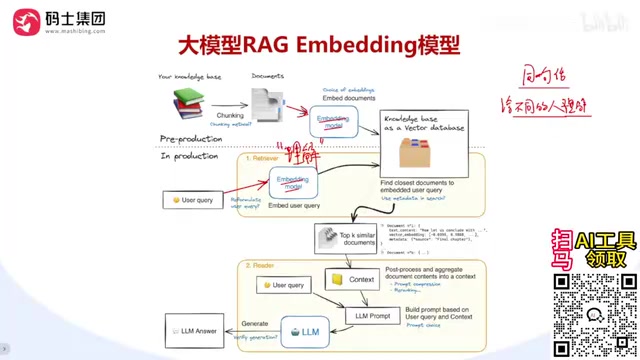
一个常被初学者忽视但极其重要的要点是:准备阶段(pre-production,构建向量库时)和使用阶段(in-production,处理用户新问题时),用的必须是同一个 Embedding 模型。
道理可以用一个生活化的类比来理解。同一句话,一字不差地交给不同的人去理解,结果可能产生偏差甚至歧义。Embedding 模型的本质工作就是「理解」一段文本——理解它在讲什么内容、什么话题。如果构建知识库时用的是一个模型,查询时又换成另一个模型,相当于让两个不同的「理解者」去处理文本,它们映射出的语义空间不一致,相似度计算自然会失真。
正如一位观众在直播中精辟总结的:使用同一个 Embedding 模型,才能让历史文档和新来的用户问题映射到同一个语义空间,之后才能做一致、可靠的相似性计算。
理解 Embedding:把文字「嵌入」高维空间
Embedding 在中文里常被译为「嵌入模型」。所谓嵌入,说白了就是把一段文字或一句话转换成向量。向量是用逗号隔开的一串数值,每个数值代表向量的一个分量。假如一个向量有 7 个分量,就说明它有 7 个维度。
为什么叫「嵌入」?可以这样理解:把这 7 个分量构成的向量放进一个七维空间,它就成为了这个高维空间中的一个点。换句话说,Embedding 的过程就是把一段文本「嵌入」到高维空间,让它成为空间中的一个坐标点。语义相近的文本,在这个空间里的位置也会相互靠近——这正是相似度检索能够成立的几何基础。
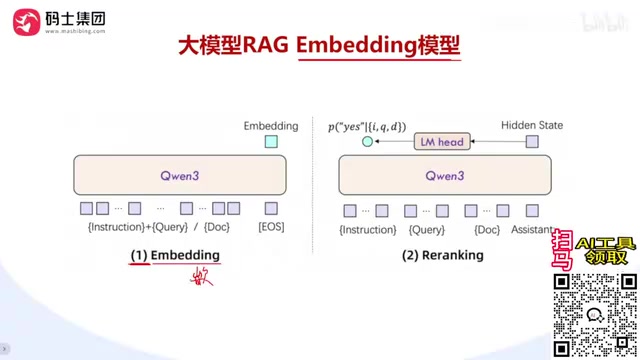
在实际调用 Embedding 模型时,输入可能是历史上切分好的某个文档片段,也可能是用户新传入的 query。有时还会在前面加上 instruction(系统提示词 / 指令),比如「翻译以下内容」这类系统级的指示,用来引导模型的处理方式。
相似度的度量方式决定了「靠近」在数学上的具体含义。最常用的是余弦相似度(cosine similarity):它计算两个向量之间夹角的余弦值,值域为 −1 到 1,越接近 1 表示语义越相近。余弦相似度的优势在于只关注方向而忽略向量长度,因此对文本长短不敏感。除此之外也有欧氏距离(L2 distance)等方案,但在文本语义检索场景中余弦相似度更为主流。值得注意的是,现代 Embedding 模型输出的维度通常远不止 7 维——主流模型往往是 768 维、1536 维甚至更高,高维空间能够编码更细腻的语义差异,但也对存储和计算提出了更高要求。
小结:RAG是大模型应用开发的必备技能
以上流程勾勒的是最基础的RAG思路。在实际的大模型应用开发中,RAG几乎不可或缺,而且正在向多模态方向延伸——带图片、带语音的多模态RAG已经相当常见。对于想从事大模型应用开发的开发者来说,掌握RAG乃至多模态RAG,是一项核心基本功。
理解了 Embedding 模型在流程中出现的两个位置(构建库、处理查询)及其一致性要求,就为后续更深入的话题——比如 Embedding 模型的微调训练——打下了基础。
除了基础的「单轮检索」范式,工程实践中还发展出了若干进阶变体。HyDE(Hypothetical Document Embeddings) 让模型先凭空生成一段「假设性答案」,再用这段答案去做向量检索,以弥补用户提问过于简短导致向量表达不充分的问题。Re-ranking(重排序) 则在 top-k 检索之后增加一个精排步骤,用更强的交叉编码器(cross-encoder)模型对候选片段重新评分,进一步提升送入大模型的上下文质量。多跳检索(Multi-hop RAG) 则针对需要跨多个文档进行推理的复杂问题,通过多轮迭代检索逐步拼凑出完整的答案路径。这些方法都以本文介绍的基础流程为起点,是RAG系统从「能用」走向「好用」的关键工程手段。
相关推荐
Gemini 4 维护 Chromium:两周完成数月代码量
开发者利用 Gemini 4 Argon 维护 Chromium 代码库,两周完成过去数月工作。AI 代理同时发起 20 个变更,全部通过数十万次测试,突破大型代码库的维护瓶颈。
Codex保姆级攻略:从安装到实战,一期精通AI桌面助手
基于B站热门教程,详解Codex从安装到实战的完整流程:与豆包的本质区别、项目概念、文件整理与仪表板生成两大实战案例,以及计划模式和桌面宠物等特色功能,帮你快速上手这款能直接操作电脑的AI助手。
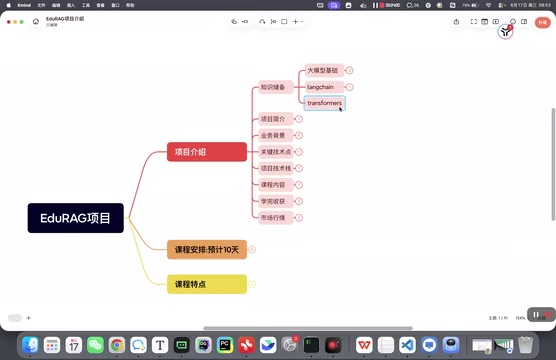
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。