Reflective Recovery:让大模型从错误中学会自我纠错
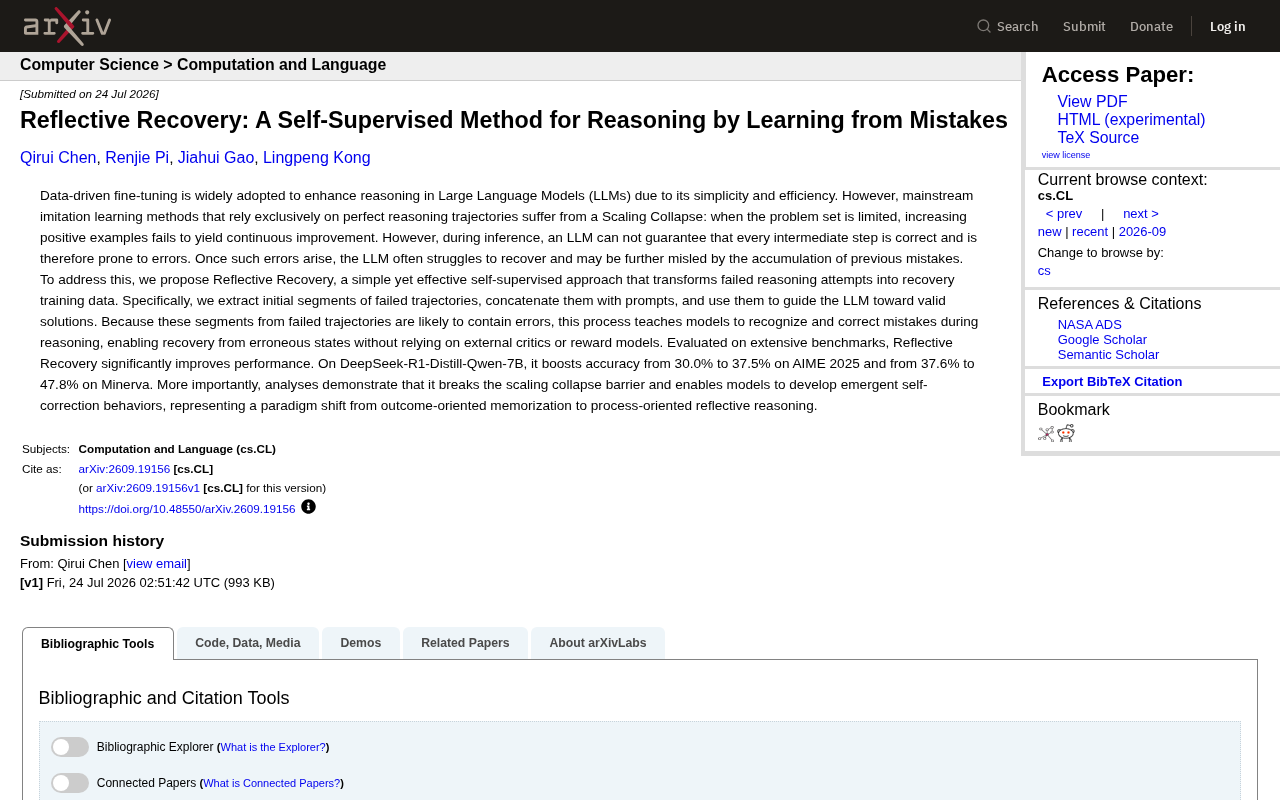
Reflective Recovery将模型失败推理轨迹转化为自监督训练数据,突破模仿学习的Scaling Collapse瓶颈,显著提升LLM推理鲁棒性。
主流LLM推理微调依赖"喂完美推理轨迹"的模仿学习范式,但当训练问题集有限时,堆砌正确示例会遭遇Scaling Collapse——性能边际收益迅速递减。论文提出的Reflective Recovery方法另辟蹊径:提取失败推理的初始片段,将其与提示词拼接后引导模型走向正确解答,迫使模型学会识别并从错误状态中恢复。该方法完全自监督,无需额外的评判模型或强化学习框架。实验中,DeepSeek-R1-Distill-Qwen-7B在AIME 2025和Minerva基准上分别提升7.5和10.2个百分点,且模型出现了涌现式自我纠错行为,标志着从"记忆正确结果"向"理解推理过程中的错误"的范式转变。
数据微调的隐藏瓶颈:Scaling Collapse
通过数据驱动的微调来增强大语言模型(LLM)的推理能力,已经成为业界最常用的手段之一——它简单、高效,只要喂给模型足够多的高质量推理轨迹,模型似乎就能变得更聪明。但这条路径并非没有天花板。
这篇 arXiv 论文(arXiv:2609.19156)指出了一个被称为 Scaling Collapse(规模化崩塌) 的现象:当训练问题集本身有限时,单纯地增加正确的推理示例(positive examples)并不能带来持续的性能提升。换句话说,靠堆砌"完美答案"来教模型推理,很快就会遇到边际收益递减的困境。
主流的模仿学习(imitation learning)方法几乎都建立在"只学习完美推理轨迹"这一假设之上。问题在于,模型在真实推理时根本无法保证每一个中间步骤都正确。一旦出现错误,模型往往难以自我恢复,甚至会被此前累积的错误进一步误导,导致整条推理链彻底走偏。
Scaling Collapse 的本质是一种数据多样性耗尽问题。当训练问题集固定时,模型对这些问题的"正确解法空间"会迅速饱和——继续增加同类正确示例,模型学到的只是对已有模式的重复强化,而非新的推理能力。这一现象与深度学习中更广泛的"数据效率"讨论紧密相关:高质量数据的边际价值随数量增加而递减。与之对应的是,负样本或"失败样本"携带的信息往往未被充分利用——它们揭示了模型在哪些推理节点上容易犯错,具有独特的诊断价值。Scaling Collapse 的存在说明,单靠扩大正确示例的规模并不是提升推理能力的可持续路径,数据的"质"与"多样性"比单纯的量更为关键。
核心思路:把失败的推理变成训练养料
针对上述痛点,作者提出了 Reflective Recovery(反思式恢复),这是一种简单却有效的自监督方法。它的核心逻辑非常直观:与其只用完美答案训练,不如把模型失败的推理尝试转化为"恢复训练数据"。
具体做法分为几步:从失败的推理轨迹中提取出初始片段,将这些片段与提示词(prompts)拼接在一起,再用它们引导模型走向正确的解答。由于这些来自失败轨迹的片段本身很可能包含错误,模型在训练中就被迫学会识别并纠正推理过程中的错误。
这一设计最巧妙的地方在于:它让模型学会从错误状态中恢复,而无需依赖外部的评判模型(critic)或奖励模型(reward model)。整个过程是自监督的,不需要额外的人工标注或复杂的强化学习框架,大大降低了实施成本。
模仿学习(Imitation Learning) 在 LLM 推理微调中的标准做法,是收集由强模型(如 GPT-4、DeepSeek-R1)生成的完整正确推理链,让弱模型从中学习推理风格与步骤结构。这类方法的代表包括 STaR(Self-Taught Reasoner)及各类"蒸馏"方案。其根本局限在于:训练数据中的每个状态都是"成功状态",模型从未见过错误中途如何调整。真实推理时,一旦某步出错,模型缺乏"回头"的经验,只能在错误路径上越走越远。Reflective Recovery 的思路在强化学习领域有其对应概念——类似于利用失败轨迹进行"离轨策略(off-policy)"学习,但其自监督的实现方式避免了完整 RL 框架的复杂性,使其更易于在微调场景中直接落地。
实验效果:显著提升与突破崩塌
论文在多个基准测试上验证了 Reflective Recovery 的效果,成绩相当亮眼。以 DeepSeek-R1-Distill-Qwen-7B 模型为例:
- 在 AIME 2025(数学竞赛级推理)上,准确率从 30.0% 提升至 37.5%;
- 在 Minerva(科学与数学推理基准)上,准确率从 37.6% 大幅提升至 47.8%。
近 10 个百分点的提升,对于一个仅靠重新利用失败数据、不引入外部监督信号的方法而言,是相当可观的。
更重要的是,分析结果表明该方法打破了 Scaling Collapse 的壁垒。这意味着模型不再受限于"正确样本越多、收益越少"的困境,而是能够从错误中持续获取新的学习信号。
从"记忆结果"到"反思过程"的范式转变
Reflective Recovery 的意义不止于分数上的提升。论文观察到,经过这种训练的模型开始展现出涌现式的自我纠错行为(emergent self-correction)——它们能够在推理过程中主动意识到偏差并加以修正,而不是机械地沿着一条错误链条走到底。
作者将这一转变概括为:从 outcome-oriented memorization(面向结果的记忆) 转向 process-oriented reflective reasoning(面向过程的反思式推理)。
这是一个值得关注的方向。传统微调本质上是在让模型"背诵"正确答案的路径,而 Reflective Recovery 则试图让模型理解"哪里会出错、如何回头"。对于追求更强推理鲁棒性的下一代模型来说,这种从过程层面建立纠错能力的思路,可能比单纯扩大高质量数据集更具可持续性。
涌现式自我纠错(Emergent Self-Correction) 是近期 LLM 研究中的热点话题,但争议颇大。此前多项研究(如 Huang et al., 2023)指出,在没有外部反馈的情况下,LLM 的"自我纠错"往往是幻觉——模型会把正确答案改错,或在无实质依据的情况下反复修改。Reflective Recovery 的贡献在于,通过将"错误片段→正确恢复"这一结构显式地编码进训练数据,为模型提供了真实的纠错样本,而非依赖模型在推理时自发产生纠错行为。这使得观察到的自我纠错具有更可靠的训练基础,而非单纯的提示工程效果,也为"如何真正培养模型纠错能力"这一问题提供了一个数据层面的可行答案。
小结
Reflective Recovery 提供了一个反直觉却颇具启发性的视角:模型的失败并非无用数据,恰恰是训练自我纠错能力的宝贵资源。在高质量推理数据日益稀缺、模仿学习触及天花板的当下,如何更充分地利用"不完美"的推理轨迹,或许是提升 LLM 推理能力的一条重要路径。当然,这项工作目前仍是学术预印本,其在更大规模模型与更广泛任务上的泛化能力,仍有待后续研究验证。
相关推荐
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。
Vercel首席软件官复盘:智能体构建从多智能体到文件系统的进化
Vercel首席软件官Andrew在AI Engineer大会复盘智能体构建历程:从巨型提示词到多智能体链、单体记忆管理,再到受Cloud Code启发的文件系统智能体,最终催生开源框架EVE。深度解析智能体架构演进与垂直智能体的核心壁垒。
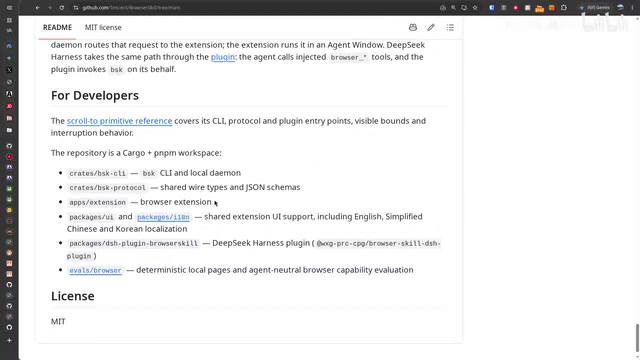
腾讯开源 BSK 实测:让 AI 接管你已登录的浏览器
腾讯开源 BSK(Browser Skill Kit)实测:让 AI 直接接管已登录的真实 Chrome 浏览器,通过 WebSocket 实现远程指挥。本文解析其架构原理、安装方式,以及插件版本、新窗口复用、验证码人机接管三大实操要点。