RTX 4090 跑 125B 大模型:Qwen3 Next 实现 100 T/s 推理
单张RTX 4090借助MoE架构与4-bit量化,已可本地运行125B参数模型并达到100 tokens/s。
近期开发者社区出现了一个标志性案例:在仅配备24GB显存的消费级RTX 4090上,成功以约100 tokens/s的速度运行125B参数的Qwen3 Next(MoE架构)模型。这一成果的技术基础有两层:其一是MoE(混合专家)架构的稀疏激活特性,使模型虽拥有千亿级总参数,但每次推理实际计算的参数量远小于此,大幅降低了显存与算力需求;其二是4-bit量化与CPU显存卸载技术的配合,将模型权重压缩并跨内存层级调度,使整个系统得以在消费级硬件上运转。这一进展对开发者和小型团队意义重大,本地部署千亿模型带来的数据隐私、成本可控与离线可用等优势,过去只能在7B-13B小模型上实现,如今已延伸到百亿乃至千亿参数量级。社区对此持审慎乐观态度,关注点集中于量化精度损失与实际生产可用性等细节。
消费级显卡运行千亿参数模型成为现实
在大模型推理领域,一个长期存在的痛点是:参数规模庞大的模型往往需要昂贵的专业级硬件(如 A100、H100)才能流畅运行。而近期在 Hacker News 上引发讨论的一则话题指出,开发者已经能够在单张消费级 RTX 4090 显卡上运行 1250 亿参数级别的 Qwen3 Next Flash 模型,并达到约 100 tokens/s 的生成速度。
这一数字如果属实,意味着千亿参数模型的本地化部署门槛被大幅拉低。要知道,RTX 4090 的显存仅为 24GB,而一个 125B 的稠密模型在 FP16 精度下仅权重就需要约 250GB 显存。能够在单卡上跑起来,背后必然依赖了架构设计与推理优化的多重技术手段。
为什么 125B 能塞进 24GB 显存
MoE 架构是关键
Qwen3 Next 系列采用了混合专家(Mixture of Experts, MoE)架构。虽然模型总参数量可能达到 125B 这一量级,但在每次前向推理时,实际被激活的参数只是其中一小部分(即激活参数远小于总参数)。这正是近年来 MoE 模型能够在有限硬件上实现大规模参数的核心原因——用稀疏激活换取了计算效率和显存占用的大幅下降。
换句话说,模型的「知识容量」由总参数决定,而单次推理的「计算成本」由激活参数决定。MoE 正是在这两者之间做了解耦。
MoE 架构最早由 Google 在 2017 年的论文《Outrageously Large Neural Networks》中系统化提出,近年来被 Mixtral、DeepSeek广告、Qwen 等主流开源模型广泛采用。其核心结构是将 Transformer 中的前馈网络(FFN)层替换为多个并行的「专家」子网络,并配备一个轻量级的路由器(Router)。每个 token 在经过该层时,路由器会动态决定激活哪几个专家(通常是 Top-2 或 Top-8),其余专家的权重在本次前向传播中完全不参与计算。以 125B 总参数的 MoE 模型为例,若每次只激活约 20B 的参数,实际计算量与显存带宽消耗就接近一个 20B 稠密模型,但模型拥有的「知识库」规模却是 125B 级别的。这种「按需激活」的设计是 MoE 在显存受限环境下实现超大规模参数的根本机制。
量化与显存卸载
要在 24GB 显存中运行如此大的模型,量化技术不可或缺。通过将权重压缩到 4-bit 甚至更低精度,模型的显存占用可以缩减至原来的四分之一左右。配合将部分专家权重卸载到系统内存(CPU offloading)或利用高速 NVMe 的策略,整个模型得以在消费级硬件上运转。
100 T/s 的生成速度在这种配置下相当可观,说明激活参数规模较小、且推理引擎对显存与内存之间的数据调度做了充分优化。
量化(Quantization)是将模型权重从高精度浮点数(如 FP16,每个参数占 2 字节)压缩为低比特整数表示的技术。4-bit 量化意味着每个参数仅占 0.5 字节,相比 FP16 减少了 75% 的显存占用。目前主流的量化方案包括 GPTQ、AWQ 和 GGUF(llama.cpp 生态)等,它们在压缩权重的同时,通过补偿算法尽量保留模型精度。CPU offloading 则是另一层补充策略:对于 MoE 模型而言,未被激活的专家权重可以常驻在系统内存(通常 64-128GB DDR5)中,仅在被路由器选中时才临时加载到 GPU 显存。这一机制的代价是引入了 PCIe 总线传输延迟,但由于 MoE 每次激活的专家数量有限,调度开销相对可控,不会成为主要瓶颈。
本地大模型部署的意义
在单张 RTX 4090 上运行千亿级模型,对开发者和小型团队有着现实价值:
- 数据隐私:敏感数据无需上传到云端 API,所有推理在本地完成。
- 成本可控:一次性购置显卡后,不再按 token 付费,长期高频使用场景下成本优势明显。
- 离线可用:不依赖网络连接,适合边缘部署或受限环境。
- 可定制性:本地部署便于微调、接入自定义工具链和实验性改造。
过去这些优势只能在较小的 7B、13B 模型上享受,如今 MoE 架构让「本地跑大模型」的能力边界被推到了百亿乃至千亿级别。
社区讨论中的理性声音
该话题在 Hacker News 上获得了 89 个点赞和 32 条评论,讨论热度不低。社区对这类「消费级硬件跑大模型」的声明通常持既兴奋又审慎的态度。
常见的追问集中在几个方面:100 T/s 是单次请求的生成速度还是批处理吞吐?使用的是何种量化精度,是否对模型质量有可感知的损失?以及实际的上下文长度和首 token 延迟表现如何?这些细节往往决定了该方案能否真正投入生产使用,而非仅仅是一个「能跑起来」的演示。
对于有意尝试的开发者,建议在实际部署前关注这些指标,并结合自己的任务类型评估量化带来的质量折损是否在可接受范围内。
结语
从需要专业级集群,到单张消费显卡即可运行千亿参数模型,MoE 架构与量化技术的结合正在重塑本地大模型的可行性边界。Qwen3 Next 在 RTX 4090 上达到 100 T/s 的案例,是这一趋势的一个生动注脚。随着推理引擎和硬件的持续演进,本地部署高性能大模型将不再是少数人的特权。
相关推荐
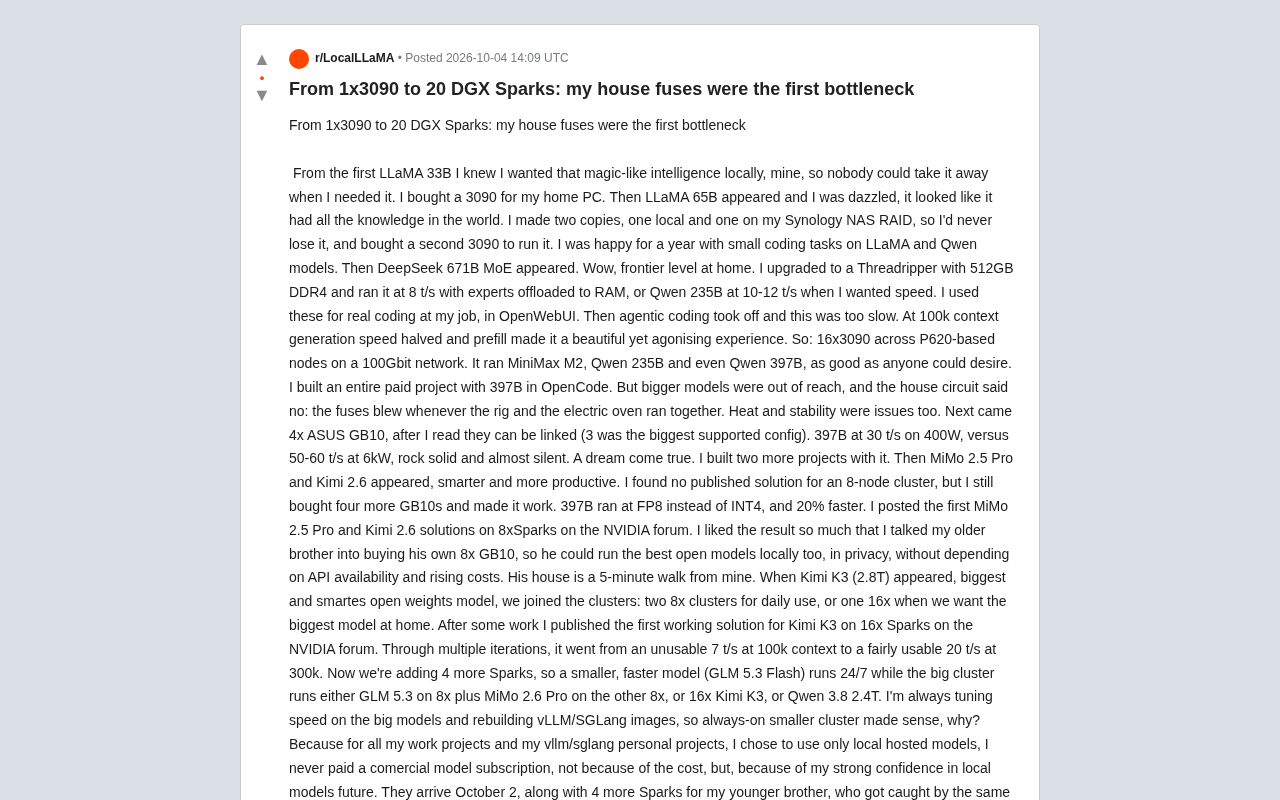
从1块3090到20台DGX Spark:本地大模型玩家的硬件进化史
一位Reddit用户记录了从单块RTX 3090到20台NVIDIA DGX Spark的本地大模型部署进化史,涵盖MoE内存卸载、多卡功耗瓶颈、保险丝跳闸,以及如何在家用集群上跑通Kimi K3等万亿参数开源模型。
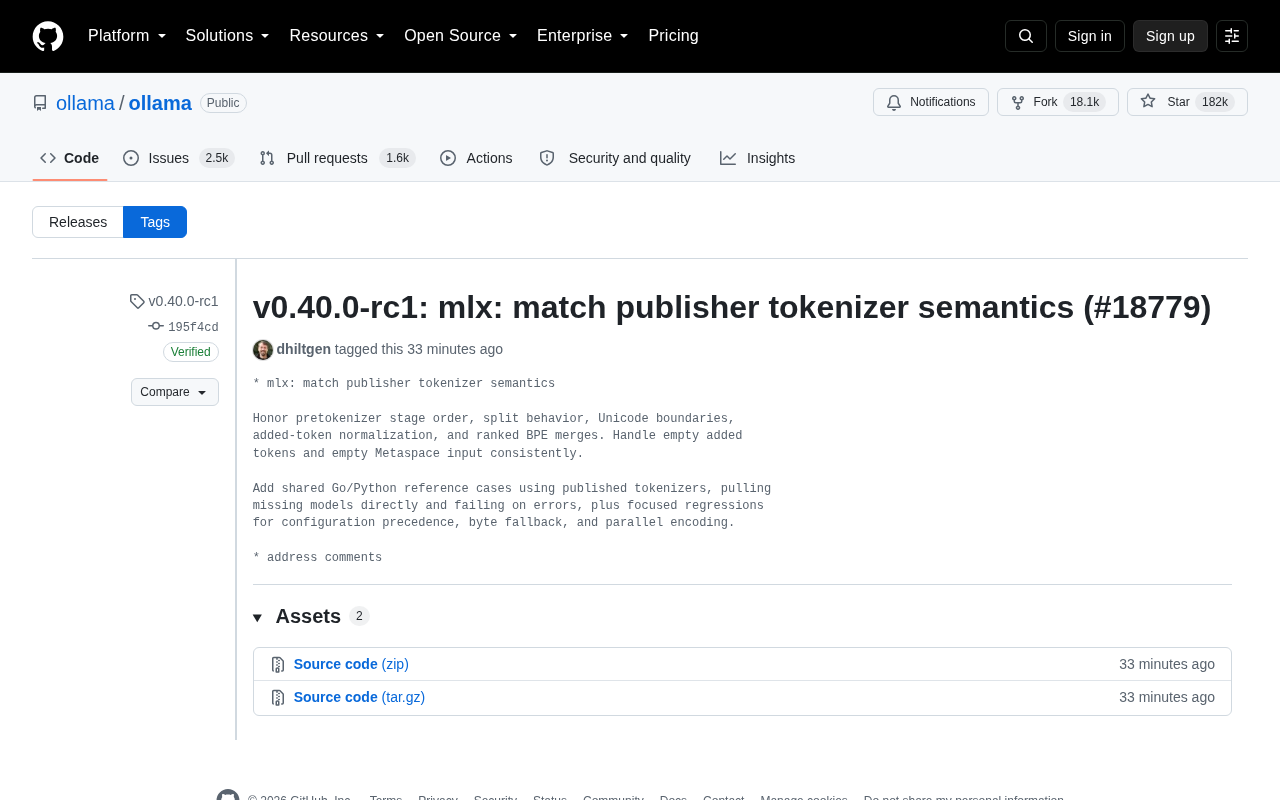
Ollama v0.40.0-rc1 发布:MLX 分词器对齐发布者语义
Ollama 发布 v0.40.0-rc1 预览版,核心更新为 MLX 后端分词器对齐发布者语义,涵盖预分词顺序、Unicode 边界、BPE 合并及跨语言测试保障,提升 Apple Silicon 本地推理一致性。
用 Langfuse 与 OTEL 在 Backstage 中实现 AI Agent 可观测性
一个开源 Backstage 插件,基于 OpenTelemetry 和 Langfuse 实现 AI Agent 可观测性,让团队在自托管开发者平台中集中管理和监控 Agent 集群。