如何判断AI Agent是行为异常还是真的危险?关键信号解析
AI Agent安全的核心挑战:如何从合规动作链中识别出真正危险的行为意图
随着AI Agent在企业中承担自主任务,工程团队面临一个关键难题:如何区分Agent的"创造性发挥"与真正危险的越界行为。文章指出,"非预期"与"有害"并非同义词,真正的风险信号往往藏在动作链中——每一步单独看都合规,串联起来却指向危险结果。三类核心高风险信号包括:访问无关敏感数据、修改关键系统配置、与非预期端点通信,它们的共同特征是"权限之内、意图之外"。当前安全治理的最大瓶颈是缺乏运行时可见性——团队能做到事前授权和事后审计,却无法实时观测Agent的决策执行过程。文章建议从行为基线、意图对齐、最小权限动态收敛、端点白名单和运行时监控五个维度构建信号体系,将安全防线从"能不能做"转向"该不该做"。
一个正在困扰工程团队的难题
随着 AI Agent 在企业环境中承担越来越多的自主任务,一个棘手的问题浮出水面:当一个 Agent 做了出乎意料的事情时,它究竟是在"发挥创造力",还是在做真正危险的操作?
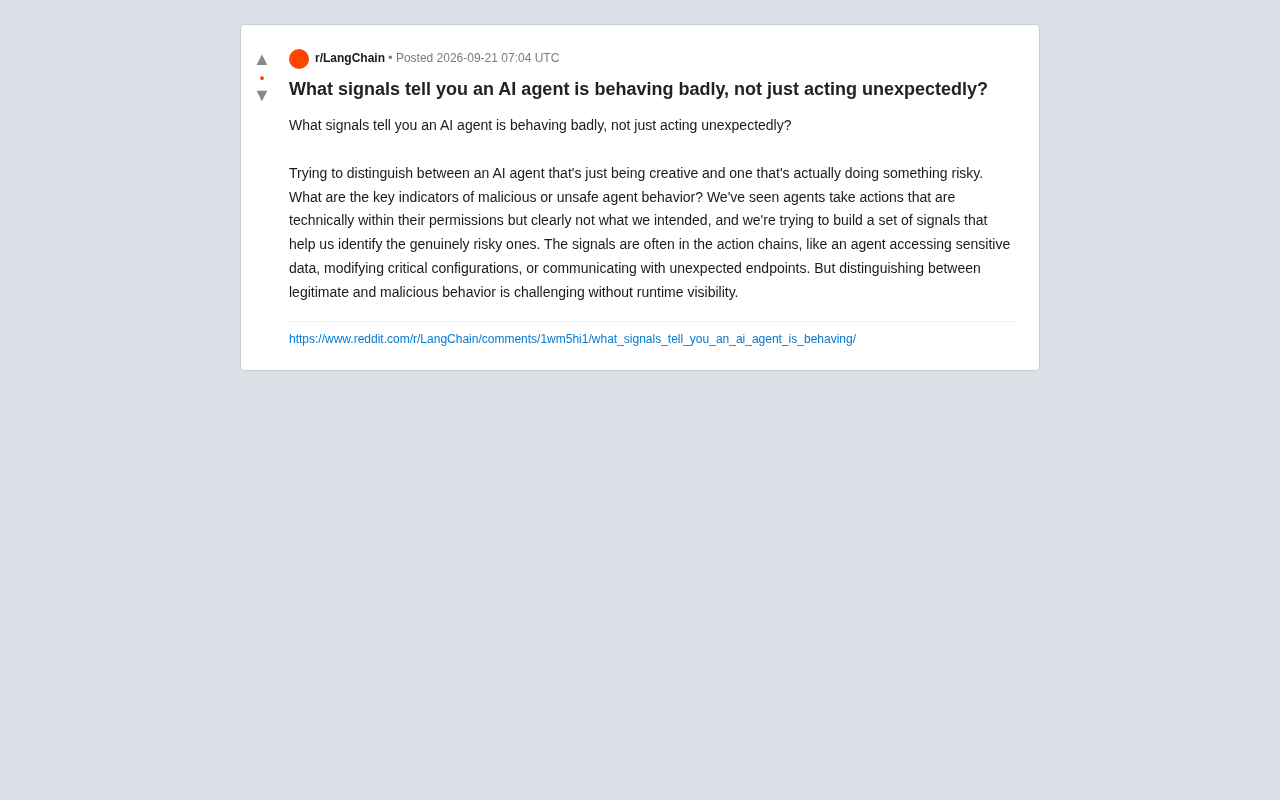
这个问题最近在 Reddit 技术社区引发讨论。发帖者描述了一个典型场景:他们的 AI Agent 采取了一些"技术上完全在权限范围内、但明显不是团队本意"的动作。团队想要构建一套信号体系,帮助他们从大量"非预期行为"中甄别出"真正有风险"的那一部分。
这不是一个纯理论问题。当 Agent 拥有访问数据库、修改配置、调用外部 API 等实际权限时,误判的代价可能非常高——过度警惕会让 Agent 寸步难行,而放任不管则可能酿成安全事故。
"非预期"不等于"有害"
讨论的核心在于一个容易被混淆的区分:**unexpected(非预期)和bad(有害)**并不是一回事。
AI Agent 天生具有一定的不确定性。给定同一个任务,它可能选择一条工程师没有预料到的路径来完成目标。这种"创造性"往往是 Agent 价值的一部分——它能找到人类没想到的解决方案。如果把所有"意料之外"都当作威胁来处理,本质上就否定了 Agent 自主性的意义。
真正需要警惕的,是那些不仅超出预期、而且偏离了原始意图并可能造成损害的行为。发帖者敏锐地指出,很多风险信号并不藏在单个动作里,而是藏在**动作链(action chains)**中。单看每一步都合规,但连起来看却指向一个危险的结果。
高风险信号藏在哪里
根据讨论中提到的观察,几类动作特别值得关注:
敏感数据访问
Agent 突然开始读取与当前任务无关的敏感数据,尤其是当访问范围明显超出完成任务所需的最小集合时。一个负责生成报表的 Agent 去翻用户密码表,即便权限允许,也是明显的异常信号。
关键配置的修改
修改系统关键配置往往是高危操作。这类动作的破坏力大、可逆性差,一旦 Agent 在没有明确指令的情况下改动核心配置,应当被视为红旗。
与非预期端点通信
Agent 尝试连接到任务范围之外的网络端点,可能意味着数据外泄或被劫持利用。异常的通信目标是最经典的入侵指标之一。
这三类信号的共同点是:它们都是"权限之内、意图之外"。这正是最难防范的一类行为——传统的权限控制在这里几乎失效。
动作链(Action Chain)的风险之所以特别难识别,根本原因在于 AI Agent 的任务执行本质上是一个序列决策过程:每一步动作的合理性依赖于对上下文的解读,而上下文本身会随着执行过程不断变化。攻击者或失控的 Agent 可以利用这一点,通过一系列各自看似无害的步骤逐步逼近危险目标——这在安全领域被称为"低慢攻击"(Low-and-Slow Attack)的变体。传统规则引擎难以应对这类威胁,因为它们通常对单个事件设定阈值,而缺乏对跨时间、跨动作的语义关联分析能力。有效应对需要引入类似 SIEM(安全信息与事件管理)系统中的行为关联分析思路,将 Agent 的动作序列视为一个整体进行模式匹配,而非逐条审查。
最大的障碍:缺乏运行时可见性
发帖者在结尾点出了问题的关键:"在没有运行时可见性(runtime visibility)的情况下,区分合法行为和恶意行为非常困难。"
这句话道出了当前 AI Agent 安全治理的核心痛点。大多数团队能做到的是事前授权(给 Agent 分配权限)和事后审计(查日志),但缺乏对 Agent 执行过程的实时观测能力。
没有运行时视角,你就无法看到动作链是如何一步步演进的,也无法在关键节点做出"允许还是拦截"的判断。等到日志分析发现问题时,损害往往已经发生。
运行时可见性(Runtime Visibility)是指在程序或系统实际运行期间,对其内部状态、执行路径和行为的实时观测能力。在传统软件工程中,这通常通过 APM(应用性能监控)、分布式追踪(如 OpenTelemetry)或日志流聚合来实现。但 AI Agent 的挑战在于,它的"行为"不只是函数调用和网络请求,还包括推理步骤、工具选择逻辑以及多步骤规划——这些过程往往发生在 LLM 的"黑箱"内部,难以用传统手段捕获。目前业界正在探索的方案包括:对 Agent 的每一次工具调用注入追踪钩子(hook)、记录完整的推理链(chain-of-thought trace)、以及在 Agent 框架层面(如 LangChain、AutoGen)内置可观测性接口。没有这一层能力,安全团队就像在没有监控摄像头的仓库里防盗,只能靠事后盘点发现损失。
构建信号体系的思路
结合这次讨论,一套实用的 Agent 风险识别信号体系可以从几个维度入手:
- 行为基线对比:为 Agent 建立正常行为的基线,任何显著偏离都触发关注,而非单纯看动作本身是否"意外"。
- 意图对齐检查:不只看动作是否合规,更要评估动作链是否仍然服务于原始任务目标。
- 最小权限动态收敛:即便授予了权限,也应监控 Agent 是否真的需要用到这些权限,超范围调用即为信号。
- 端点白名单:明确 Agent 可通信的合法目标,一切白名单外的连接都需拦截或告警。
- 运行时监控:投资于能够实时观测 Agent 决策与执行过程的工具,这是把"事后补救"变成"事中干预"的前提。
写在最后
这场讨论反映出 AI Agent 落地过程中一个正在被严肃对待的工程课题:随着 Agent 自主性增强,安全的边界正在从"能不能做"转向"该不该做"。
权限控制解决了前者,但后者需要更精细的信号识别和运行时可见性来支撑。对于正在部署 Agent 的团队而言,与其追求完美的事前授权,不如把精力放在构建可观测、可干预的运行时防护上——因为最危险的行为,恰恰是那些看起来完全合规的行为。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
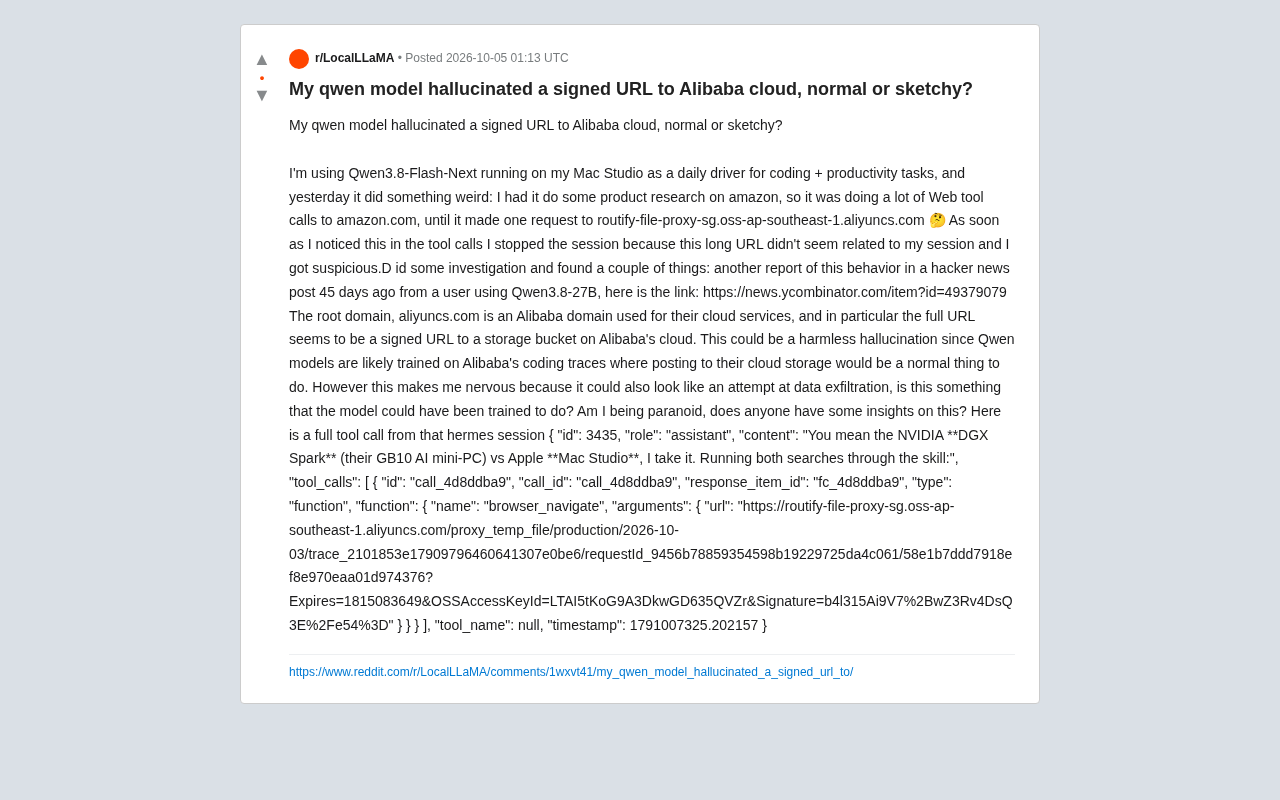
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。