如何判断AI模型是否真的"无审查"?社区争议引发思考
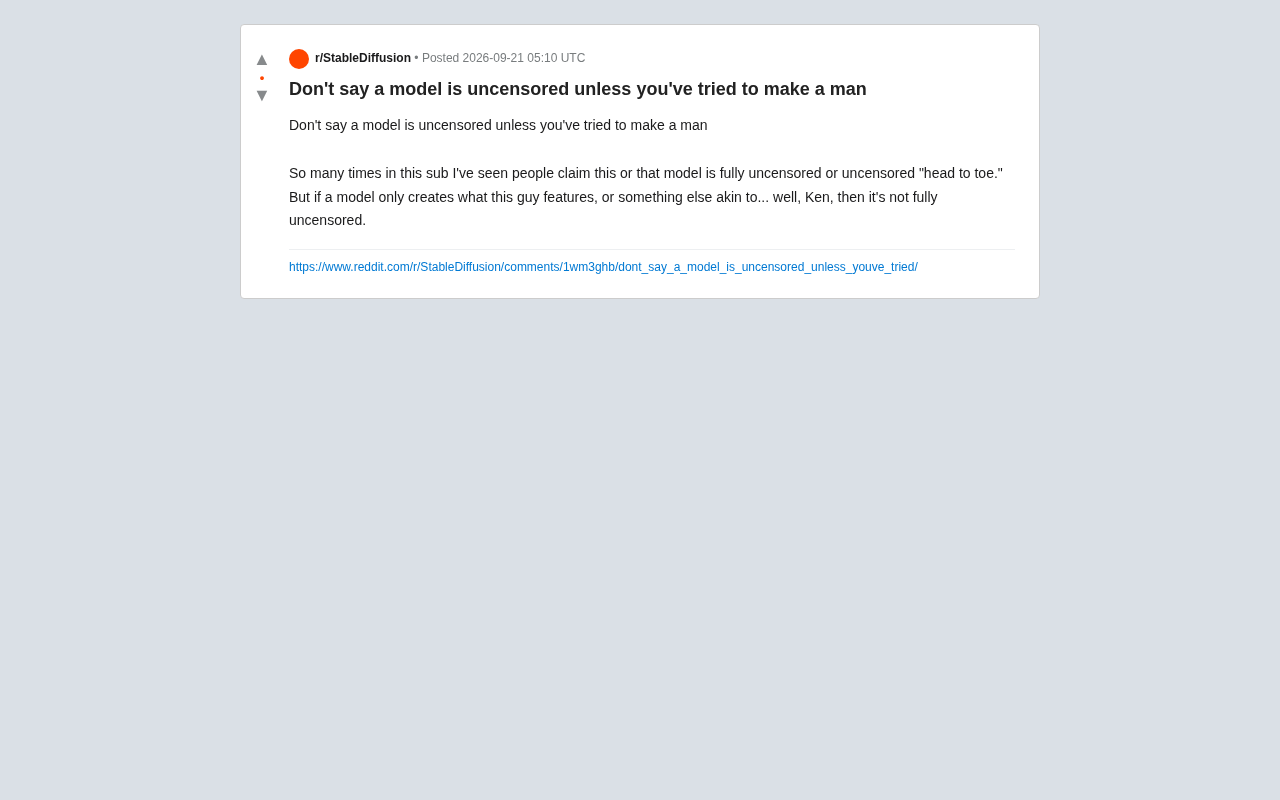
社区滥用"无审查"标签,训练数据偏差才是真正限制AI图像生成多样性的隐形枷锁。
在AI图像生成社区,"无审查"已成为评价模型的高频标签,但这一标签缺乏严格的验证标准。一条Reddit帖子以"能否生成多样化男性形象"为切入点,指出真正的无限制生成应覆盖完整的人物、风格与场景光谱,而非仅仅能生成某类敏感内容。文章进一步从技术层面剖析:许多模型的生成局限并非来自显式的内容过滤规则,而是训练数据分布不均导致的隐性能力边界——这种"隐性审查"无法通过常规的去审查微调消除。对此,文章建议社区成员用多样化测试用例全面考察模型边界,而非轻信宣传标签。
一个被反复讨论的判断标准
在AI生成模型的社区里,"无审查"(uncensored)几乎成了衡量一个模型能力的高频词。有用户在Reddit上发帖指出,社区里频繁出现"某某模型完全无审查""从头到脚无审查"这样的断言,但这些说法往往缺乏严格的验证标准。
发帖者提出了一个颇具讽刺意味的检验方法:如果一个模型只能生成某些特定类型的内容,或者生成的男性形象千篇一律、缺乏多样性(帖子中调侃为"Ken"式的样板形象),那它其实算不上"完全无审查"。
"无审查"到底意味着什么
这条帖子看似戏谑,实际上触及了AI图像生成领域一个长期存在的模糊地带。当人们说一个模型"无审查"时,通常指的是它不会拒绝生成某些敏感或成人内容。但这种描述往往只从单一维度出发——即模型是否愿意生成特定题材。
真正意义上的"无限制"应当涵盖更广的生成能力:模型能否处理多样化的人物形象、不同的身体特征、各种场景与风格?如果一个模型在某类内容上表现开放,却在其他类型的生成上高度同质化、缺乏细节,那么它的"自由度"其实是不完整的。
发帖者的核心观点在于:判断模型是否无审查,不应只看它能生成什么"敏感"内容,而要看它能否覆盖完整的生成光谱。
在开源AI社区(尤其是Civitai、Hugging Face等平台)的语境中,"无审查"一词的含义经历了一定的语义漂移。早期它主要用于描述语言模型移除了RLHF(基于人类反馈的强化学习)阶段引入的内容拒绝行为;后来被借用到图像生成领域,通常指模型未加载或已绕过NSFW安全检查器(Safety Checker)。然而,这两种"无审查"的技术路径截然不同,前者涉及模型行为层面的对齐策略,后者仅仅是推理管线中一个后处理过滤步骤的开关。将两者混用,容易让用户对模型的实际能力边界产生误判,以为关掉安全过滤器就等于获得了一个"全能"的生成模型。
训练数据偏差才是隐形的"审查"
从技术角度看,这个现象背后其实是训练数据分布不均的问题。许多生成模型在特定类型的图像上训练数据丰富,因此生成质量高、变化多;而在其他类型上数据稀缺,导致输出趋于模板化。
这种由数据分布造成的能力局限,本质上是一种"隐性审查"——它不是通过规则或过滤器实现的,而是模型能力边界的自然结果。用户可能误以为模型"愿意生成"就等于"能生成好",但两者是不同的概念。
因此,评估一个模型的开放程度,需要用更全面的测试用例去探索它的边界,而不是仅凭几次特定尝试就下结论。
在图像生成模型的训练实践中,数据分布不均的问题尤为突出。以主流的扩散模型(Diffusion Model)为例,模型通过海量图文对学习"文本提示→图像"的映射关系。若训练集中某类形象(如特定体型、种族、姿态)的样本占比极低,模型在推理阶段便会频繁"退回"到它最熟悉的分布中心,输出趋同的模板化结果,即使用户的提示词明确要求多样化也难以突破。这与显式的内容过滤规则(如NSFW过滤器)有本质区别:后者是人为添加的拒绝逻辑,可以被微调或绕过;而前者是模型权重本身编码的能力上限,无法仅靠调整提示词来弥补。社区中流行的"去审查微调"(uncensored fine-tune)通常只针对前者,移除了安全限制层,却对训练数据造成的隐性偏差毫无作用,这正是许多被标榜为"完全无审查"的模型依然输出单一化内容的根本原因。
对社区讨论的启示
这条帖子提醒社区成员在评价模型时保持更严谨的态度。"无审查"是一个容易被滥用的标签,缺乏统一标准时,不同用户基于各自有限的测试就会得出截然不同的结论。
对于关注AI生成模型的用户而言,与其轻信"完全无审查"的宣传,不如自己设计多样化的测试场景,全面考察模型在人物、风格、构图等多个维度上的实际表现。只有经过充分测试,才能对一个模型的真实能力做出可靠判断。
相关推荐
高关税为何拆不散中国制造供应链?几颗螺丝的启示
高关税推动跨国企业外迁东南亚,为何两年后订单又流回中国?本文借鲍德温全球化理论,解析供应链集群、协调成本与比较优势去国家化,揭示中国制造真正难以复制的协作网络。
ClickFix新型攻击警报:没下载文件电脑也被黑
8月网络攻击手法盘点:ClickFix假人机验证让你无需下载文件即被黑,Sorry勒索病毒瞄准公网服务器,供应链失守致数据外泄,NASA软件现高危漏洞,木马仍占新增病毒七成。
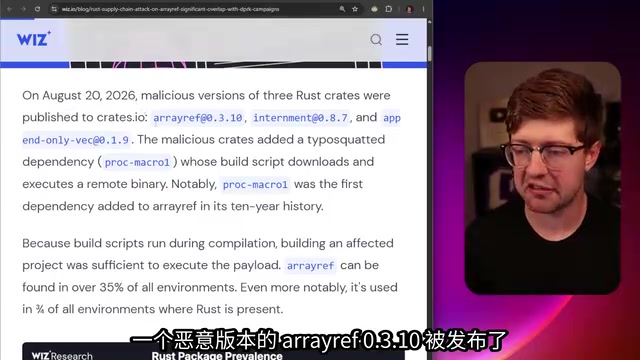
Rust也救不了:Cargo供应链攻击深度解析
Rust 语言解决了内存安全,却挡不住供应链攻击。本文深度解析 RayRef Cargo 恶意包事件:拼写抢注 ProcMacro1、build.rs 编译时后门、与朝鲜攻击基础设施重合,以及 Rust 开发者的防范建议。