RubyGems供应链安全争议:开源治理与商业利益的碰撞
RubyGems供应链安全与OpenAI介入开源治理引发社区对控制权和透明度的隐忧
一则将RubyGems与OpenAI并置讨论的Hacker News帖子,触发了对开源供应链安全这一系统性议题的关注。文章指出,现代软件高度依赖第三方开源包构成的"依赖树",一旦基础包被植入恶意代码或维护者账号遭劫持,攻击会沿依赖链自动扩散至数万个下游项目。RubyGems作为Ruby生态的集中式分发平台,其治理机制与安全响应能力直接关乎整个Ruby社区的健康。与此同时,大型商业机构(如OpenAI)深度介入开源基础设施,虽能带来资金与安全审计资源,却也引发社区对控制权和决策透明度的担忧。文章建议开发者建立依赖审查习惯、使用锁定文件与SBOM等自动化工具,并持续关注所在生态系统的治理结构变化,以在效率、安全与社区自治之间维持平衡。
事件概览
一则关于 RubyGems 开源软件供应链安全与 OpenAI 的讨论近日登上 Hacker News,虽然帖子本身热度有限(10 分、3 条评论),但触及了一个正在被广泛关注的话题:开源生态系统的供应链安全,以及大型商业机构在其中扮演的角色。
RubyGems 是 Ruby 语言的官方包管理器与分发平台,承载着整个 Ruby 生态的第三方依赖。任何针对包管理平台的安全隐患,都可能沿着依赖链向下游成千上万的项目扩散,这正是「供应链攻击」令人担忧的原因所在。
说明:由于原始素材仅提供了标题与极少量的讨论信息,本文围绕该话题的技术背景与行业意义展开分析,具体细节以官方与权威来源为准。
为什么开源供应链安全如此关键
现代软件几乎没有从零构建的项目。一个普通的 Web 应用可能依赖数百个开源包,而这些包又各自依赖更多的间接依赖。这种「依赖树」结构带来了开发效率的飞跃,也埋下了系统性风险。
攻击面的放大效应
当一个被广泛使用的基础包被植入恶意代码,或其维护者账号被劫持,攻击就会自动向所有依赖它的项目传播。历史上 npm、PyPI 等生态都发生过类似事件——一个看似不起眼的包,可能被数以万计的项目间接引用。
信任链的脆弱性
包管理平台的安全依赖于多个环节:维护者身份验证、包发布流程、版本完整性校验,以及平台自身的基础设施安全。任何一环出现漏洞,都可能被攻击者利用。RubyGems 作为集中式分发平台,其治理机制和安全响应能力直接关系到整个 Ruby 社区。
OpenAI 与开源治理的交集
该讨论将 OpenAI 与 RubyGems 供应链安全并置,反映出一个更深层的行业议题:当商业机构深度介入开源基础设施时,社区治理与商业利益之间可能产生张力。
大型科技公司越来越多地资助、参与甚至主导关键开源项目的维护。这一方面为长期缺乏资源的开源项目注入了资金与人力,另一方面也引发了关于控制权、决策透明度和社区自治的争论。开源项目的核心价值在于其开放与去中心化,而商业力量的介入需要在这种价值与可持续性之间找到平衡。
对于供应链安全而言,商业机构的参与既可能是助力——带来更专业的安全审计和基础设施投入;也可能带来新的信任问题——社区需要确认这些参与不会以牺牲透明度为代价。
对开发者的启示
无论具体事件如何演进,供应链安全都是每一位使用开源依赖的开发者需要正视的问题。
建立依赖审查习惯
引入新依赖前,评估其维护活跃度、社区规模与安全记录。使用锁定文件(如 Gemfile.lock)确保构建的可复现性,避免依赖版本被意外篡改。
借助自动化工具
利用依赖扫描工具、软件物料清单(SBOM)以及签名验证机制,及时发现已知漏洞与异常变更。持续监控依赖更新,而不是被动等待问题爆发。
关注平台治理动向
开发者应当留意所依赖生态系统的治理结构变化,理解谁在维护、谁在资助关键基础设施,从而更全面地评估长期风险。
结语
这则讨论虽小,却是当下开源世界普遍焦虑的缩影:在软件供应链日益复杂、商业与社区界限逐渐模糊的背景下,如何保障关键基础设施的安全与中立,是整个行业需要共同回答的问题。开源的力量来自协作与开放,而它的韧性,则取决于社区能否在效率、安全与自治之间维持平衡。
相关推荐
Gemini 4 Neon实测:半价挑战Opus 5.5,谁更强?
基于多位开发者实测与第三方基准,解析Gemini 4 Neon与Claude Opus 5.5的真实差距:智能指数、编程能力、每任务成本与适用场景,揭示半价说法的真相。
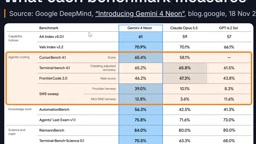
Gemini 4 Neon基准全解读:与Opus、ChatGPT 6.2硬碰硬
逐项拆解 Gemini 4 Neon 官方基准表:整体略胜 Opus 与 ChatGPT 6.2,终端任务反落后 0.5,长上下文区间优势明显,成本与速度三项全赢。附 Carbon/Neon/Hydrogen 三型号定位与按任务选型建议。
Gemini 4 Neon编程测试39%与12.8%之谜:工具差异还是模型实力?
Gemini 4 Neon在SWE-bench上出现39%与12.8%两个分数,与GPT-6.2 Sol的差距从30.7个百分点缩至1.2。本文解析代理工具差异如何影响编程基准得分,并给出受控测试建议。