树莓派5实测8款本地大模型:仅3款真正可用
树莓派5实测8款本地LLM,仅Gemma 2B、Gemma 4B、Granite通过速度与任务双重筛选。
本文记录了一次在8GB内存树莓派5上运行8款小型本地大语言模型的系统评测。评测设立了两套客观门槛:聊天场景要求每秒至少5个token且10秒内首响,后台场景则要求通过全部四项实用任务(摘要、文件分类、JSON转换、工具调用)并稳定运行半小时。结果只有Gemma 2B、Gemma 4B和Granite三款模型通过了全部任务,其中Gemma 2B兼顾速度与准确性,被选为单机首选。评测还发现了两个反直觉结论:使用两个CPU线程比四个快18%-38%(因生成受限于内存带宽而非算力),以及摘要是小模型最易出错的任务类型,4款模型出现编造或遗漏。这套「速度门槛+任务验证+场景分类」的筛选框架,比单纯看参数量更具实用指导价值。
在边缘设备上运行大语言模型已经不再是幻想。配备8GB内存的树莓派5确实能物理运行多款小型本地模型——但「能运行」和「真正可用」是两回事。有博主在树莓派5上实测了8款热门本地模型,用客观的速度和任务完成度标准做了筛选,结果只有3款真正通过了考验。
什么才算「可用」
评测没有依赖主观感受,而是设立了两套客观标准。对于聊天场景,模型的生成速度必须达到至少每秒5个令牌(token),这大致是人类能舒适阅读回复的最低速度;同时,它开始回答短问题的响应时间应控制在10秒以内。
对于后台任务,速度不再是关键,但模型必须通过全部测试任务,并且能连续运行半小时而不导致树莓派过热或降频。如果一个模型既不能满足聊天标准、又无法胜任后台工作,那就被判定为「在树莓派上不可用」。
硬件配置是一台8GB内存、带主动散热器和双固态硬盘的树莓派5:系统装在第一块SSD上并从它启动,模型存放在第二块SSD。所有模型通过 llama.cpp 运行(即 LM Studio 和 Ollama 底层所用的同一引擎),用 llama-bench 测量提示处理速度和响应生成速度。除特例外,所有模型统一采用 Q4_K_M 四比特量化。
参赛的8款模型
参赛阵容按模型文件大小排序,参数范围跨度很大,从不足10亿参数的微型模型一直到80亿参数,几乎都是近期发布的热门小模型。
其中两款比较特殊。一款是 Bonsai,虽然有较多参数,但每个权重只有1比特,整个模型文件仅略多于1GB。另一款是 LFM2.5,它拥有列表中最大的文件,但得益于混合专家(MoE)架构,生成每个令牌时只激活约15亿参数,因此能保持相对较快的速度。
Q4_K_M 四比特量化是一种将模型权重从原始的16位或32位浮点数压缩为4位整数的技术,可将模型体积缩减约75%,同时对输出质量的损失相对有限。「K_M」后缀表示采用了混合精度策略:对模型中更敏感的层保留较高精度,对其余层使用更激进的压缩,是目前在大小与质量之间平衡最好的量化方案之一。Bonsai 采用的1比特量化则走向了极端——每个权重只用一个比特表示,极限压缩换来了极小的体积,但通常以更明显的质量损失为代价。这也是为什么评测特别标注 Bonsai 为例外情况,需要单独审视其实际表现。
速度实测:两个线程反而更快
生成速度的测试结果出现了一些反直觉之处。最快的是参数最小的 Qwen3.5(约8亿参数),接近每秒15个令牌;第二名反而是文件最大的 LFM2.5,超过每秒10个令牌——因为它实际激活的参数很少。MiniCPM5 和 Gemma 系列的2B版本约为每秒7个令牌,Bonsai 和 Granite 略高于阈值,而 Gemma 的4B版本和40亿参数的 Qwen3.5 只有约每秒3.5个令牌,低于每秒5令牌的可用门槛。
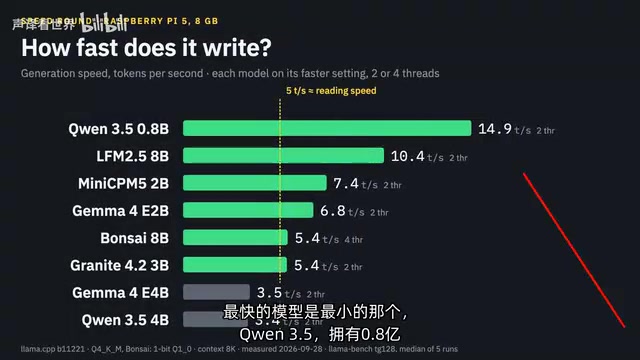
一个意外发现是:这些数字大多是用两个CPU核心而非四个测得的。使用两个线程时,模型生成速度反而快了18%到38%(Bonsai 例外,它需要全部四个核心)。博主判断这是因为树莓派上的生成受限于内存带宽而非CPU算力。实用结论很直接——用两个线程就好。
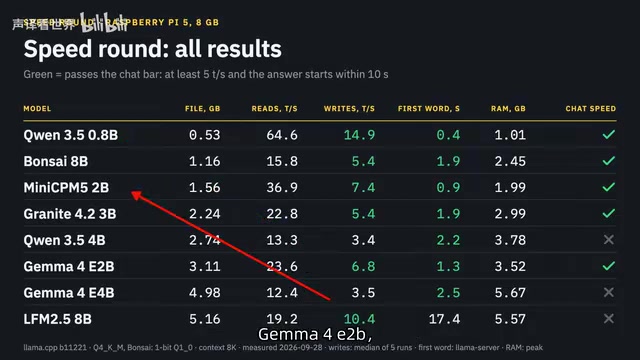
至于响应启动时间,除 LFM2.5 外所有模型都在2.5秒内开始输出。LFM2.5 由于总是先进行推理,第一个词要等到17秒后才出现。综合速度维度,8款中有5款通过聊天门槛,而 Gemma 4B、40亿参数 Qwen3.5 太慢,LFM2.5 则在推理上耗时过多。
内存带宽瓶颈是理解这一反直觉结果的关键。大语言模型在生成阶段(即逐个输出token)时,每生成一个token都需要将整个模型的权重从内存读入CPU缓存,这是一个高度依赖内存读取速度的操作。树莓派5的CPU核心共享同一条内存总线,启用更多核心并不会拓宽这条通道,反而会引入额外的核间协调开销。因此,用两个核心专注地「读内存」,比四个核心竞争同一条带宽效率更高。这一现象在消费级硬件上的本地LLM推理中较为普遍,也是为什么GPU(拥有极高内存带宽)在LLM推理上远胜CPU的根本原因之一。
四项任务:快但不准毫无意义
速度只是入场券。一个给出错误答案的快模型,比给出正确答案的慢模型更糟糕,尤其是在后台任务里。评测用了4项实用任务,没有部分得分——答案要么有用要么没用。
任务一·摘要:把一篇800字文章浓缩成三个要点。这里8款中有4款失败:40亿参数的 Qwen3.5 写出了文章中不存在的内容,LFM2.5 篡改了事实,Bonsai 添加了不存在的信息,MiniCPM5 则漏掉了主要观点。摘要任务成了小模型的重灾区。
任务二·文件分类:把下载文件夹里的20个文件归入6个文件夹,这是家庭服务器的典型活。绝大多数模型都处理得不错,只有8亿参数的 Qwen3.5 丢了8个文件,LFM2.5 思考5分钟后忘了两个文件。
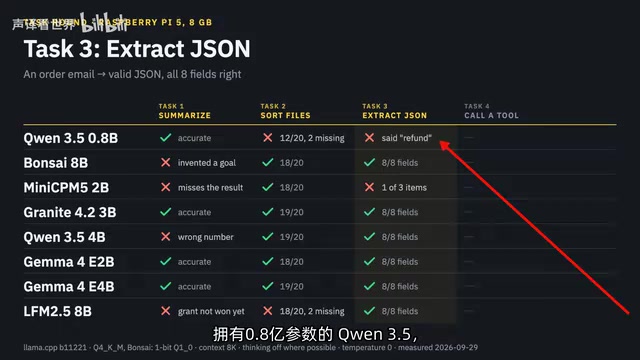
任务三·转JSON:把订单邮件转成有效JSON。意外的是,每个模型都生成了格式有效的JSON,但最小的两款(8亿参数 Qwen3.5 和 MiniCPM5)在内容上出了错。
任务四·工具调用:用一个函数连续移动三个文件。不能调用工具就无法围绕模型搭建智能体。MiniCPM5 在这里失败——它声称在移动文件却什么都没做;LFM2.5 则试图把文件放进一个不存在的文件夹。
值得一提的是,评测刻意没有包含编码测试,因为在这样的速度下,生成一个简单函数都要耗时太久,用这类模型写代码没有实际意义。
**工具调用(Tool Calling / Function Calling)**是指模型能够识别何时需要调用外部函数,并生成格式正确的调用指令,而非仅输出自然语言文本。这是构建AI智能体(Agent)的基础能力:智能体需要让模型像操控工具一样调用文件操作、API请求或数据库查询。如果模型无法可靠地生成合法的函数调用(如 MiniCPM5 那样「声称调用却什么都没做」),则围绕它搭建的任何自动化流程都将不可信赖。对于边缘设备上的本地AI应用场景——如家庭服务器的文件管理、定时任务触发——工具调用能力往往比纯聊天质量更关键。
最终可用名单
通过全部四项任务的只有三款:Granite(30亿参数)、Gemma 2B 和 Gemma 4B。Bonsai 和40亿参数的 Qwen3.5 仅在摘要任务上翻车——它们可以被信任来整理文件,但不能用来写摘要。
综合结论是:
- 聊天 + 后台全能:Gemma 2B 和 30亿参数的 Granite,速度够快且通过全部任务。
- 纯后台任务:Gemma 4B 表现最全面,但对聊天来说太慢。
- 有条件可用:Bonsai 和40亿参数 Qwen3.5,若你不在意摘要质量,可用它们做文件整理和工具调用。
如果只能在树莓派上保留一个模型,博主的选择是 Gemma 2B——它通过了所有测试,又是入围者里最快的。
这份评测的价值不在于某个具体排名,而在于它提供了一套可复用的筛选逻辑:先用速度门槛过滤聊天可用性,再用实用任务检验输出质量,最后区分「聊天场景」和「后台智能体」两类用途。对于想在边缘设备上部署本地AI的玩家来说,这比盲目追求参数规模要靠谱得多。
相关推荐
RAG知识库系统实战:从零搭建企业级私有知识库全流程
手把手教你搭建企业级RAG私有知识库系统,基于Vue 3与Spring AI,涵盖Milvus向量数据库、分块策略、召回率优化、AI幻觉抑制、来源追溯与访问控制等企业级实战难点,附完整Java+AI学习路径。
Coze智能体保姆级教程:零基础搭建AI超级助手全流程
面向零基础人群的Coze(扣子)智能体保姆级教程,涵盖扣子3.0自动与手动搭建、插件调用、多行业实战案例,无需编程即可打造属于自己的AI超级助手。
Hermes Agent实战入门:AI工程化编程全流程指南
Hermes Agent 实战教程指南,涵盖基础入门、整体架构、安装配置、飞书集成、MCP 服务、资讯推送机器人、Python 库集成、自动化博客搭建与代码审查等核心场景,帮助开发者快速掌握 AI 工程化编程。