三阶段速成 Agent 开发:从调模型到造项目的实战路径
三阶段路线把Agent开发还原为工程问题,帮有编程基础的人快速绕开数学门槛入门。
这篇文章梳理了一套面向应用开发者的Agent入门路线,核心主张是:Agent开发本质是工程编排而非数学研究,有后端基础的人迁移成本远低于想象。路线分三阶段递进:第一阶段打通ReAct循环、Tool Calling、MCP协议等核心机制,理解"让模型自主决策调用工具"的范式转变;第二阶段用LangChain和LangGraph搭建工程化体系,配合记忆机制与RAG赋予Agent连续性和知识检索能力,目标是跑通多步推理Demo;第三阶段进入医疗问诊、智能客服等完整链路项目实战,叠加微调与私有化部署。文章同时提示,Demo与生产环境之间差距巨大,"七周成大神"的宣传宜作高效入门地图看待,真实功力仍需大量项目沉淀。
很多人想入门 Agent 开发,第一步却掉进了"从机器学习讲起"的陷阱——一上来就是数学公式、概率统计,仿佛不啃完研究生课程就没资格碰 AI。这条 B 站精选的学习路线给出了截然不同的答案:Agent 开发本质上是工程问题,不是数学问题。它把整个学习过程拆成三个递进阶段,强调用工程思维快速跑通,而不是死磕底层原理。
下面结合原始教程内容,梳理这套三阶段路线的逻辑,并补充一些实操层面的判断。
别再从数学公式开始学
教程开篇就提出一个略显"反常识"的观点:把网上那些东拼西凑、动辄从机器学习原理讲起的课程全部删掉。理由很直接——你的目标是做 Agent 开发,而不是搞学术研究。所谓"不懂数学就做不了 AI"的说法,在应用开发层面并不成立。
这个判断有其合理性。当下的 Agent 开发更接近于"编排"和"调度":你调用现成的大模型 API,设计工具链,管理状态和记忆。这套活儿的核心能力是工程组织,而非从零推导反向传播。对于有后端开发背景的人来说,迁移成本远比想象中低。当然,这不意味着数学毫无价值——如果后续要做模型微调或深入优化,基础理论仍是加分项,只是不该作为入门的门槛。
第一阶段:搞懂 Agent 的核心机制
入门不需要从大模型原理啃起,但必须搞清楚一个关键区别:Agent 和普通的 LLM 调用到底有什么不同。
教程给出了三个"命根子"级别的概念:ReAct 循环、Tool Calling 和 Function Call。这三者构成了 Agent 区别于简单对话的核心机制。
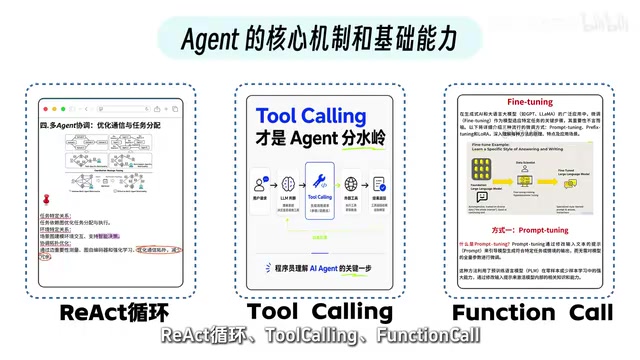
用一个类比来理解:以前写后端,你定义 API 路由,明确规定什么请求走哪个接口;现在做 Agent,你把决策权交给模型——让模型自己判断该调用哪个工具、传什么参数。这是从"人写死逻辑"到"模型自主决策"的思维转变。
在此基础上,再补充 MCP 协议和提示词工程。前者规范了工具与模型之间的交互方式,后者决定了模型能否准确理解意图。这一阶段的目标可以概括为一句话:从"调模型"升级到"让模型自己调工具"。掌握了这一层,你才算真正踏入 Agent 的门。
ReAct 循环(Reasoning + Acting)是 Agent 运作的基本节拍:模型先输出一段"思考"(Thought),据此决定要执行的动作(Action),拿到环境返回的观察结果(Observation)后再进入下一轮思考,如此循环直到任务完成。这个范式最早由谷歌 2022 年的同名论文提出,它让模型不再只是一问一答,而是能在多步推理中动态修正自己的计划。Tool Calling / Function Call 是 ReAct 循环的执行抓手:模型以结构化 JSON 的形式"申报"要调用哪个工具、传什么参数,宿主程序负责实际执行并把结果塞回上下文。理解这个"声明—执行—回填"的三步流程,是读懂任何 Agent 框架代码的前提。MCP(Model Context Protocol) 则是 Anthropic 2024 年底推出的开放协议,目标是统一工具与模型之间的接口规范,类似 USB 对硬件外设的意义——让同一个工具插件能在不同模型、不同框架里通用,而不必为每套系统单独适配。
第二阶段:框架与工程化体系
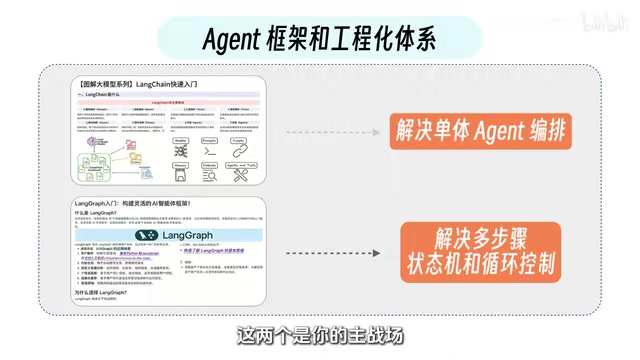
有了基础认知,第二阶段进入真正的主战场——Agent 框架和工程化。
教程点名了两个核心工具:LangChain 负责单体 Agent 的编排,LangGraph 负责多步骤状态机和循环控制。二者分工明确,前者解决"一个 Agent 怎么组织流程",后者解决"多个步骤如何管理状态、如何循环"。对于写过微服务、搞过状态机的开发者,这套工程化思维几乎可以无缝迁移。
框架之外,记忆机制是让 Agent 从"一次性对话"进化到"有连续性"的关键。教程将其拆为两层:短期上下文管理,以及依赖向量库的长期记忆持久化,用于经验回放。再叠加 **RAG(检索增强生成)**做知识注入,Agent 才真正拥有了"记忆"和"知识"两项能力。
这一阶段的产出目标是:能跑通多步推理的 Agent Demo。但教程也直白地提醒——从 Demo 到生产环境,中间还隔着"十万八千里"。这句话点出了很多学习者的误区:能跑起来的 Demo 和能上线的系统完全是两回事。
RAG(Retrieval-Augmented Generation,检索增强生成) 的核心思路是:不把所有知识都塞进提示词,而是在运行时按需检索。具体流程是将文档切片后编码成向量存入向量数据库(如 Chroma、Pinecone、Weaviate),每次对话时把用户查询同样向量化,找到语义最相近的若干片段,再拼入提示词发给模型。这样既绕开了上下文窗口的长度限制,又让 Agent 能随时引用最新的私有知识库,而无需重新训练模型。向量库的选型与分块策略(chunk size、overlap)对检索质量影响显著,是 RAG 工程化中最值得打磨的两个参数。LangChain 内置了完整的 RAG 管道抽象,可以快速跑通原型,但生产环境往往需要针对具体数据结构做定制化改造。
第三阶段:项目实战与私有化部署
第三阶段直接进入项目实战,并叠加微调和私有化部署两个进阶方向。这也是从"会用"到"能落地"的分水岭。
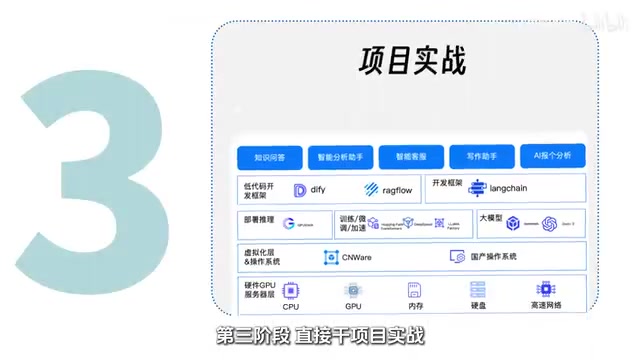
教程推荐了几个真实场景作为练手方向:医疗问诊 Agent、智能客服中台、股票分析助手、数字人交互。这几个场景的共同特点是链路完整、贴近真实业务需求,做完之后"面试讲得出、简历写得上"。
这里有一句话值得记下来:别人看到的是魔法,你看到的是工程。这恰好呼应了整套路线的核心理念——Agent 开发不是玄学,而是一套可拆解、可复现的工程实践。选择有完整业务链路的项目,比堆砌零散功能更能锻炼真实能力,也更容易在求职中形成说服力。
这套路线值不值得跟
整体来看,这条"三阶段"路线的价值在于它的务实:跳过学术化的前置门槛,直接锁定 Agent 开发的核心工程能力,路径清晰、目标明确。对于有编程基础、想快速转型的人来说,确实能少走弯路。
不过也要理性看待所谓"七周从小白到大神"的宣传。七周跑通完整路径是可能的,但要真正达到"大神"水平,尤其是生产级部署和复杂场景优化,仍需要大量项目沉淀。把它当作一份高效的入门地图更合适——它告诉你该学什么、按什么顺序学,但真正的功力还得靠动手死磕出来。
如果你正准备入门 Agent 开发,不妨按这三步走:先吃透 ReAct 与工具调用机制,再上 LangChain/LangGraph 搭工程,最后用完整项目收尾。方向对了,效率自然就上来了。
相关推荐
OpenAI披露模型异常、DeepMind建AGI机构、英伟达联手管电力
9月17日AI行业三大动态:OpenAI公开模型异常披露框架并放出六份报告,Google DeepMind成立AGI公共讨论平台,英伟达联合Google等发起AI电力管理联盟。深度解析AI安全、治理与基础设施三大瓶颈。
Prompt→MCP→Agent→Skill:5分钟搞懂AI术语进化链
一篇科普梳理Prompt、MCP、Agent、Skill、Cowork五大AI核心概念的递进关系。用职场类比讲透AI如何从简单指令进化到多智能体团队协作,帮你彻底告别AI术语焦虑。
10分钟用Python搭建本地AI代理:Ollama+PydanticAI实战
一篇基于B站教程的实操指南,教你用Python、Ollama和PydanticAI在10分钟内搭建完全本地运行的AI代理。涵盖模型选择、连接推理服务器、挂载工具函数和构建对话循环全流程。