少样本提示为何有时反而变差?12模型实验揭示真相
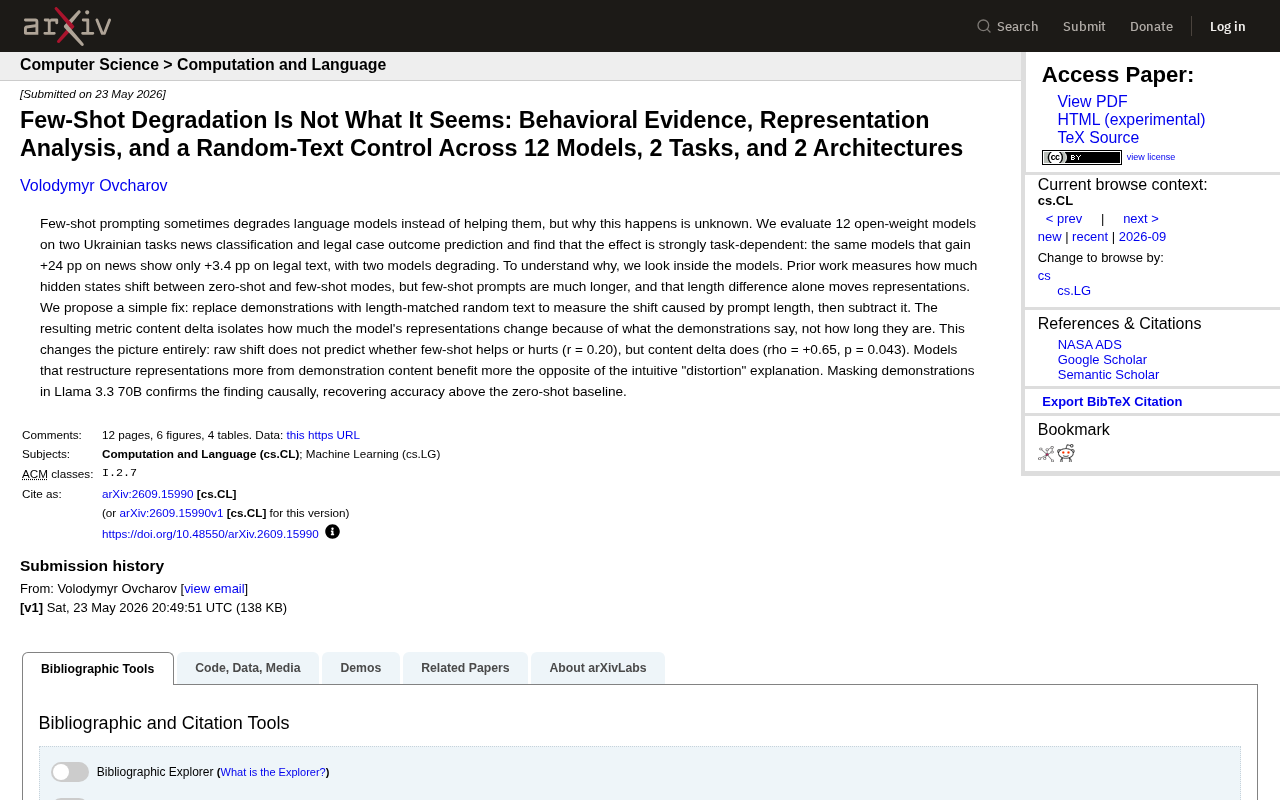
新研究发现少样本提示成效取决于模型对示例内容的表征重构深度,而非提示长度变化。
一篇 arXiv 论文系统研究了少样本提示(few-shot prompting)为何有时反而损害模型表现。研究横跨 12 个开源模型、两类乌克兰语任务,发现少样本效果高度依赖任务性质:新闻分类平均提升 24 个百分点,法律预测仅 3.4 个百分点。更重要的是,论文指出过往用于解释少样本成败的"隐藏状态漂移量"指标存在方法论缺陷——提示长度增加本身就会移动模型表征,使测量结果充满噪声。为此,研究引入长度匹配的随机文本作为对照,分离出仅由示例内容引起的"content delta"。结果颠覆直觉:content delta 越大(即模型对示例内容重构越深)的模型,少样本收益越高,这与流行的"示例扰乱模型"假说恰好相反。Llama 3.3 70B 上的遮蔽实验进一步验证了这一因果关系。
少样本提示的悖论:帮助还是拖累?
在大语言模型(LLM)的实际应用中,少样本提示(few-shot prompting)被视为提升模型表现的常规手段——只需在提示词中给出几个示例,模型往往就能更好地理解任务。但一个长期困扰研究者的现象是:少样本提示有时不仅没有帮助,反而会让模型表现变差。这背后的原因一直是个谜。
一篇新发表的 arXiv 论文(arXiv:2609.15990v1)针对这一问题展开系统研究,横跨 12 个开源权重模型、2 类任务和 2 种架构,试图从行为证据与表征分析两个层面揲开这层迷雾。研究结论颇具颠覆性:少样本效果的好坏,与直觉中的"示例扰乱模型"解释恰恰相反。
少样本提示(few-shot prompting)是一种无需微调、仅通过在上下文中提供输入-输出示例对来引导模型行为的技术。与之对应的是零样本提示(zero-shot prompting),即不提供任何示例、仅靠任务描述让模型作答。少样本提示的理论基础来自于 GPT-3 论文中提出的「上下文学习」(in-context learning,ICL)能力——模型能够从提示窗口内的示例中即时"学习"任务模式,而不更新任何权重。这种能力被认为是大模型涌现出的关键特性之一,但其内部机制至今尚无定论:模型究竟是在执行真正的归纳学习、还是仅在检索训练时见过的相似模式,学界仍有争议。正因如此,少样本的失效场景——示例反而使模型表现下降——也缺乏令人信服的机制解释,本研究正是试图填补这一空白。
效果高度依赖任务本身
研究团队在两个乌克兰语任务上评测了 12 个模型:新闻分类与法律案件结果预测。结果显示,少样本提示的效果呈现出强烈的任务依赖性。
在新闻分类任务上,同一批模型平均获得了 +24 个百分点 的显著提升;但切换到法律文本任务时,提升幅度骤降至仅 +3.4 个百分点,其中甚至有两个模型的表现出现了退化。
这说明,笼统地讨论"少样本是否有用"意义不大——任务的性质才是决定示例能否发挥作用的关键变量。对于结构化程度高、模式清晰的分类任务,示例的引导价值明显;而对于推理链条更长、语境更复杂的法律预测任务,示例的边际收益要小得多。
长度陷阱:过往表征分析的盲点
为了搞清楚模型内部到底发生了什么,研究者深入模型的隐藏状态(hidden states)进行分析。此前的研究常用的方法是测量隐藏状态在零样本模式和少样本模式之间的"漂移量"(shift),并试图用漂移量解释少样本的成败。
但这里存在一个被忽视的方法论缺陷:少样本提示词本身要长得多,而单纯的长度差异就足以移动模型的表征。换句话说,过去测到的"漂移"里,混杂着大量由提示长度增加带来的、与示例内容无关的噪声。这使得基于原始漂移量的分析很可能得出误导性结论。
隐藏状态(hidden states)是 Transformer 架构中每一层对输入 token 序列进行编码后产出的向量表示,可以理解为模型在处理输入时的"内部语义快照"。研究者通常会提取最后几层的隐藏状态,对其做聚合(如平均池化)后得到整个提示词的表征向量,再通过计算两个向量之间的余弦距离或 L2 距离来量化"漂移"。这种分析范式被广泛用于可解释性(interpretability)研究,目的是在行为指标(准确率)之外,从模型内部寻找可解释的信号。然而该方法的一个固有弱点在于:模型的隐藏状态对输入序列的整体统计特性——包括长度、词汇分布等——极为敏感,这使得任何未经长度控制的漂移量测量都难以将"内容影响"与"长度影响"区分开来。
随机文本对照:分离出"内容"的真实影响
论文提出了一个简洁而巧妙的修正方法:用长度匹配的随机文本替换真实示例,以此测量纯粹由提示长度引起的表征漂移,再从总漂移中减去这部分。
经过这一处理后得到的指标被称为 content delta(内容增量),它精确地隔离出了模型表征因"示例说了什么"而发生的改变,而非因"示例有多长"而产生的位移。这一随机文本对照设计,是整篇研究方法论上的核心亮点。
结果彻底改写了此前的图景:
- 原始漂移量无法预测少样本的成败(相关系数 r = 0.20,基本无相关性);
- content delta 却能有效预测(斯皮尔曼相关 rho = +0.65,p = 0.043,统计显著)。
颠覆直觉的结论:重构越多,收益越大
最耐人寻味的发现在于方向。数据表明,那些根据示例内容更大幅度地重构自身表征的模型,反而从少样本中获益更多。
这与流行的"扰乱"(distortion)假说完全相反。此前不少人认为,示例可能会"污染"或"扭曲"模型原有的表征,从而导致性能下降。但本研究显示,真正有价值的少样本学习恰恰体现为模型愿意并且能够根据示例内容进行深度的表征重组——重组得越充分,效果越好。
为了验证这一发现是否具有因果性,研究团队在 Llama 3.3 70B 上进行了示例遮蔽(masking)实验。当遮蔽掉示例内容后,模型准确率回落——而恢复示例后,准确率重新超过零样本基线。这一因果实验进一步坐实了 content delta 与性能之间的关系并非偶然相关。
「扰乱假说」(distortion hypothesis)的直觉来源有一定合理性:在少样本场景中,如果示例与测试样本的分布存在偏差,或者示例标签本身携带了噪声,模型可能会过度适应示例的表面特征,反而偏离了对测试输入的正确表征。早期有研究发现,即使使用随机错误标签的示例,少样本的表现有时也不比正确标签差太多,这被解读为模型对示例内容并不真正"理解",而是受到了格式或上下文结构的引导。本研究的发现提供了另一个视角:真正意义上的表征重构(而非单纯的格式适配)才是少样本成功的关键信号,这要求模型不仅要感知到示例的存在,还要让示例内容切实改变其对任务语义空间的内部组织方式。
对提示工程的实际启示
这项研究虽然以乌克兰语任务为实验对象,但其方法论与结论对通用的提示工程实践具有参考价值:
第一,评估少样本是否有效时,不应只看提示是否"改变了"模型状态,而要区分改变来自内容还是来自长度。长度匹配的随机文本对照,为未来的表征分析提供了一个可复用的干净基线。
第二,少样本失效未必意味着"示例干扰了模型",也可能是模型根本没有对示例内容产生足够的表征重构。这提示实践者在少样本效果不佳时,可以尝试更具信息量、更贴合任务模式的示例,而非简单归咎于"少样本有害"。
第三,任务类型的先验判断很重要。对于法律推理这类复杂任务,与其堆砌示例,不如考虑其他增强手段。
总体来看,这篇论文以严谨的对照实验,把"少样本退化"从一个模糊的经验现象,推进到了可量化、可解释、可因果验证的层面。
相关推荐
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。