双卡RTX4090跑通Qwen3-Next:8并发满血长上下文实测
双卡RTX 4090通过KV热缓存卸载,将QSA长上下文推理的显存需求压缩约84%,实现8路256K请求的可用服务。
本文记录了一次将HiSparse KV卸载思路移植到Qwen3-Next稀疏注意力结构(QSA)的工程实践,目标是用两张RTX 4090(各48GB显存)承载8路约256K Token的长上下文推理。移植的核心收益是显存容量:将完整KV历史卸载到主机内存、显存只保留热缓存,使8路长上下文的KV显存需求减少约84%。由于QSA的C4块结构与12层独立吸收层,无法直接复用跨层共享索引的预取逻辑,项目重构了索引、量化尺度和页表布局,并补齐了请求回收机制(租约、代际标记、环形缓冲)。速度方面的提升来自Flash Attention快路径,与卸载本身无关。作者通过真实终端记录和多代理编码任务验证了服务可用性,并反复强调三类收益——容量、速度、代理体验——各有独立证据,不可混淆叠加。
一次针对显存瓶颈的工程移植
用两张显存各48GB的RTX 4090,跑完8条接近256K的长上下文请求——这是本次项目要验证的核心命题。它的做法是把类似HiSparse的KV卸载思路移植到QSA(Qwen3-Next使用的稀疏注意力结构),让完整历史留在主机内存,显存只保留热数据。
这类优化的直接价值,在于把受显存限制的长上下文推理,变成一个能真正跑起来、能回收、能承接多请求的可用服务。而不是仅仅在演示中把一次解码勉强跑通。
值得强调的是,UP主在原始素材中反复给出了克制的口径:容量、快路径、代理体验各有独立证据,但不能混为一谈,更不能把它们拼凑成"四倍加速"这样的夸张结论。这种自我约束,反而让这次实测的可信度更高。
QSA(Qwen3稀疏注意力)是Qwen3-Next模型采用的注意力变体,核心思想是并非所有Token对当前生成都同等重要,模型可以选择性地只关注其中一部分,从而降低长序列下的计算量。其中C4块指每4个相邻Token被组织为一个计算单元,注意力选择在块级别进行而非Token级别,以平衡稀疏性与实现复杂度。"吸收层"(sink layers)是指模型中对注意力模式起锚定作用的特定层,通常倾向于关注序列开头的Token;QSA中12个吸收层各自独立维护自己的选择策略,这与普通多层Transformer共享同一套KV索引的假设不兼容,因此HiSparse中基于跨层共享索引的预取逻辑无法直接复用,需要逐层独立管理索引和缓存槽位的对应关系。
显存账本:热缓存卸载省下约84%
先看省下了什么。按每张卡计算,一条满上下文的原始KV约为1.5GB量级,8条即约12GB。移植后,8路热缓存约396MB,加上共享暂存区约1.5GB,合计约1.89GB。这部分的显存需求减少约84%,为多路长上下文腾出了空间。
需要澄清的是,这不是整卡用量。权重、索引和GDN状态仍然常驻在显卡上,卸载的只是KV缓存里的"冷"部分。完整历史保存在固定的主机内存中,缺失的块按需搬回显卡。
工程上真正的难点在于QSA的结构特性:每4个原始Token组成一个块(C4块),12个吸收层各自独立选择,因此不能直接照搬跨层共享索引的预取逻辑。项目为此重新对齐了原始KV索引、量化尺度和页表布局,并把逻辑Token地址与物理缓存槽位分开管理。
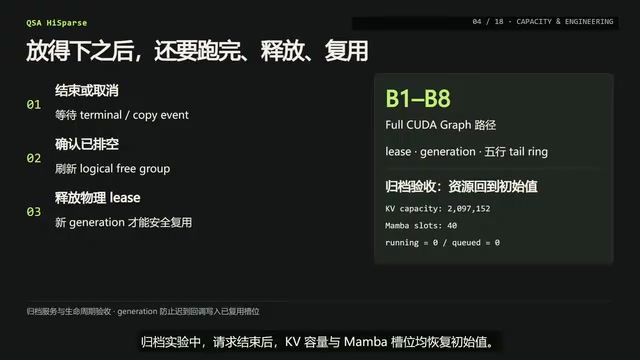
此外,一个能上线的服务不能只跑通一次解码。请求要能结束、取消,并让新请求安全复用缓存。项目补齐了租约、代际标记和尾部环形缓冲,并覆盖了一道8路完整CUDA Graph归档。实验显示,请求结束后KV容量和缓存槽位都回到初始值——回收机制确实生效。
KV缓存(Key-Value Cache)是Transformer推理中存储注意力机制中间结果的核心数据结构。每个Token在每一层都会生成对应的Key和Value向量,用于后续Token生成时的注意力计算。上下文越长,这部分数据量越大——256K Token的KV缓存可轻易占满消费级显卡的全部显存。"冷热分离"的卸载策略基于一个观察:注意力计算并非均匀地依赖所有历史Token,近期Token(热数据)被频繁访问,而远期Token(冷数据)访问概率低。因此可以只在显存中保留近期的热缓存,将完整历史卸载到容量更大的主机内存(CPU RAM),需要时再按需搬回显卡。这种做法以PCIe传输延迟换取显存容量,适合对延迟要求不极致但需要超长上下文的推理场景。HiSparse是这一思路的先行实现,本项目则是将其适配到QSA结构的移植工作。
速度收益:来自快路径,而非卸载本身
容量是主要收益,但速度也有独立的优化证据,只是要分清来源。在同配置对比中,38K单请求的吞吐从每秒69.38个Token提高到86.07个,约4K的8路总吞吐从每秒400.16提高到464.15。
作者明确指出:这部分收益来自Flash Attention快路径的优化,不代表把KV搬到内存本身会更快,也不是长上下文那组压测的数据。这种把不同实验的功劳分开归属的做法,是评估这类项目时最容易被忽略、却最关键的一环。
至于长上下文归档实验:8条请求各输入约261000+个Token、都完成了约1022个输出,共同解码窗口的总吞吐为每秒214.85个Token,每请求约26.86。但这个窗口只有约2.28秒,且预填充是串行或交错的,不能当成"8路始终并行"。相关修复后尚未重跑整轮,因此这里保留了原实验口径——这是一处诚实的免责声明。
Flash Attention是一种重新组织注意力计算顺序、减少GPU显存读写次数的算法实现。标准注意力计算需要将大型中间矩阵(Q×K的得分矩阵)完整写入显存再读回,而Flash Attention通过分块计算(tiling)在片上SRAM中完成大部分运算,大幅减少了显存带宽消耗。"快路径"通常指在特定条件满足时(如序列长度、头维度符合优化内核的预期参数范围)走高度优化的内核分支,否则退回到通用但较慢的实现。本项目的速度提升正是因为修改触发了这条快路径,与KV卸载本身无关——KV卸载因涉及PCIe数据搬运,理论上只会增加延迟而非降低。将两个来源不同的收益混为一谈,是这类优化项目中最常见的结论夸大方式,作者在此明确拆分归因,具有较高的方法论诚意。
真实终端记录:接口可用性验证
为了避免"演示造假"的质疑,作者留下了制作过程中通过SSH记录的真实终端输出。
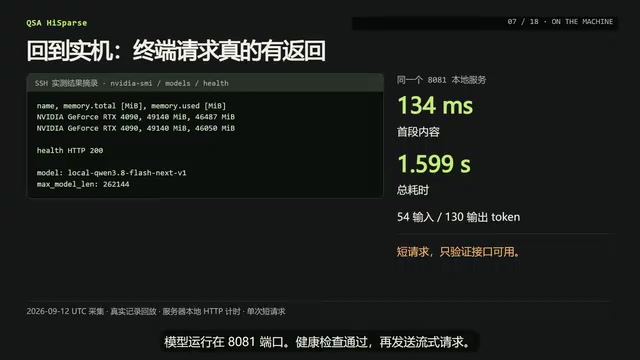
模型在本地端口通过健康检查后,发送一条流式请求:服务器本地计时显示首段内容134毫秒,总耗时约1.6秒,输出130个Token。这条短请求只用于验证接口可用,作者特别声明它"不冒充256K性能测试"。
随后是一个更完整的编码任务:在隔离目录里实现一个Python流式响应解析器,要求拼接文本、保留最后一次Usage并在结束标记处停止。日志显示模型先读任务和样例,再写代码,并主动改掉了一处冗余分支,接着写测试、执行命令,14项自测一次通过。真实任务总用时约49.94秒,独立复跑14项测试加4项额外检查全部通过,没有任何手工修改。
体验上,这次是Headless模式,直到最后才显示文字反馈,中间有明显的等待感。作者同样强调:这只是单一小任务的证据,不代表大型仓库的可靠性,更不是长上下文加速的证明。
网页与多代理任务:能交付,但别过度解读
通过SSH转发到本机的网页应用,跑了几道经典题。
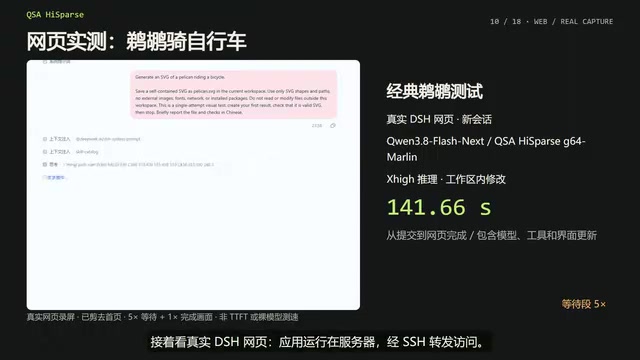
第一题生成一只"骑自行车的鸟"的SVG,从提交到完成约2分22秒(画面5倍速播放)。第一次生成的原始画面保留未修图——鸟和自行车能认出来,但头盔更像眼罩。网页预览曾因相对路径报错,输入绝对路径后正常,问题也如实保留。
第二题是括号匹配,模型写出实现和测试,但把空字符串的预期结果写错,运行失败后自行纠正,总用时约1分26秒。验收时12个自带测试复跑通过,额外检查覆盖长度0到6的所有括号组合,加中文命令行和长输入,总共56008项通过。
最后是多代理场景:一次启动4个任务(括号匹配、拓扑排序、缓存、区间合并),先全部启动再接收完成通知,有真实的重叠等待。
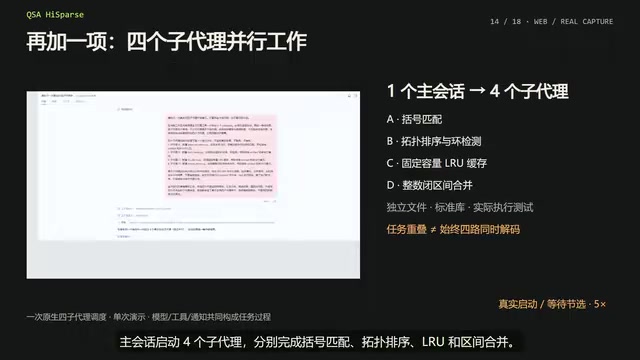
各任务结束后的统计显示:输出速度约每秒49–52个Token,首Token平均5.7–10.1秒不等。4份程序的47项自带测试独立复跑全部通过,其中缓存和区间合并都曾修正测试断言。
作者在此再次划清界限:这些速度不能相加,不能说成"四路始终同时解码",更不能据此声称四倍加速。这里验证的只是——多代理任务可以被交付。
这次移植的真正价值
把这几组实验合起来看,这个项目的意义清晰而克制:让受显存限制的QSA长上下文推理,从"勉强跑通"变成一个"能完成、能回收、能承接多请求"的服务。
- 容量收益来自热缓存卸载(约省84%显存);
- 速度收益来自Flash Attention快路径;
- 代理体验来自真实的多任务交付记录。
三者各有证据、互不冒充。代码、补丁和实验记录都在项目里。对于手握消费级显卡、又想跑长上下文和多代理服务的开发者,这是一份诚实且有参考价值的工程实践。
相关推荐
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。